Zum Inhalt springen
Zurück zum Blog

Web-Scraping für die Marktforschung: Ein Leitfaden für Entwickler

Sergiu InizianZuletzt aktualisiert am 14 min read
Web-Scraping für die Marktforschung: Ein Leitfaden für Entwickler
TL;DR: Durch Web-Scraping lassen sich öffentliche Produktseiten in wiederholbare Beobachtungen zu Preisen, Sortiment und Verfügbarkeit umwandeln. Für eine aussagekräftige Marktforschung sind eine definierte Stichprobe, vergleichbare Produkte, Zeitstempel und Qualitätsprüfungen erforderlich; die gescrapten Einträge allein geben keinen Aufschluss über Umsatz, Nachfrage oder Marktanteile.

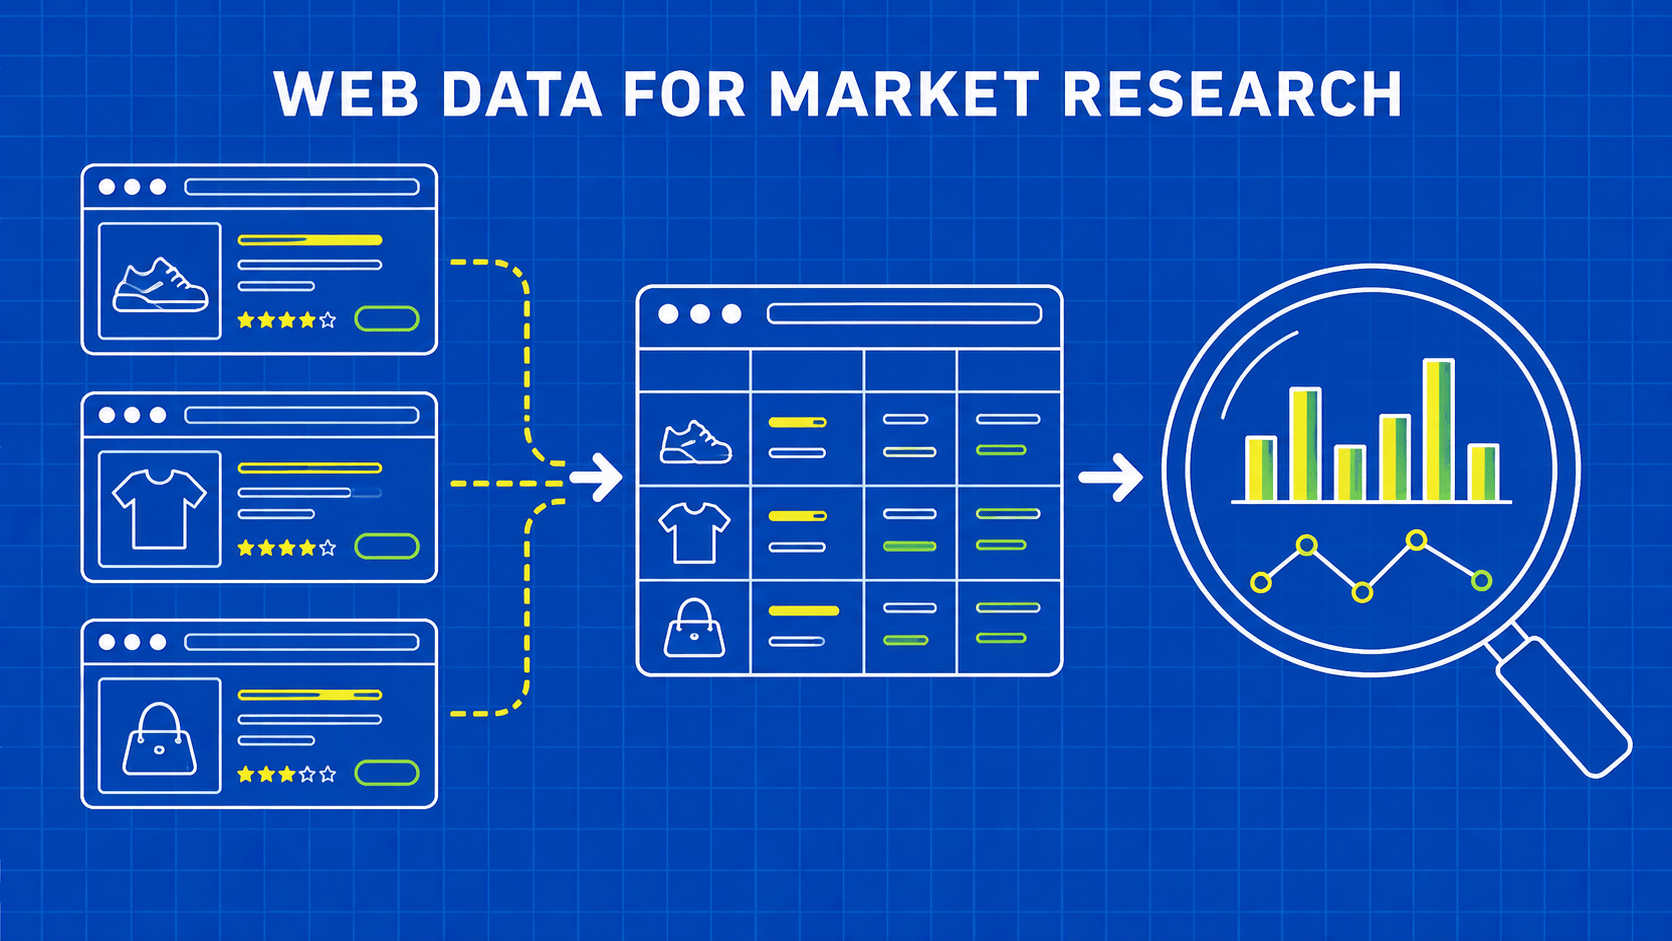
Web-Scraping für die Marktforschung ist die automatisierte Erfassung von Website-Daten, um eine definierte Frage zu einem Markt oder seinen Akteuren zu beantworten. Für Entwickler ist das Ergebnis ein Datensatz mit nachvollziehbaren Beobachtungen und klaren Grenzen, nicht einfach nur eine große Sammlung von Seiten.

Stellen Sie sich einen Einzelhändler vor, der seine Preise mit öffentlichen Angeboten der Konkurrenz vergleicht. Ein Dashboard könnte anzeigen, dass der Durchschnittspreis eines anderen Einzelhändlers in dieser Woche gesunken ist. Das könnte auf echte Preissenkungen, neu gelistete günstigere Produkte, fehlende teure Produkte oder einen Parser zurückzuführen sein, der nun auch Ratenzahlungspreise erfasst. Jede Erklärung führt zu einer anderen geschäftlichen Entscheidung.

Zuverlässige Forschung trennt diese Möglichkeiten voneinander, bevor ein Trend dargestellt wird. Man muss wissen, was die Stichprobe abdeckt, wofür jeder Datensatz steht und welche Unterschiede als vergleichbar gelten. Eine Produktseite ist ein Hinweis auf ein beworbenes Angebot unter bestimmten Bedingungen, kein Beweis für eine abgeschlossene Transaktion.

Dieser Leitfaden konzentriert sich auf die Produkt- und Preisrecherche bei Wettbewerbern, da hier die Messprobleme besonders deutlich zutage treten. Sie werden die Forschungsfrage definieren, ein Beobachtungsschema entwerfen, Preise ohne Kontextverlust normalisieren und die Datenerhebung validieren, bevor Sie Ergebnisse präsentieren. Die gleiche Vorgehensweise gilt für Dienstleistungsverzeichnisse, Stellenanzeigen und andere öffentliche Marktsignale.

Beginnen Sie das Web-Scraping für die Marktforschung mit einer beantwortbaren Frage

„Wettbewerber beobachten“ ist zu weit gefasst, um daraus eine Extraktionsspezifikation zu machen. Ersetzen Sie dies durch eine Frage wie: „Wie verhalten sich die beworbenen Lieferpreise für vergleichbare Produkte bei diesen Händlern für diesen Bestimmungsort im Vergleich?“ Dieser Satz identifiziert die Entitäten, die Kennzahl und wichtige Bedingungen, bevor Sie eine Scraping-Bibliothek auswählen.

Trennen Sie in den Anforderungen Beobachtungen von Interpretationen. Sie können einen angezeigten Preis, ein gelistetes Produkt oder eine Verfügbarkeitsmeldung beobachten. Sie können diese Beobachtungen nutzen, um eine Veränderung im Wettbewerb zu untersuchen, doch für fundiertere Aussagen sind zusätzliche Belege erforderlich. Dass ein Produkt von einer Seite verschwindet, reicht nicht aus, um zu schließen, dass es ausverkauft oder aus dem Sortiment genommen wurde.

Forschungsfrage

Nützliche beobachtete Felder

Was diese Felder nicht belegen

Wie unterscheiden sich vergleichbare Angebote?

Produktidentität, Preis, Währung, Versandbedingungen

Tatsächlicher Transaktionspreis für jeden Kunden

Welche Kategorien werden aufgeführt?

Produkt-IDs, Kategorien, Verkäufer, Beobachtungszeitraum

Absatzvolumen oder Marktanteil

Wie ändert sich die Verfügbarkeit?

Verfügbarkeitstext und Status der erfolgreichen Beobachtung

Verkaufte Einheiten oder Lagerbestand

Wie ändern sich Werbeaktionen?

Öffentlicher Werbetext, Teilnahmebedingungen, Gültigkeitszeiträume

Wirksamkeit der Werbeaktion oder Kundenresonanz

Wie entwickelt sich das Sortiment?

Erstes und letztes Beobachtungsdatum, Produktmerkmale

Endgültige Einführungs- oder Auslaufdaten

Dies ist nicht nur eine vorsichtige Formulierung. Das britische Amt für nationale Statistik hat eine wesentliche Einschränkung der aus dem Internet gewonnenen Preisdaten dokumentiert: Die angegebenen Preise liefern nicht die gekauften Mengen, die für die Gewichtung der Ausgaben erforderlich sind. Seine Untersuchung aus dem Jahr 2017 zu aus dem Internet gewonnenen Preisdaten dient als methodischer Hintergrund und stellt keine Aussage über den heutigen Einzelhandelsmarkt dar.

Schreiben Sie die beabsichtigte Entscheidung neben die Frage. Ein Merchandising-Team, das das Sortiment vergleicht, benötigt einen anderen Datensatz als ein Analyst, der Preisänderungen misst. Vermeiden Sie das Erfassen zusätzlicher Felder, da diese leicht zu scrapen sind, wenn niemand erklären kann, wie sie die Entscheidung unterstützen.

Entwerfen Sie eine Stichprobe, die ihre blinden Flecken aufzeigt

Ihre Quellenliste definiert den Markt, den Sie tatsächlich beobachten können. Ein vollständiges Crawling von drei Websites ist immer noch nur eine Stichprobe des Gesamtmarktes. Es schließt andere Einzelhändler, Offline-Transaktionen und Angebote aus, die hinter Bedingungen verborgen sind, die außerhalb Ihres Erfassungsumfangs liegen. Mehr Seiten aus denselben Quellen können diese Lücken nicht schließen.

Erstellen Sie vor der Datenerhebung ein Quellenverzeichnis. Halten Sie die ausgewählten Händler oder Plattformen, die geografische Region, die Kategorien, die Zugriffsmethode, den Verantwortlichen für die Überprüfung sowie die Gründe für die Einbeziehung fest. Unterscheiden Sie bewusst ausgeschlossene Quellen von Quellen, bei denen technische Probleme auftraten. Andernfalls kann ein Ausfall der Pipeline unbemerkt den untersuchten Markt verändern.

Trennen Sie die Abdeckung vom Erfolg der Datenextraktion

Messen Sie die Abdeckung nach Möglichkeit anhand eines expliziten Rahmens: der Liste der zugelassenen Händler, bekannter Kategorie-URLs oder eines Referenzproduktpanels. Eine erfolgreiche Antwortrate misst das Abrufen, nicht die Abdeckung. Der Crawler könnte zwar jede angeforderte URL abrufen, aber dennoch eine ganze Kategorie übersehen, weil sich ein Navigationslink geändert hat.

Erfassen Sie entdeckte Produkte, angeforderte Seiten, erfolgreiche Beobachtungen und gültige Datensätze separat. Halten Sie den Grund für jeden Verlust fest. Ein nicht verfügbares Produkt, ein fehlender Preis, eine fehlgeschlagene Anfrage und eine nicht übereinstimmende Kennung sollten nicht alle in einer leeren Zeile zusammengefasst werden. Diese Unterscheidungen sind entscheidend, wenn es darum geht, Veränderungen in der endgültigen Stichprobe zu erklären.

Wenn Sie die vollständige Abdeckung nicht abschätzen können, geben Sie an, was Sie wissen. „Beobachtete Angebote von ausgewählten öffentlichen Kategorieseiten“ ist eine vertretbare Beschreibung. „Der gesamte Markt“ ist es nicht. Dokumentieren Sie die Erkennungsregeln, damit ein anderer Entwickler die Grenzen des Datensatzes nachvollziehen kann.

Verwenden Sie ein stabiles Panel und einen Erfassungsstrom

Ein praktisches Design sieht vor, ein festes Produktpanel für Vergleiche beizubehalten und gleichzeitig separate Erfassungsaufträge für neue Einträge auszuführen. Das Panel hilft dabei, ähnliche Artikel im Zeitverlauf zu vergleichen; die Erfassung deckt Sortimentsänderungen auf, die dem Panel sonst entgehen würden. Veröffentlichen Sie deren Zahlen separat, da sie unterschiedliche Fragen beantworten.

Überprüfen Sie das Panel regelmäßig, anstatt fehlende Produkte stillschweigend zu ersetzen. Produktfluktuation kann eine Preisserie verändern, selbst wenn einzelne Preise korrekt erfasst werden. ONS hat dieses Problem in einer Untersuchung zu aus dem Internet gesammelten Bekleidungsdaten untersucht. Die technische Konsequenz besteht darin, Ein- und Ausstiegsentscheidungen sowie Zuordnungsentscheidungen zusammen mit den Beobachtungen zu dokumentieren.

Speichern Sie Angebote als mit einem Zeitstempel versehene Beobachtungen

Verwenden Sie separate Konzepte für ein Produkt, ein Angebot und eine Beobachtung. Das Produkt ist der Artikel, der verkauft wird. Das Angebot umfasst den Verkäufer und die Geschäftsbedingungen. Die Beobachtung hält fest, was Ihr Datenerfasser zu einem bestimmten Zeitpunkt und in einem bestimmten Kontext erfasst hat.

Schema.org „Product“ und Schema.org „Offer“ bieten ein nützliches Vokabular für diese Trennung, einschließlich Produktkennungen und Angebotsmerkmale wie Preis, Währung und Verfügbarkeit. Strukturierte Daten von Websites können eine praktische Quelle für die Datenextraktion sein, aber gehen Sie nicht davon aus, dass sie mit den sichtbaren Inhalten übereinstimmen oder die ausgewählte Variante korrekt identifizieren. Überprüfen Sie repräsentative Seiten, bevor Sie sich darauf verlassen.

Feldgruppe

Empfohlene Felder

Warum dies wichtig ist

Herkunft

Quell-URL, Beobachtungszeitpunkt, Lauf-ID, Parser-Version

Eine Beobachtung reproduzieren und überprüfen

Produktidentität

Quellprodukt-ID, GTIN (sofern angegeben), Marke, Modell, Variante

Gleiches mit Gleichem abgleichen

Angebotskontext

Verkäufer, Region, Währung, Zustand, Teilnahmeberechtigung

Vergleich nicht kompatibler Angebote vermeiden

Preisgrundlage

Angegebener Betrag, Versandkosten oder -status, Steuerbasis

Erläutern Sie, was im Preis enthalten ist

Ergebnis der Datenerfassung

Abrufstatus, Extraktionsstatus, Gründe für fehlende Felder

Unterscheiden Sie unbekannte Werte von tatsächlichen Änderungen

Behalten Sie den ursprünglichen Feldtext neben den normalisierten Werten bei, sofern Ihre genehmigte Aufbewahrungsrichtlinie dies zulässt. „Ab 19,99“, „19,99 pro Monat“ und „19,99“ können auf denselben Zahlenwert normiert werden, obwohl sie unterschiedliche Angebote beschreiben. Das Beibehalten der ursprünglichen Nachweise hilft dabei, diesen Fehler zu untersuchen, ohne davon auszugehen, dass die Seite später noch genauso aussieht.

Verwenden Sie zeitzonenbezogene Zeitstempel für Beobachtungen und legen Sie fest, wie ein Berichtszeitraum zugeordnet wird. Ein Preis, der in einer Region kurz vor Mitternacht und in einer anderen Region nach Mitternacht erfasst wurde, kann in unterschiedliche Tageszusammenfassungen aufgenommen werden. Behalten Sie den tatsächlichen Erfassungszeitpunkt bei, auch wenn das Dashboard lokale Datumsangaben anzeigt.

Behandeln Sie Korrekturen als nachvollziehbare Änderungen. Wenn ein Parser Versandkosten in das Preisfeld zugeordnet hat, sollte ein korrigierter Datensatz die betroffenen Durchläufe und die Transformationsversion aufzeichnen. Das stillschweigende Überschreiben historischer Beobachtungen erschwert es, zu erklären, warum sich das letzte Woche veröffentlichte Diagramm geändert hat.

Gleichen Sie Produkte ab, bevor Sie deren Preise vergleichen

Ein passender Titel reicht nicht aus, um die Gleichwertigkeit von Produkten festzustellen. Vergleichen Sie Modell, Variante, Packungsgröße, Zustand und Verkäuferkontext, bevor Sie zwei Angebote als Alternativen behandeln. Ein generalüberholtes Gerät, ein neues Gerät und eine Mehrfachpackung können zwar die meisten sichtbaren Begriffe gemeinsam haben, stellen jedoch unterschiedliche Käufe dar.

Verwenden Sie vertrauenswürdige Identifikatoren, sofern diese verfügbar sind. GS1 beschreibt GTINs in seiner Erläuterung zu GTINs und Barcodes als Produktidentitätsschlüssel. Speichern Sie Identifikatoren als Zeichenfolgen, einschließlich führender Nullen, und überprüfen Sie, ob die Website den Identifikator der entsprechenden Variante zuordnet. Das Vorhandensein eines Identifikators entbindet Sie nicht von der Notwendigkeit, die extrahierte Zuordnung zu validieren.

Wenn Identifikatoren fehlen, wenden Sie einen stufenweisen Abgleichprozess an. Normalisieren Sie offensichtliche Formatierungsunterschiede, schränken Sie die Kandidaten nach Marke und Kategorie ein und vergleichen Sie anschließend Modell- und Variantenattribute. Speichern Sie einen Abgleichstatus wie „bestätigt“, „vorläufig“ oder „abgelehnt“. Leiten Sie unsichere Übereinstimmungen zur Überprüfung weiter, anstatt eine unscharfe Ähnlichkeitsbewertung stillschweigend in eine faktische Äquivalenz umzuwandeln.

Einheiten und Handelsbedingungen normalisieren

Einheitspreise können Verpackungsgrößen vergleichbar machen, jedoch erst, nachdem Sie festgestellt haben, dass die Einheit dasselbe bedeutet. Der Vergleich des Preises pro Kilogramm kann für gleichwertige verpackte Waren nützlich sein. Er macht Produkte jedoch nicht identisch, wenn sich Konzentration, Qualität oder mitgeliefertes Zubehör unterscheiden. Behalten Sie die ursprünglichen Verpackungsinformationen bei, damit Analysten den geeigneten Vergleich wählen können.

Fassen Sie Währungen nicht in einer einzigen numerischen Spalte zusammen und berechnen Sie keinen Durchschnitt. Behalten Sie die ursprünglichen Währungen bei und halten Sie, falls eine Umrechnung erforderlich ist, die Quelle des Wechselkurses, den Zeitstempel und die Umrechnungsrichtlinie fest. Der umgerechnete Betrag ist eine abgeleitete Größe und nicht die ursprüngliche Beobachtung.

Versandkosten, Steuern, Mitgliedschaftsgebühren und Mindestbestellwerte müssen ebenso explizit behandelt werden. Unbekannte Versandkosten bedeuten nicht, dass der Versand kostenlos ist. Ein Preis nur für Mitglieder ist kein öffentlicher Preis für jeden Kunden. Vergleichen Sie entweder ein gemeinsames, berechtigte Szenario oder trennen Sie die Kohorten, damit das Dashboard ungleiche Angebote nicht als direkte Substitute einstuft.

Überprüfen Sie vergleichbare Summen mit einer kleinen Python-Funktion

Führen Sie Vergleichbarkeitsprüfungen vor der Aggregation durch. Das folgende Beispiel aus der Standardbibliothek akzeptiert bereits extrahierte Felder und berechnet eine gelieferte Gesamtsumme nur dann, wenn beide Angebote dasselbe Produkt und dieselbe kommerzielle Grundlage haben. Es lehnt bewusst unbekannte Versandkosten ab, anstatt sie als Null zu behandeln.

Dies ist ein illustrativer Validierungsschritt, kein universeller Produktabgleicher oder Live-Scraper. Die Eingaben setzen voraus, dass Sie die Identität bereits geklärt, das relevante Angebot ausgewählt und numerischen Text normalisiert haben. Verwenden Sie Ihre quellspezifischen Regeln für die Währungsvalidierung, die steuerliche Behandlung und die Berechtigung.

from decimal import Decimal, InvalidOperation

def amount(value):
    if not isinstance(value, str):
        raise ValueError("Amounts must be normalized decimal strings")
    try:
        parsed = Decimal(value)
    except InvalidOperation as exc:
        raise ValueError("Invalid amount") from exc
    if not parsed.is_finite() or parsed < 0:
        raise ValueError("Amount must be finite and nonnegative")
    return parsed

def delivered_total(offer, expected_basis):
    for field, expected in expected_basis.items():
        if offer.get(field) != expected:
            raise ValueError(f"Incomparable field: {field}")
    if offer.get("shipping_status") != "known":
        raise ValueError("Shipping is unknown")
    return amount(offer.get("price")) + amount(offer.get("shipping"))

basis = {
    "matched_product_id": "widget-blue-small-single",
    "currency": "EUR",
    "condition": "new",
    "tax_basis": "included",
    "destination": "DE",
    "eligibility": "public",
}
offer = {
    **basis,
    "price": "24.90",
    "shipping": "3.50",
    "shipping_status": "known",
}
print(delivered_total(offer, basis))  # 28.40

Die Python-Dokumentation zu Dezimalzahlen erläutert die Dezimalarithmetik und erklärt, warum sich die Konstruktion von Dezimalzahlen aus Zeichenketten von der Konstruktion aus binären Gleitkommawerten unterscheidet. Die Eingabe als Zeichenkette ist hier beabsichtigt. Die Funktion lehnt zudem unendliche Werte ab, da ein Wert wie NaN nicht in einen Preisbericht gelangen sollte.

Erweitern Sie die Testfälle, bevor Sie diesen Schritt mit Produktionsdaten verknüpfen. Berücksichtigen Sie dabei unbekannte Versandkosten, nicht übereinstimmende Währungen, negative Beträge, nicht verfügbare Angebote und doppelte Einträge. Speichern Sie abgelehnte Datensätze zusammen mit dem Grund dafür in einem Überprüfungs-Stream. Ein stillschweigendes Löschen würde zwar die scheinbare Sauberkeit des Datensatzes verbessern, aber den Verlust an Abdeckung verschleiern.

Beginnen Sie für die Erfassungsschicht, die diese Felder bereitstellt, mit der einfachsten Abrufmethode, die den erforderlichen Inhalt bereitstellt. Der Leitfaden zu Python-HTTP-Clients behandelt diese Auswahl; das eBay-Tutorial zur Preisauswertung bietet ein plattformspezifisches Beispiel, das Sie nach Prüfung Ihrer Quellenanforderungen anpassen können.

Erfassen Sie wiederholbare Momentaufnahmen und erkennen Sie Änderungen in der Pipeline

Wählen Sie einen Zeitplan, der zur Forschungsfrage und den zulässigen Anfragebedingungen passt. Häufige Beobachtungen sind nur dann sinnvoll, wenn die zusätzlichen Details die Analyse beeinflussen. Ein täglicher Sortimentsbericht erfordert nicht automatisch einen minutengenauen Abruf, insbesondere wenn dies die Kosten erhöht und Qualitätsprüfungen erschwert.

Erfassen Sie den Erfassungskontext konsistent: Region, Sprache, Zielort, ausgewählte Variante und alle relevanten Bedingungen öffentlicher Angebote. Wenn sich dieser Kontext ändert, kennzeichnen Sie die Unterbrechung in der Reihe. Andernfalls kann ein Standortwechsel fälschlicherweise als wettbewerbsrelevante Preisänderung erscheinen.

Erstellen Sie eine kleine Sammlung geprüfter Testfälle, die gängige Seiten und problematische Fälle abdecken. Testen Sie Parser anhand dieser Testfälle, wenn sich Selektoren oder Abhängigkeiten ändern. Live-Prüfungen bestätigen dann, dass die Seitenstruktur und die angezeigten Werte weiterhin mit Ihren Annahmen übereinstimmen. Eine erfolgreiche HTTP-Antwort sollte niemals die einzige Abnahmebedingung sein.

Überwachen Sie die Häufigkeit fehlender Felder, unerwartete Änderungen der Datensatzanzahl, doppelte IDs und ungewöhnlich große Preisbewegungen. Diese Prüfungen sollten eine Untersuchung auslösen, nicht die automatische Löschung überraschender Werte. Echte Werbeaktionen und Fehler bei der Datenextraktion können in einem Diagramm ähnlich aussehen. Vergleichen Sie die gespeicherten Nachweise, die jüngsten Änderungen am Parser und benachbarte Beobachtungen, bevor Sie entscheiden, welche Erklärung zutrifft.

Halten Sie die Ergebnisse von Wiederholungsversuchen getrennt von den ursprünglichen Versuchen und verwenden Sie stabile Beobachtungsschlüssel, damit ein Wiederholungsversuch bei der Datenübermittlung keine zweite Produktbeobachtung erzeugt. Für eine umfassendere Diskussion zur Implementierung bietet der Scrapy-Leitfaden zur Datenerfassung Hintergrundinformationen zum Crawling.

Überprüfen Sie vor der Ausführung des Jobs die zulässigen Zugriffsrechte, die Nutzungsbedingungen der Website und den Umfang der Datenerhebung. Richten Sie den Datensatz auf die geschäftliche Fragestellung aus und minimieren Sie unnötige personenbezogene Daten. Befolgen Sie eine Richtlinie für begrenzte Anfragen und leiten Sie unklare Zugriffsbedingungen zur Überprüfung weiter. Ein gehosteter Abrufdienst ändert lediglich, wer die Netzwerkschicht betreibt, nicht jedoch, was Ihr Forschungsprojekt erheben darf.

Berichten Sie über Preisbewegungen, ohne Marktanteile zu erfinden

Ein aussagekräftiger Bericht überträgt seine Messregeln in die Ausgabe. Zeigen Sie neben dem Hauptdiagramm das Quellenfeld, das Beobachtungsfenster, die Anzahl der gültigen Datensätze, nicht zugeordnete Produkte und fehlende Quellen an. Analysten sollten nicht erst ein Pipeline-Protokoll überprüfen müssen, um festzustellen, dass ein Einzelhändler aus der Stichprobe verschwunden ist.

Identifizieren Sie bei Preisvergleichen die abgeglichene Kohorte und die Bedingungen, unter denen die Gesamtwerte vergleichbar sind. Wenn Sie eine prozentuale Veränderung angeben, weisen Sie darauf hin, ob dabei dieselben Produkte in beiden Zeiträumen oder unterschiedliche wöchentliche Sortimente verglichen werden. Diese Kennzahlen beantworten unterschiedliche Fragen, auch wenn ihre Diagramme identisch aussehen.

Trennen Sie beschreibende Zusammenfassungen von einem formalen Preisindex. Ein Median des beobachteten Preises oder eine Veränderung bei abgeglichenen Produkten kann für interne Untersuchungen nützlich sein, erfüllt jedoch nicht automatisch die methodischen Anforderungen einer Inflationsmessgröße. Vermeiden Sie es, einen einfachen Durchschnitt als „Markteinflation“ zu bezeichnen oder ihn als repräsentativ für die Verbraucherausgaben darzustellen.

Ebenso sind Auflistungszahlen Kennzahlen für das beobachtete Sortiment, nicht für den Marktanteil. Ein Einzelhändler mit mehr indizierten Seiten kann eine andere Paginierung, mehr Varianten oder doppelte Marktplatzangebote aufweisen. Der Umsatzanteil erfordert geeignete Belege zu Absatz und Marktgröße, die über diesen Datensatz hinausgehen. Halten Sie die Formulierungen im Bericht nah an dem, was die Datenerhebung tatsächlich belegt.

Beenden Sie jeden Bericht mit den Fragen, die die Daten aufwerfen, anstatt mit unbegründeten Erklärungen. Ein steigender Anteil an Werbeangeboten kann die Untersuchung einer Kampagne rechtfertigen. Er beweist jedoch nicht, dass ein Wettbewerber unter finanziellem Druck steht. Gutes Web-Scraping für die Marktforschung macht diese Folgeentscheidungen präziser und bewahrt gleichzeitig die Unterscheidung zwischen Belegen und Interpretation.

Wichtige Erkenntnisse

  • Definieren Sie eine Forschungsfrage, die durch öffentliche Beobachtungen beantwortet werden kann, und dokumentieren Sie anschließend die fehlenden Belege.
  • Erhalten Sie die Produktidentität, die Angebotsbedingungen, den Kontext der Datenerhebung und die Zeitstempel, bevor Sie Vergleiche anstellen.
  • Erfassen Sie die Stichprobenabdeckung getrennt von erfolgreichen Abfragen und gültigen extrahierten Datensätzen.
  • Überprüfen Sie Übereinstimmungen, Währung, Einheiten, Steuern und Versandkosten, bevor Sie Preise in eine Rangfolge bringen.
  • Bezeichnen Sie Sortiments- und Preismessgrößen genau; aus dem Internet gesammelte Angebote sagen nichts über Umsätze oder Marktanteile aus.

FAQ

Können Kundenbewertungen zum Forschungsdatensatz hinzugefügt werden?

Ja, behandeln Sie diese jedoch als separate Beweisquelle mit eigenen Stichprobenbeschränkungen. Rezensenten sind nicht unbedingt repräsentativ für alle Käufer, und der Text kann personenbezogene Daten enthalten. Legen Sie den zulässigen Erfassungsumfang fest, minimieren Sie unnötige Identifikatoren und geben Sie die Plattform sowie den Beobachtungszeitraum an. Stimmungsbewertungen sind abgeleitete Einschätzungen; geben Sie daher die Methode und die Unsicherheit an, anstatt sie als direkte Kundenfakten darzustellen.

Wie sollten Forschungsergebnisse an ein anderes Team weitergegeben werden?

Stellen Sie zusammen mit den Datensätzen ein Datenwörterbuch, den Quellumfang, Zeitstempel und bekannte Einschränkungen bereit. Fügen Sie die Regeln für fehlende Werte, Produktabgleich und alle abgeleiteten Felder bei, damit ein anderer Analyst das Ergebnis reproduzieren kann. Ein versionierter Export lässt sich leichter prüfen als eine Tabellenkalkulation, deren Werte sich ohne Vorankündigung ändern. Geben Sie den verantwortlichen Ansprechpartner für Fragen zur Interpretation oder zu Korrekturen an.

Kann KI Produkte in Forschungskategorien einordnen?

Ja, aber überprüfen Sie die zugewiesenen Bezeichnungen anhand einer geprüften Stichprobe, bevor Sie sie in Aggregaten verwenden. Halten Sie die Kategoriedefinition, die Modell- oder Regelversion sowie ungewisse Zuordnungen zur Überprüfung bereit. Eine Änderung der Klassifizierung kann dazu führen, dass Produkte zwischen Gruppen verschoben werden und gemeldete Trends sich ändern, selbst wenn die Quelldaten unverändert bleiben. Führen Sie für neue oder mehrdeutige Kategorien einen separaten Überprüfungsprozess durch.

Fazit

Web-Scraping für die Marktforschung funktioniert am besten, wenn Sie die Messung vor dem Datenerfasser konzipieren. Definieren Sie die Fragestellung, wählen Sie ein vertretbares Quellenpanel aus und bewahren Sie die Unterscheidung zwischen Produkten, Angeboten und Beobachtungen. Überprüfen Sie die Vergleichbarkeit, bevor Sie eine Preisdifferenz berechnen, und legen Sie fehlende Abdeckung offen, anstatt sie in einem ansprechenden Diagramm zu verbergen.

Beginnen Sie mit einer Kategorie und einem kleinen, geprüften Panel. Vergewissern Sie sich, dass die Datensätze die beabsichtigte Frage beantworten können, führen Sie die Datenerhebung über wiederholte Beobachtungen hinweg durch und untersuchen Sie Fehler, bevor Sie die Quellenliste erweitern. Die Skalierung eines mehrdeutigen Schemas führt nur zu einem größeren, mehrdeutigen Datensatz.

Wenn das Abrufen von Seiten die Aufmerksamkeit von dieser analytischen Arbeit ablenkt, sollten Sie die Scraper-API von WebScrapingAPI als Abrufkomponente in Betracht ziehen und dabei Ihre Forschungsdefinitionen und Validierungsregeln explizit beibehalten. Der Wert der fertigen Pipeline liegt nicht darin, wie viel Daten sie sammelt. Er besteht vielmehr darin, ob ein anderer Entwickler oder Analyst ein Ergebnis überprüfen, dessen Grenzen erkennen und auf der Grundlage der vorliegenden Erkenntnisse eine fundierte Entscheidung treffen kann.

Über den Autor

Sergiu Inizian, Autor für technische Inhalte @ WebScrapingAPI

Sergiu Inizian

Autor für technische Inhalte

Sergiu Inizian ist Technical Content Writer bei WebScrapingAPI und verfasst verständliche, praxisorientierte Inhalte, die Entwicklern helfen, das Produkt zu verstehen und effektiv zu nutzen.

Alternatives Data Scraping für das Finanzwesen: Wie Webdaten Anlegern einen Vorteil verschaffen
Anwendungsfälle

Alternatives Data Scraping für das Finanzwesen: Wie Webdaten Anlegern einen Vorteil verschaffen

TL;DR: Alternatives Data Scraping nutzt Web-Sammeltechniken, um nicht-traditionelle Datensätze (Produktpreise, Stimmungen, Stellenausschreibungen, behördliche Einreichungen) zu sammeln, die Marktsignale offenbaren, bevor sie in Gewinnberichten erscheinen. Dieser Leitfaden führt Sie durch die wertvollsten Datenquellen, den Aufbau von Pipelines für die Finanzbranche, die Validierung der Datenqualität und die Compliance-Leitplanken, die Sie benötigen, um auf der richtigen Seite des Gesetzes zu bleiben.

Mihnea-Octavian Manolache15 min read
Artikel lesen
Was sind Finanzdaten? Arten, Erhebungsmethoden und Analysewerkzeuge
Anwendungsfälle

Was sind Finanzdaten? Arten, Erhebungsmethoden und Analysewerkzeuge

TL;DR: Finanzdaten sind die Sammlung von quantitativen Aufzeichnungen (Einnahmen, Ausgaben, Vermögenswerte, Verbindlichkeiten, Cashflow), die Organisationen und Einzelpersonen nutzen, um fundierte wirtschaftliche Entscheidungen zu treffen. Dieser Leitfaden schlüsselt die vier wichtigsten Finanzdaten auf, vergleicht traditionelle und alternative Datenquellen, geht auf moderne Erhebungsmethoden ein und behandelt die Instrumente, die Fachleute für die Analyse verwenden.

Suciu Dan12 min read
Artikel lesen
XPath vs. CSS-Selektoren: Die Wahl des richtigen Selektors
Anwendungsfälle

XPath vs. CSS-Selektoren: Die Wahl des richtigen Selektors

TL;DR: XPath- und CSS-Selektoren lokalisieren beide DOM-Elemente, aber sie lösen unterschiedliche Probleme. CSS-Selektoren sind schneller und besser lesbar für einfache Auswahlen. XPath gewinnt, wenn Sie das DOM in beliebiger Richtung durchlaufen, Textinhalte abgleichen oder komplexe bedingte Logik verarbeiten müssen. Die meisten Produktionsprojekte profitieren vom strategischen Einsatz beider Methoden.

Mihai Maxim13 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.