Zum Inhalt springen
Zurück zum Blog

Umgang mit Google-/goto-Weiterleitungs-URLs und CAES-Token in einem SERP-Scraper

Suciu DanZuletzt aktualisiert am 11 min read
Umgang mit Google-/goto-Weiterleitungs-URLs und CAES-Token in einem SERP-Scraper
Kurzfassung: Google-/goto-URLs mit CAES-Token und ältere /url-Wrapper sind Weiterleitungsschichten, keine Ziele; ein SERP-Scraper, der jede href als endgültig behandelt, verfälscht Rank-Tracking und Link-Datenbanken. Bevorzugen Sie eine strukturierte SERP-API, wenn sie Ziel-Links liefert. Wenn Sie HTML parsen müssen, klassifizieren Sie jede href, deduplizieren Sie Weiterleitungen und lösen Sie sie mit einem einfachen GET auf. Entschlüsseln Sie CAES nicht.

Die Google-Suche kann eine undurchsichtige Weiterleitung zwischen einem SERP-Ergebnis und der Zielseite einfügen. Anstatt https://example.com/page in der href, wird möglicherweise https://www.google.com/goto?url=CAES...—oder einen älteren /url Wrapper, der dieselbe Art von Token enthält. Für Nutzer führt ein Klick weiterhin zur richtigen Seite. Für einen Scraper, der jeden href als Endpunkt betrachtet, führt dies zu Störungen bei der Rangverfolgung, bei der Speicherung ausgehender Links und bei nachfolgenden Crawls.

Dies ist eine URL-Pipeline für den Produktivbetrieb, kein kryptografischer Fachartikel. Bevorzugen Sie eine strukturierte Google-Search-API (SERP), wenn diese Ziel-Links zurückgibt. Wenn Sie HTML analysieren müssen, klassifizieren Sie jede href, dupliziere Weiterleitungen, löse sie mit einem einfachen GETauflösen und Fehler protokollieren. Entschlüsseln Sie nicht CAES.
Wichtige Erkenntnisse

  • Behandeln Sie /goto?url=CAES... und /url?... als Weiterleitungsschichten, nicht als Ziele.
  • Nicht entschlüsseln CAES. Lösen Sie das Problem mit GET und allow_redirects=False, dann lesen Location.
  • Pfad A bevorzugen: WebScrapingAPI SERP API strukturiertes JSON, wenn organische link Felder als Ziele dienen.
  • Verwenden Sie Weg B: Scraper-API oder Browser-API (nur HTML), wenn Sie das Roh-Markup benötigen – anschließend klassifizieren → deduplizieren → auflösen.
  • HTTP 200 ist kein brauchbares SERP. Validieren Sie die Ergebniscontainer vor dem Parsen.
  • Entdoppeln Sie identische /goto Token innerhalb einer Seite; Verbindungen wiederverwenden; Parallelität begrenzen.
  • Speichere bei jeder Beobachtung einen Anfrage-Fingerabdruck (Abfrage, gl, hl, deviceDomain, Zeit) bei jeder Beobachtung.
  • Das Linkformat von Google ist nicht in Stein gemeißelt. Entwerfen Sie das System für direkte URLs, /gotound /url.

Was Google /goto ist (und wie es sich von /url )

/goto ist (und wie es sich von /url)

Früher haben Scraper die Zieladresse oft direkt aus dem organischen Anker ausgelesen. Heute kann dasselbe konzeptionelle Ergebnis in verschiedenen Formen auftreten:

Form

Beispielmuster

Vorgehensweise

Direktes Ziel

https://example.com/page

Unverändert verwenden

/goto + CAES

https://www.google.com/goto?url=CAES...

Über GET → Location

/url Wrapper

https://www.google.com/url?...&url=CAES... oder Legacy- url= / q= Varianten

Separat klassifizieren; Parameter sorgfältig auflösen oder analysieren

Andere Google-Hosts/Pfade

Maps, Konten, internes Chrome

Ignorieren oder außerhalb der organischen Pipeline behandeln

/goto ist ein von Google gehosteter Weiterleitungsendpunkt. Der url Abfragewert beginnt oft mit CAES— nicht, weil „CAES“ ein Produktname ist, sondern weil so ein gängiges Binär-Envelope nach der Base64URL-Kodierung aussieht. Beim Öffnen des Links wird Google um eine Weiterleitung zum eigentlichen Ziel gebeten.

/url ist ein älterer (und immer noch vorkommender) Google-Weiterleitungspfad. Berichten zufolge erhalten einige Clients /url mit einer CAES Nutzlast anstelle eines Klartext-Ziels. Die Scraper-Regel ist in beiden Fällen dieselbe: Klassifizieren Sie den Link, behalten Sie dann entweder das direkte Ziel bei oder lösen Sie den Wrapper auf. Gehen Sie nicht davon aus, dass undurchsichtige Tokens nur auf /goto.

Google hat Weiterleitungsschichten als Teil technischer Maßnahmen gegen den sich weiterentwickelnden Missbrauch der Suche beschrieben. Die genaue Rollout-Logik ist nicht öffentlich bekannt. Entwickeln Sie für mehrere Formate.

Müssen Sie überhaupt HTML scrapen?

Die meisten produktiven Rank-Tracking- und SERP-Monitoring-Aufträge benötigen Ziel-URLs + Titel + Snippets + Platzierungen, nicht Googles Darstellungs-HTML. Wähle zuerst den Produktpfad aus.

Weg A – SERP-API (bevorzugt, wenn Ziel-URLs im JSON-Format vorliegen)

Senden Sie eine kontextbezogene Google-Abfrage an den SERP-Endpunkt der WebScrapingAPI und lesen Sie die geparsten Datensätze aus:

  • Endpunkt: https://serpapi.webscrapingapi.com/v2
  • Erforderlich: api_key, engine=google, q
  • Allgemeine optionale Steuerelemente: device, domain, uule, hl, gl, start, num, tbm, ibp
  • Asynchrone Alternative: engine=google_async, anschließend über die Snapshot-API abrufen

Produktseiten: SERP-API · Google Search API-Dokumentation
: Zugriff auf die API · Google-Suchmaschine

Was die öffentlichen Dokumentationen derzeit zeigen: Beispiele für organische Ergebnisse verwenden link Felder, die wie endgültige Ziel-URLs aussehen (zum Beispiel https://www.history.com/ oder https://en.wikipedia.org/wiki/History), nicht google.com/goto Wrapper. In der Felddokumentation werden link als Ziel-URL.

Überprüfen Sie das link Feld in Ihrer eigenen Live-Antwort:

  • Bevor Sie sich ausschließlich auf Pfad A verlassen, überprüfen Sie die organischen link Werte aus einem datierten SERP-Abruf in Ihrem Konto.
  • Öffentliche Dokumentationen zeigen Beispiele, die auf die Ziel-URL hindeuten link Beispiele; ob Ihre Live-Produktionsantworten Ergebnisse in /goto , kann nur Ihre eigene Stichprobe zeigen – ziehen Sie aus diesem Artikel keine voreiligen Schlüsse.

Beachten Sie außerdem eine doppelte Benennung im Dokumentationsschema: Einige Seiten zeigen ein organic Array (link, display_link, rank), während die Dokumentation zu organischen Ergebnissen organic_results (link, displayed_link, position). Beide dokumentieren link als Ziel an. Führen Sie eine vorsichtige Analyse für beide Formate durch und validieren Sie die Ergebnisse anhand einer Live-Antwort.

Weg B – Scraper-API / Browser-API-HTML (wenn du die Seite analysieren musst)

Verwenden Sie HTML, wenn Sie benutzerdefinierte Selektoren, Layout-Analysen oder einen Workflow benötigen, den die strukturierte SERP-Engine nicht abdeckt:

  • Scraper-API: https://api.webscrapingapi.com/v2 mit api_key + url
  • „Set“ render_js=1 wenn das Ziel clientseitiges JavaScript benötigt, bevor Sie den Body erhalten
  • Browser-API: wenn Sie dokumentierte Wartezeiten, Interaktionen oder Steuerelemente für den Browserstatus benötigen

Überprüfen Sie, ob die SERP nutzbar ist. Ein HTTP-Request 200 kann immer noch ein Interstitial, eine Einwilligungsabfrage, ein CAPTCHA oder eine „JavaScript aktivieren“-Maske sein. Bevor du Links extrahierst, stelle sicher, dass erkennbare Ergebniscontainer vorhanden sind (zum Beispiel Anker unter #rso / #searchoder gleichwertige Marker, die Sie verwenden). Wenn die Validierung fehlschlägt, versuchen Sie es erneut mit Rendering, passen Sie den Sprach- und Gerätekontext an oder greifen Sie auf Pfad A zurück – speichern Sie keine leeren Rankings ohne Rückmeldung.

Nachdem du /goto URLs aus HTML extrahiert haben, lösen Sie diese mit einfachem HTTP auf (siehe unten). In der Regel benötigen Sie nicht für jeden organischen Link ein weiteres „Rendered Scrape“-Guthaben.

So lösen Sie das Problem /goto (früh im Code)

/goto (früh im Code)

Die Auflösung ist der Kern von Weg B – und ein Sicherheitsnetz, falls jemals ein Wrapper in der strukturierten Ausgabe auftaucht.

import requests

def resolve_google_goto(url: str, timeout: float = 10.0) -> str:
    """Resolve a Google /goto (or similar) redirect without following to the destination site."""
    response = requests.get(
        url,
        allow_redirects=False,
        timeout=timeout,
        headers={"User-Agent": "Mozilla/5.0"},
    )
    if response.status_code != 302:
        raise RuntimeError(f"Expected 302, got {response.status_code} for {url[:80]}...")
    location = response.headers.get("Location")
    if not location:
        raise RuntimeError("Redirect response has no Location header")
    return location  # keep full value, including #:~:text= fragments when present

Regeln, die in der Produktion gelten:

  1. allow_redirects=False — Sie möchten Googles Location, keinen zweiten Hop zum Publisher.
  2. Bevorzugen Sie GET statt HEAD. Öffentliche Berichte besagen, dass HEAD kann 200 ohne Location Header zurückgeben, während GET mit 302 mit dem Ziel zurück. Betrachten Sie dies als allgemeine Richtlinie; überprüfen Sie das Verhalten von HEAD und GET anhand eines Live-Tokens /goto Token aus Ihrer eigenen Pipeline, bevor Sie die Methode fest einprogrammieren.
  3. Behalten Sie Location unverändert. Google gibt möglicherweise Textfragmente wie #:~:text=.... Entfernen Sie diese nur, wenn Ihr Produkt ausdrücklich kanonische URLs benötigt.
  4. Führen Sie die Auflösung außerhalb der Scrape-API durch, wenn das Token portabel ist – sammeln Sie die Daten über Scraper/Browser-HTML und lösen Sie sie mit einer normalen Client-Sitzung auf.

Minimales cURL-Muster:

curl -sS -o /dev/null -D - \
  "https://www.google.com/goto?url=CAES..." \
  | grep -i '^location:'

Verwenden Sie -L , wenn Sie nur das Weiterleitungsziel benötigen.

Klassifizieren Sie jedes href

href

Erstellen Sie den Parser niemals ausschließlich auf der Grundlage des Teilstrings CAES allein auf. Klassifizieren Sie zuerst die absolute URL:

from urllib.parse import parse_qs, urljoin, urlparse

GOOGLE_BASE_URL = "https://www.google.com/"

def is_google_host(host: str) -> bool:
    host = (host or "").lower()
    return host == "google.com" or host.endswith(".google.com")

def classify_google_link(href: str) -> tuple[str, str]:
    absolute = urljoin(GOOGLE_BASE_URL, href)
    parsed = urlparse(absolute)
    host = parsed.hostname or ""

    if is_google_host(host) and parsed.path == "/goto":
        token = parse_qs(parsed.query).get("url", [""])[0]
        if token.startswith("CAES"):
            return "goto", absolute
        return "goto", absolute  # still a /goto wrapper even if token shape changes

    if is_google_host(host) and parsed.path == "/url":
        return "google_url", absolute

    if parsed.scheme in {"http", "https"} and not is_google_host(host):
        return "direct", absolute

    return "other", absolute

Empfohlene Vorgehensweise:

Art

Aktion

direct

Behalten

goto

Deduplizieren → auflösen → behalten Location

google_url

Bekannte Abfrageschlüssel auflösen oder analysieren; nicht von Klartext ausgehen

other

Aus organischen Quellen entfernen (oder an einen separaten Handler weiterleiten)

Produktionspipeline: Duplikate entfernen, Parallelität, Fehler, Fingerabdruck

HTML → URL-Pipeline:

SERP fetch (SERP API JSON or Scraper/Browser HTML)
        ↓
validate usable payload (JSON modules or SERP DOM)
        ↓
extract candidate hrefs / link fields
        ↓
classify → direct | goto | google_url | other
        ↓
dedupe wrappers (same token often repeats in one SERP)
        ↓
resolve with GET, bounded concurrency, connection reuse
        ↓
merge destinations + store request fingerprint + outcome codes

Vor der Auflösung deduplizieren

Eine SERP-Seite wiederholt oft denselben /goto Token in Titel und Sitelink-Ankern. Das Auflösen jedes Ankers verschwendet Anfragen. Reihenfolge beibehalten und gleichzeitig Eindeutigkeit sicherstellen:

unique_goto_urls = list(dict.fromkeys(goto_urls))

Begrenzte Parallelität und Wiederverwendung von Verbindungen

Verwenden Sie einen kleinen Worker-Pool und einen requests.Session pro Worker, damit TCP/TLS wiederverwendet werden kann. Die genaue Anzahl der Worker ist umgebungsabhängig – passen Sie diese anhand Ihrer Latenz und Fehlerraten an, anstatt die Benchmark-Werte anderer Anbieter zu übernehmen.

Fehlertaxonomie (diese instrumentieren)

Code / Klasse

Bedeutung

Empfohlene Vorgehensweise

http_non_302

Unerwarteter Status von /goto

Zählung; Beispiel-URL; Backoff, falls 429/5xx

missing_location

302 ohne Location

Dieses Ergebnis als Fehler behandeln; keine URL erfinden

timeout / Netzwerk

Vorübergehend

Wiederholung mit jitterbehaftetem Backoff

invalid_token

Anhaltender Fehler bei einem Token

Als fehlgeschlagen markieren; keinen Wiederholungsversuch mehr durchführen

serp_unusable

200 Der Body ist kein SERP

Abrufpfad korrigieren (render_js, Produktauswahl) vor dem Parsen

wrapper_unresolved

/url Pfad, den du noch nicht bearbeitest

In die Warteschlange zur Überprüfung stellen; Ranglisten nicht ohne Angabe einer Kennzahl stillschweigend herabsetzen

Speichere einen Beobachtungs-Fingerabdruck

Vergleichbare SERP-Daten benötigen neben den URLs zusätzlichen Kontext:

  • q, gl, hl, device, domain, uule (falls verwendet), start, num, tbm/ibp
  • Zeitstempel der Beobachtung und Schema-Version
  • Abrufpfad (serp_api vs scraper_html vs browser_html)
  • Zählwerte: direkt / goto / google_url / aufgelöst / fehlgeschlagen

Dies steht im Einklang mit den Leitlinien der WebScrapingAPI für verantwortungsbewusste Webdaten: Der Beobachtungskontext soll erhalten bleiben, damit nachgelagerte Teams jeden Datensatz interpretieren können.

Wann gibt Google /goto ?

/goto?

Kurze Antwort: Betrachten Sie dies als bedingten Fall und nicht als feste Regel.

Berichte von Drittanbietern (einschließlich der ausführlichen Analyse von ScrapingBee vom September 2026) haben Folgendes festgestellt /goto in manuell bedienten Chrome- und Edge-Instanzen, in Playwright-Sitzungen und in HTML, das über Scraping-APIs abgerufen wurde, während einige datenschutzorientierte Browser weiterhin direkte Ziele anzeigten und Safari manchmal /url mit CAES. Dabei handelt es sich um von Wettbewerbern gemeldete Beobachtungen, nicht um Wiederholungen von WebScrapingAPI-Tests, und sie stellen keine verbindliche Zusage von Google dar. IP- oder Länderwechsel allein wurden in diesen Tests als unzureichend gemeldet, um direkte Links zu erzwingen – auch hier gilt: mit Vorsicht betrachten und nicht überinterpretieren.

Sichere Annahmen für die Produktion:

  • Automatisierung ist nicht der einzige Auslöser.
  • Die Browser-Engine allein ist kein zuverlässiger Auslöser.
  • Die Geolokalisierung allein ist kein zuverlässiger Auslöser.
  • Ihr Scraper muss direkte Links akzeptieren, /gotound /url im Laufe der Zeit.

Wenn Sie eine Browser-Matrix für Ihre eigene Compliance-Strategie benötigen, führen Sie einen kleinen internen Smoke-Test durch und versehen Sie ihn mit einem Datum – veröffentlichen Sie keine unüberprüften Regeln als Fakten.

Was steckt in einem CAES Token? (kurzer Anhang)

CAES Token? (kurzer Anhang)

Sie benötigen diesen Abschnitt nicht, um einen funktionierenden Scraper zu veröffentlichen. Er dient dazu, dass Teams keine Zeit mehr mit Sackgassen verschwenden.

Auf einer übergeordneten Ebene beschreiben Branchenanalysen Folgendes:

  1. Base64URL-Dekodierung des CAES... Parameters → Binärdaten
  2. Ein kompakter, protobuf-ähnlicher Umschlag (in der Regel ein konstantes Feld plus ein längenbegrenztes Blob)
  3. Eine geschützte Nutzlast, deren äußere Bytes dem Präfix der Ausgabe einer Kryptografie-Bibliothek ähneln
  4. Kein wiederherstellbares Klartext-Ziel für praktische Scraping-Zwecke

„Resolve-first“-Richtlinie: Dekodieren Sie aus Neugier oder für die Malware-Forschung, wenn es unbedingt sein muss; für SERP-Produkte rufen Sie /goto und lesen Location. Der Versuch, den geschützten Blob zurückzuentschlüsseln, ist das falsche Problem.

End-to-End-Pfad A – SERP-API

Python:

import os
import requests

api_key = os.environ["WSA_API_KEY"]

response = requests.get(
    "https://serpapi.webscrapingapi.com/v2",
    params={
        "api_key": api_key,
        "engine": "google",
        "q": "best trail shoes",
        "gl": "us",
        "hl": "en",
        "device": "mobile",
    },
    timeout=120,
)
response.raise_for_status()
payload = response.json()

# Docs may use organic or organic_results — support both.
organic = payload.get("organic") or payload.get("organic_results") or []

for row in organic:
    link = row.get("link")
    title = row.get("title")
    # Check link on your live response; if it looks like google.com/goto or /url, classify + resolve.
    print(title, "→", link)

Node.js:

const apiKey = process.env.WSA_API_KEY;
if (!apiKey) throw new Error("WSA_API_KEY is required");

const parameters = new URLSearchParams({
  api_key: apiKey,
  engine: "google",
  q: "best trail shoes",
  gl: "us",
  hl: "en",
  device: "mobile",
});

const response = await fetch(
  "https://serpapi.webscrapingapi.com/v2?" + parameters,
  { signal: AbortSignal.timeout(120_000) }
);
if (!response.ok) {
  throw new Error("Google Search API status " + response.status);
}
const payload = await response.json();
const organic = payload.organic || payload.organic_results || [];
for (const row of organic) {
  console.log(row.title, "→", row.link);
}

cURL:

: "${WSA_API_KEY:?WSA_API_KEY is required}"
curl --get --fail-with-body --max-time 120 \
  "https://serpapi.webscrapingapi.com/v2" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "engine=google" \
  --data-urlencode "q=best trail shoes" \
  --data-urlencode "gl=us" \
  --data-urlencode "hl=en" \
  --data-urlencode "device=mobile"

Verwenden Sie für in der Warteschlange befindliche Workloads engine=google_async den dokumentierten Ablauf zum Abrufen von Snapshots anstelle einer Blockierung durch die synchrone Engine.

End-to-End-Pfad B – HTML → klassifizieren → auflösen

from __future__ import annotations

import os
import threading
from concurrent.futures import ThreadPoolExecutor
from urllib.parse import urlencode

import requests
from bs4 import BeautifulSoup

# reuse classify_google_link + resolve_google_goto from earlier sections

SCRAPER_API = "https://api.webscrapingapi.com/v2"
GOOGLE_SEARCH = "https://www.google.com/search"
_thread_local = threading.local()


def fetch_google_html(query: str, api_key: str) -> str:
    target = GOOGLE_SEARCH + "?" + urlencode({"q": query, "hl": "en"})
    response = requests.get(
        SCRAPER_API,
        params={
            "api_key": api_key,
            "url": target,
            "render_js": "1",  # enable when Google returns a JS shell instead of a SERP
        },
        timeout=120,
    )
    response.raise_for_status()
    return response.text


def assert_usable_serp(html: str) -> None:
    soup = BeautifulSoup(html, "html.parser")
    if not soup.select("#rso a[href], #search a[href]"):
        raise RuntimeError("No recognizable Google search results found (unusable SERP body)")


def extract_links(html: str) -> tuple[list[str], list[str], list[str]]:
    soup = BeautifulSoup(html, "html.parser")
    direct, goto, google_url = [], [], []
    for anchor in soup.select("#rso a[href], #search a[href]"):
        href = anchor.get("href") or ""
        kind, url = classify_google_link(href)
        if kind == "direct":
            direct.append(url)
        elif kind == "goto":
            goto.append(url)
        elif kind == "google_url":
            google_url.append(url)
    return direct, goto, google_url


def get_worker_session() -> requests.Session:
    session = getattr(_thread_local, "session", None)
    if session is None:
        session = requests.Session()
        _thread_local.session = session
    return session


def resolve_goto(url: str) -> tuple[str, str | None]:
    session = get_worker_session()
    try:
        response = session.get(url, allow_redirects=False, timeout=10)
    except requests.RequestException:
        return url, None
    if response.status_code != 302:
        return url, None
    return url, response.headers.get("Location")


def resolve_many(urls: list[str], workers: int = 5) -> dict[str, str]:
    unique_urls = list(dict.fromkeys(urls))
    with ThreadPoolExecutor(max_workers=workers) as executor:
        results = executor.map(resolve_goto, unique_urls)
    return {src: dest for src, dest in results if dest}


def main() -> None:
    api_key = os.environ["WSA_API_KEY"]
    html = fetch_google_html("best trail shoes", api_key)
    assert_usable_serp(html)

    direct, goto, google_url = extract_links(html)
    direct = list(dict.fromkeys(direct))
    goto = list(dict.fromkeys(goto))

    resolved = resolve_many(goto, workers=5)
    # Optionally add handlers for google_url wrappers here.

    destinations = list(dict.fromkeys(direct + list(resolved.values())))
    for url in destinations:
        print(url)

    # Persist fingerprint + counts in your store:
    # path=scraper_html, q, hl, render_js=1, n_direct, n_goto, n_resolved, n_failed


if __name__ == "__main__":
    main()

Installation: pip install requests beautifulsoup4. Halten Sie WSA_API_KEY in der Umgebung – niemals fest einbinden.

Verantwortungsbewusste Nutzung

Öffentliche SERP-URLs sind nach wie vor Webdaten. Bevor Sie die Erfassung ausweiten:

  1. Legen Sie den geschäftlichen Zweck fest (Rangüberwachung, Sichtbarkeit der Konkurrenz, Recherche).
  2. Legen Sie den Umfang der öffentlichen Quellen fest (Google-Domains, Märkte, Geräte, Ausschlüsse).
  3. Führen Sie nur ein Minimum an nützlichen Aufzeichnungen – nicht jedes Feld, das Google anzeigt.
  4. Weisen Sie nachgelagerte Verantwortliche für Zugriff, Aufbewahrung und Entscheidungen zu.
  5. Bewahren Sie den Beobachtungskontext, damit die Ergebnisse interpretierbar bleiben.

Lesen Sie die Betriebsrichtlinie von WebScrapingAPI: Verantwortungsvoller Umgang mit Webdaten. Ihr Team ist für den Zweck, den Umfang der Quellen und die nachgelagerte Nutzung verantwortlich; WebScrapingAPI betreibt den ausgewählten API-Pfad. Dieser Artikel stellt keine Rechtsberatung dar und ist kein Leitfaden zur Umgehung von Sicherheitskontrollen – es handelt sich um eine praktische Pipeline zur URL-Verarbeitung für die legitime Beobachtung öffentlicher Suchergebnisse.

FAQ

Muss ich CAES Token entschlüsseln?

CAES Token entschlüsseln?

Nein. Für das Scraping und die Ranking-Verfolgung GET muss die /goto URL mit deaktivierten Weiterleitungen und im Lesemodus Location. Die lokale Base64URL-/Protobuf-Dekodierung liefert kein brauchbares Klartext-Ziel.

Sollte ich HEAD verwenden, um /goto ?

HEAD verwenden, um /goto?

Bevorzugen GET. Öffentlichen Berichten zufolge HEAD könnte 200 ohne Location während GET gibt 302 mit dem Ziel zurück. Überprüfen Sie HEAD vs. GET an einem Live- /goto Token aus Ihrer eigenen Pipeline, bevor Sie das Client-Verhalten festlegen.

Was ist der Unterschied zwischen /goto und /url ?

/goto und /url?

Beides sind Google-Weiterleitungs-Endpunkte, die zwischen der SERP und dem Ziel liegen können. /goto enthält üblicherweise einen CAES... url Parameter. /url ist ein Wrapper älteren Stils, der möglicherweise noch vorkommt (manchmal mit undurchsichtigen Tokens). Klassifizieren Sie beide; werten Sie das, was Sie nicht parsen können, als direktes Ziel aus.

Sollte ich die SERP-API verwenden oder Google-HTML auslesen?

Bevorzugen Sie die Google Search SERP-API, wenn strukturierte organische Ergebnisse Ihrem Schema entsprechen – weniger Anfälligkeit des HTML-Codes, klarerer Fingerabdruck der Anfrage. Verwenden Sie die Scraper-API oder die Browser-API, wenn Sie rohes Markup oder benutzerdefinierte Interaktionen benötigen. Die Beispiele in der Dokumentation zeigen endgültig aussehende link Werte; überprüfen Sie das link Feld in Ihrer eigenen Live-Antwort und notieren Sie das Datum, bevor Sie davon ausgehen, dass das Format im Rahmen der /goto Einführung davon ausgeht.

Verfallen CAES Token verfallen?

CAES Token verfallen?

Berichte von Drittanbietern deuten darauf hin, dass Tokens länger als einen Tag gültig bleiben und möglicherweise auch außerhalb der ursprünglichen Browsersitzung funktionieren können. Die maximale Lebensdauer ist unbekannt. Behandeln Sie sie als undurchsichtige temporäre Weiterleitungen, nicht als permanente IDs. (Von Wettbewerbern gemeldet; hier nicht erneut getestet.)

Verursacht Playwright (oder die Automatisierung) /goto ?

/goto?

Nicht zuverlässig als alleinige Ursache. In von Wettbewerbern gemeldeten Tests trat das Problem /goto sowohl im manuellen Chrome als auch im automatisierten Chromium. Bauen Sie die Regel „Playwright = /goto, Brave = direkt“ in die Produktionslogik ein.

Sind Tokens an Cookies, die IP-Adresse oder die Scraping-Sitzung gebunden?

Branchenberichte beschreiben Tokens, die in einer Umgebung erfasst und später mit einem einfachen HTTP-Client aufgelöst werden könnten. Nützlich für die Trennung von HTML-Abruf und Weiterleitungsauflösung – aber keine Garantie für jede zukünftige Token-Variante. Fehler protokollieren.

Warum nutzt Google /goto ?

/goto?

Google hat Maßnahmen gegen Weiterleitungen als Teil des Schutzes der Suche vor sich weiterentwickelndem Missbrauch dargestellt. Die genaue Auswahllogik ist nicht vollständig öffentlich. Aus Sicht eines Scrapers liegen die Zieladressen nicht mehr immer im Klartext im HTML vor.

200 aber keine organischen Links enthält?

Behandeln Sie sie als unbrauchbaren SERP-Inhalt. Aktivieren Sie render_js=1 , wenn angebracht, bestätige die Ziel-URL und die Ländereinstellung oder wechsle zur strukturierten SERP-API. Verlasse dich niemals allein auf Statuscodes.

Wie sollte ich Ergebnisse für vergleichbare Rankings speichern?

Speichere die Ziele zusammen mit dem Anfrage-Fingerabdruck (q, gl, hl, device, Domain, Offsets, Abrufpfad, Zeitstempel). Dies entspricht bewährten Beobachtungspraktiken und verhindert falsche „Ranking-Änderungen“, die durch unterschiedliche Ländereinstellungen oder Geräte verursacht werden.

Nächste Schritte

  1. Rufen Sie die synchrone Google-Engine auf https://serpapi.webscrapingapi.com/v2 mit api_key, engine=google, und q.
  2. Überprüfen Sie die organischen link Werte in einer Live-Antwort aus Ihrem Konto und notieren Sie das Datum.
  3. Wenn Sie bei HTML bleiben, führen Sie zunächst die Klassifizierung → Duplikatsbereinigung → Auflösung durch, bevor Sie das Keyword-Volumen erweitern.
  4. Überprüfen Sie die Daten zur verantwortungsvollen Webnutzung gemeinsam mit Ihren Datenverantwortlichen.

Beginnen Sie mit der Google Search API, vergleichen Sie SERP-API-Anbieter oder rufen Sie den Seiten-HTML-Code über die Scraper-API bzw. Browser-API ab, wenn strukturierte Ergebnisse nicht ausreichen.

Über den Autor

Suciu Dan, Mitbegründer @ WebScrapingAPI

Suciu Dan

Mitbegründer

Suciu Dan ist Mitbegründer von WebScrapingAPI und verfasst praxisorientierte, auf Entwickler zugeschnittene Anleitungen zu den Themen Web-Scraping mit Python, Web-Scraping mit Ruby und Proxy-Infrastruktur.

Nodriver-Python-Tutorial: Unauffälliges Web-Scraping – vom ersten Skript bis zur Produktion
Die Wissenschaft des Web-Scrapings

Nodriver-Python-Tutorial: Unauffälliges Web-Scraping – vom ersten Skript bis zur Produktion

TL;DR: Kurzfassung: Nodriver ist eine asynchrone Python-Bibliothek, die Chromium über das Chrome DevTools Protocol steuert, ohne Selenium oder chromedriver-Binary. Nutzen Sie sie, wenn ein selbst gehosteter Stealth-Browser, der einer echten Chrome-Sitzung näherkommt, besser passt als ein WebDriver-Stack – aber sie beseitigt IP-, TLS- oder Verhaltensrisiken nicht von allein. Dieses Tutorial führt vom ersten Skript bis zur containerisierten Produktion und einer gehosteten Browser API.

Suciu Dan12 min read
Artikel lesen
HTTP-Antwort-Header in cURL: Jedes Flag, jede Technik und jedes Skripting-Rezept
Die Wissenschaft des Web-Scrapings

HTTP-Antwort-Header in cURL: Jedes Flag, jede Technik und jedes Skripting-Rezept

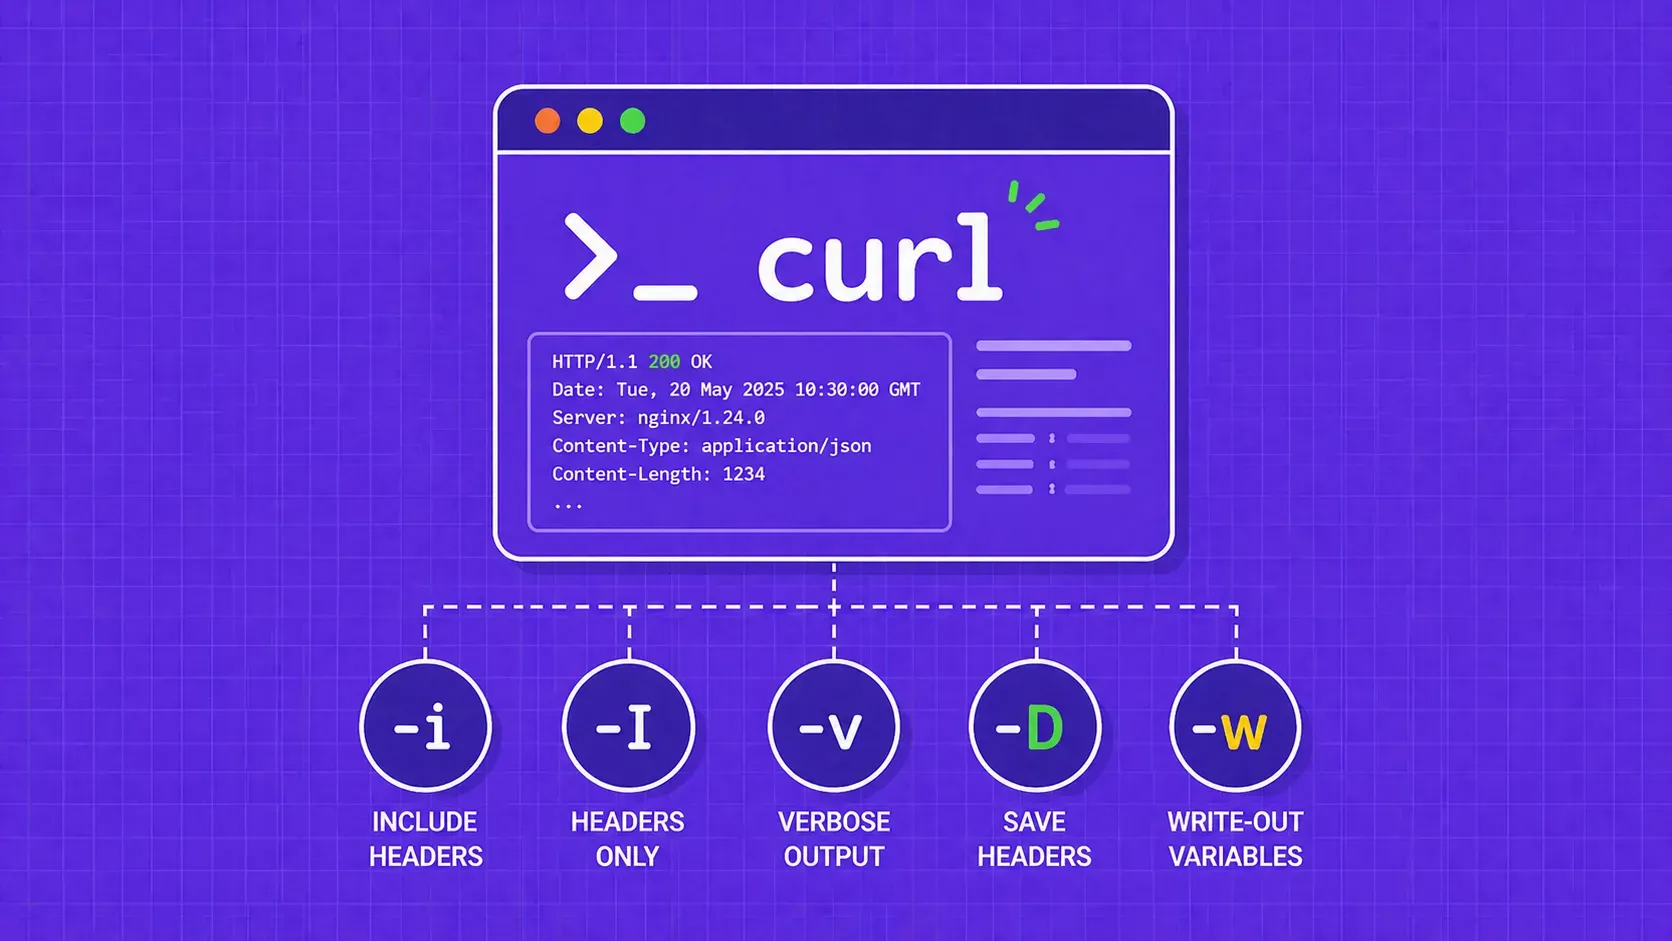
TL;DR: cURL verbirgt standardmäßig Antwort-Header. Verwenden Sie -i, um Header neben dem Body zu sehen, -I für eine HEAD-Anfrage, die nur Header zurückgibt, -v für vollständiges Debugging von Anfrage und Antwort und -D, um Header in einer Datei zu speichern. Für modernes Scripting können Sie mit cURL 7.83+ einzelne Header extrahieren oder mit der Option -w write-out alle Header als JSON ausgeben.

Suciu Dan11 min read
Artikel lesen
Was ist ein Headless Browser? Architektur, Anwendungsfälle und Top-Tools
Die Wissenschaft des Web-Scrapings

Was ist ein Headless Browser? Architektur, Anwendungsfälle und Top-Tools

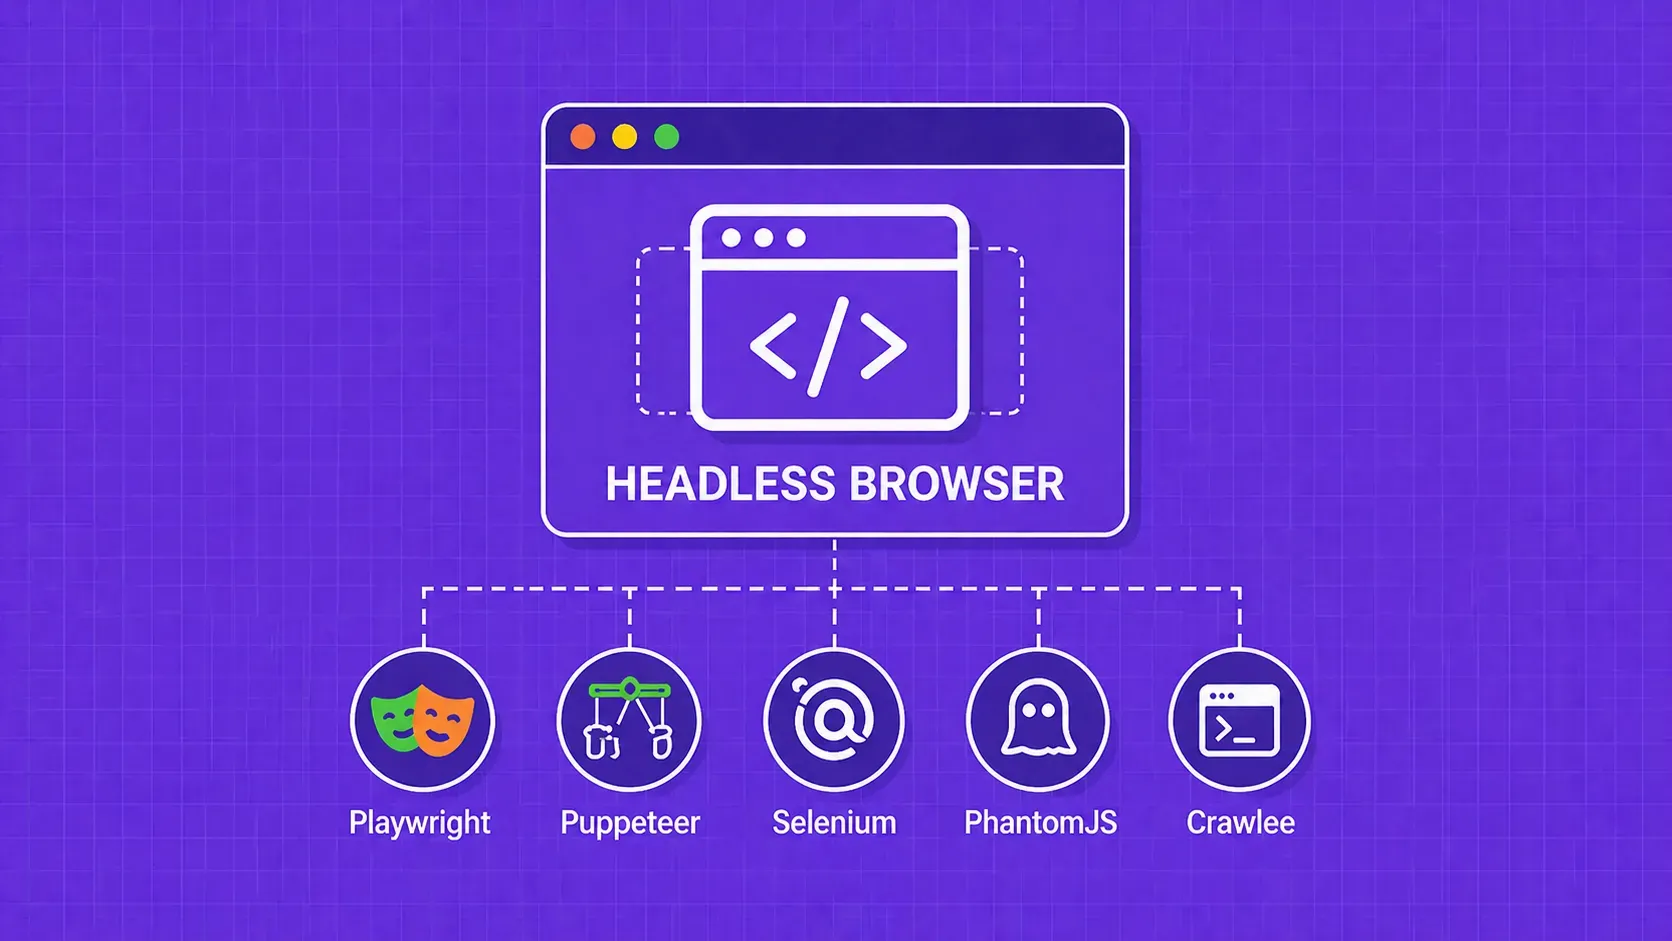
TL;DR: Ein Headless Browser ist ein Webbrowser, der ohne sichtbare grafische Oberfläche läuft und ausschließlich über Code oder Befehlszeilenanweisungen gesteuert wird. Entwickler verwenden Headless-Browser für automatisierte Tests, Web-Scraping, Leistungsüberwachung und zunehmend auch für den Einsatz von KI-Agenten. In diesem Leitfaden erfahren Sie, wie sie intern funktionieren, wann Sie einen solchen Browser einem normalen Browser vorziehen sollten und welche Frameworks Ihre Zeit wert sind.

Suciu Dan12 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.