Zum Inhalt springen

Blog · Artikel

Die Wissenschaft des Web-Scrapings

Eingehende technische Einblicke in die wissenschaftlichen Grundlagen von Crawling, Parsing und Anti-Bot-Systemen sowie in die technischen Herausforderungen der Datenextraktion im Web-Maßstab.

Veröffentlichte Artikel

34

Artikel

Die Wissenschaft des Web-Scrapings

34 Artikel

Nodriver-Python-Tutorial: Unauffälliges Web-Scraping – vom ersten Skript bis zur Produktion
Die Wissenschaft des Web-Scrapings

Nodriver-Python-Tutorial: Unauffälliges Web-Scraping – vom ersten Skript bis zur Produktion

TL;DR: Kurzfassung: Nodriver ist eine asynchrone Python-Bibliothek, die Chromium über das Chrome DevTools Protocol steuert, ohne Selenium oder chromedriver-Binary. Nutzen Sie sie, wenn ein selbst gehosteter Stealth-Browser, der einer echten Chrome-Sitzung näherkommt, besser passt als ein WebDriver-Stack – aber sie beseitigt IP-, TLS- oder Verhaltensrisiken nicht von allein. Dieses Tutorial führt vom ersten Skript bis zur containerisierten Produktion und einer gehosteten Browser API.

Suciu Dan12 min read
Artikel lesen
Umgang mit Google-/goto-Weiterleitungs-URLs und CAES-Token in einem SERP-Scraper
Die Wissenschaft des Web-Scrapings

Umgang mit Google-/goto-Weiterleitungs-URLs und CAES-Token in einem SERP-Scraper

TL;DR: Kurzfassung: Google-/goto-URLs mit CAES-Token und ältere /url-Wrapper sind Weiterleitungsschichten, keine Ziele; ein SERP-Scraper, der jede href als endgültig behandelt, verfälscht Rank-Tracking und Link-Datenbanken. Bevorzugen Sie eine strukturierte SERP-API, wenn sie Ziel-Links liefert. Wenn Sie HTML parsen müssen, klassifizieren Sie jede href, deduplizieren Sie Weiterleitungen und lösen Sie sie mit einem einfachen GET auf. Entschlüsseln Sie CAES nicht.

Suciu Dan11 min read
Artikel lesen
HTTP-Antwort-Header in cURL: Jedes Flag, jede Technik und jedes Skripting-Rezept
Die Wissenschaft des Web-Scrapings

HTTP-Antwort-Header in cURL: Jedes Flag, jede Technik und jedes Skripting-Rezept

TL;DR: cURL verbirgt standardmäßig Antwort-Header. Verwenden Sie -i, um Header neben dem Body zu sehen, -I für eine HEAD-Anfrage, die nur Header zurückgibt, -v für vollständiges Debugging von Anfrage und Antwort und -D, um Header in einer Datei zu speichern. Für modernes Scripting können Sie mit cURL 7.83+ einzelne Header extrahieren oder mit der Option -w write-out alle Header als JSON ausgeben.

Suciu Dan11 min read
Artikel lesen
Was ist ein Headless Browser? Architektur, Anwendungsfälle und Top-Tools
Die Wissenschaft des Web-Scrapings

Was ist ein Headless Browser? Architektur, Anwendungsfälle und Top-Tools

TL;DR: Ein Headless Browser ist ein Webbrowser, der ohne sichtbare grafische Oberfläche läuft und ausschließlich über Code oder Befehlszeilenanweisungen gesteuert wird. Entwickler verwenden Headless-Browser für automatisierte Tests, Web-Scraping, Leistungsüberwachung und zunehmend auch für den Einsatz von KI-Agenten. In diesem Leitfaden erfahren Sie, wie sie intern funktionieren, wann Sie einen solchen Browser einem normalen Browser vorziehen sollten und welche Frameworks Ihre Zeit wert sind.

Suciu Dan12 min read
Artikel lesen
Scrapy gegen Selenium: Wer gewinnt?
Die Wissenschaft des Web-Scrapings

Scrapy gegen Selenium: Wer gewinnt?

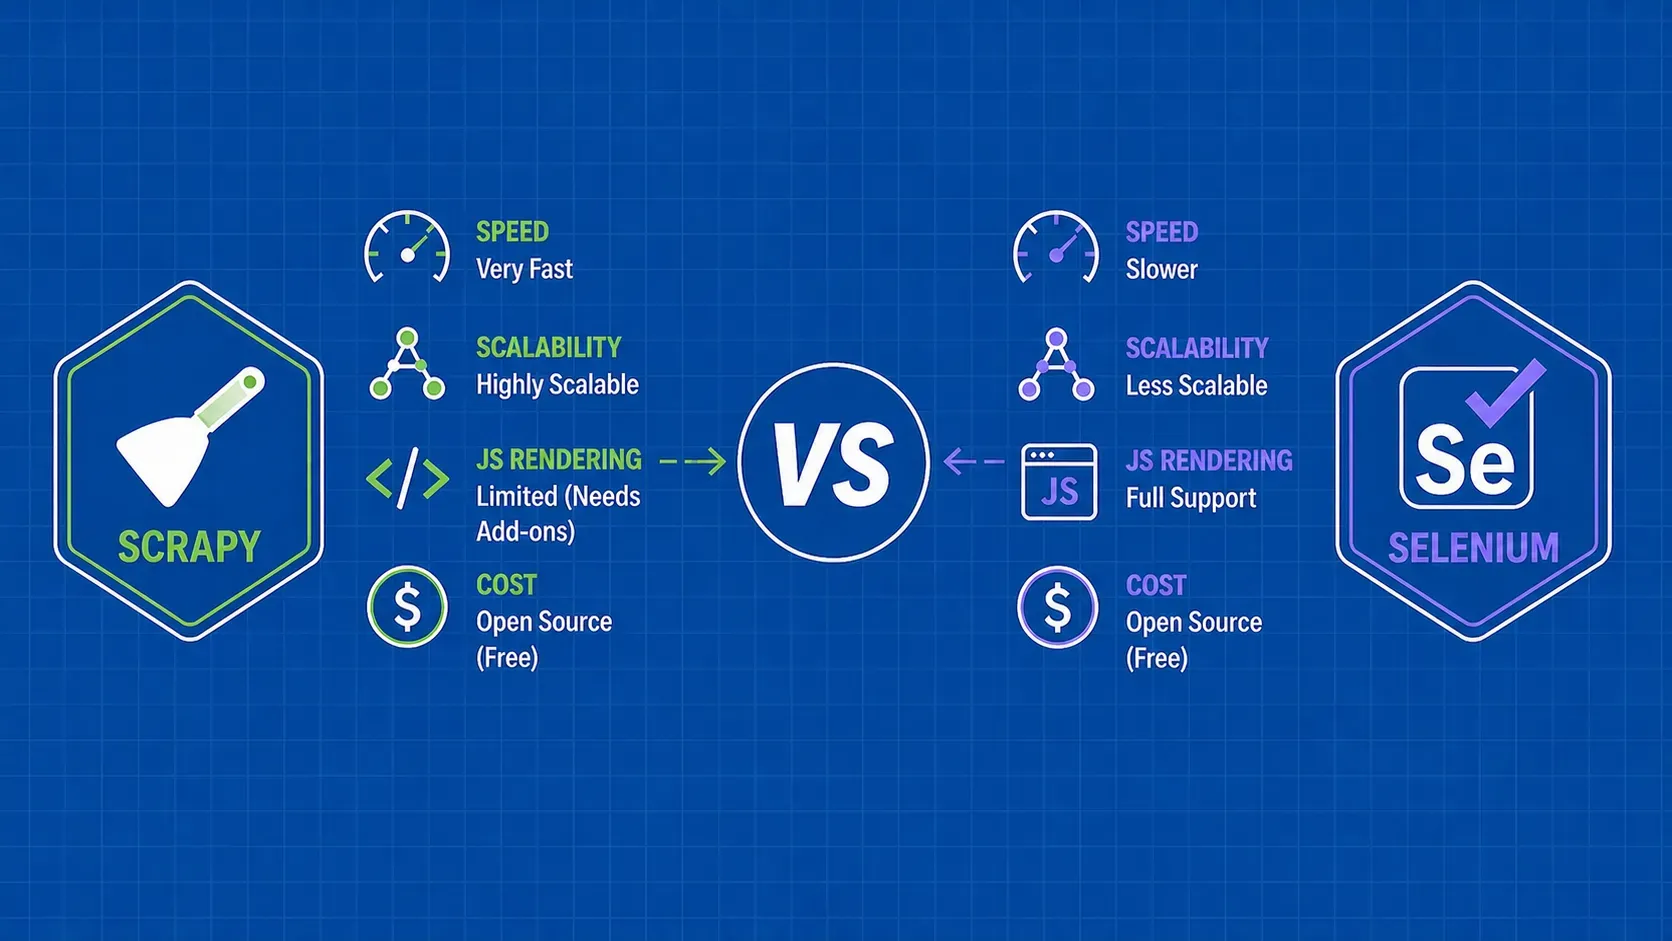
TL;DR: Scrapy ist ein schnelles, asynchrones Crawling-Framework, das für die Extraktion strukturierter Daten aus statischen Seiten in großem Umfang entwickelt wurde. Selenium automatisiert echte Browser und bewältigt JavaScript-lastige Seiten, allerdings mit einem viel höheren Ressourcenaufwand. Für die meisten Scraping-Projekte ist es von Vorteil, wenn man weiß, wann man die beiden Systeme einsetzen oder kombinieren sollte.

Gabriel Cioci9 min read
Artikel lesen
Data Parsing erklärt: Werkzeuge, Techniken & Code (2026)
Die Wissenschaft des Web-Scrapings

Data Parsing erklärt: Werkzeuge, Techniken & Code (2026)

TL;DR: Data Parsing konvertiert rohe Inhalte (HTML, JSON, XML, PDFs) in strukturierte Felder, die Ihr Code tatsächlich nutzen kann. Dieser Leitfaden erläutert Schritt für Schritt, wie Data Parsing funktioniert, vergleicht die wichtigsten Techniken und Bibliotheken und gibt Ihnen einen praktischen Rahmen für die Entscheidung, ob Sie Ihre Parsing-Schicht selbst erstellen oder kaufen sollen.

Suciu Dan14 min read
Artikel lesen
Was ist Browser-Automatisierung? Ein praktischer Leitfaden
Die Wissenschaft des Web-Scrapings

Was ist Browser-Automatisierung? Ein praktischer Leitfaden

TL;DR: Browser-Automatisierung ist die Praxis der Steuerung eines echten oder Headless-Webbrowsers aus dem Code, so dass er in Ihrem Namen klickt, tippt, navigiert und Seiten liest. Dieser Leitfaden erklärt, was Browser-Automatisierung unter der Haube ist, vergleicht Selenium, Playwright, Puppeteer und Cypress und zeigt, wann man nicht nach einem vollständigen Browser greifen sollte.

Ștefan Răcilă10 min read
Artikel lesen
Web Scraping vs. Data Mining: Unterschiede, Pipelines und wann man sie einsetzt
Die Wissenschaft des Web-Scrapings

Web Scraping vs. Data Mining: Unterschiede, Pipelines und wann man sie einsetzt

TL;DR: Web Scraping sammelt Rohdaten von öffentlichen Webseiten. Beim Data Mining werden strukturierte Daten analysiert, um Muster, Vorhersagen und Segmente zu ermitteln. Es handelt sich um verschiedene Phasen desselben Lebenszyklus, und die meisten Produktionssysteme kombinieren sie in einer Pipeline aus Scrapen, Normalisieren und Mining.

Ștefan Răcilă13 min read
Artikel lesen
Beste Web Scraping Kurse für Entwickler
Die Wissenschaft des Web-Scrapings

Beste Web Scraping Kurse für Entwickler

TL;DR: Die besten Web-Scraping-Kurse hängen von Ihrer Sprache, Ihrem Niveau und dem angestrebten Anwendungsfall ab. Dieser Leitfaden vergleicht fünf kostenpflichtige Kurse von Udemy, Coursera, DataCamp und Packt, verweist auf kostenlose Ergänzungen wie offizielle Dokumente und zeigt, wie man vom Abschluss eines Kurses zum Betrieb von Produktions-Scrapern übergeht.

Ștefan Răcilă10 min read
Artikel lesen
10 Fragen zum Scraping, die jedes Datenteam beantworten sollte, bevor es einen Scraper schreibt
Die Wissenschaft des Web-Scrapings

10 Fragen zum Scraping, die jedes Datenteam beantworten sollte, bevor es einen Scraper schreibt

TL;DR: Ein Web-Scraping-Projekt scheitert an der Planung, lange bevor es am Code scheitert. Diese zehn Scraping-Fragen führen Sie durch Legalität, API-Alternativen, Anti-Bot-Verteidigung, Kosten, Aktualisierungskadenz, Datenqualität und Governance, damit Sie den Arbeitsumfang festlegen, den richtigen Stack auswählen und die Fehlermodi vermeiden, die Scraper in der Produktion stillschweigend töten.

Mihai Maxim11 min read
Artikel lesen
die 15 besten Antidetektiv-Browser im Jahr 2026: Ehrlicher Vergleich für Marketer, Scraper und Multi-Account-Manager
Die Wissenschaft des Web-Scrapings

die 15 besten Antidetektiv-Browser im Jahr 2026: Ehrlicher Vergleich für Marketer, Scraper und Multi-Account-Manager

TL;DR: Mit Antidetect-Browsern können Sie mehrere isolierte Browser-Profile ausführen, jedes mit einem eigenen Fingerabdruck, sodass Plattformen Ihre Konten nicht verknüpfen können. In diesem Leitfaden werden die 15 besten Antidetect-Browser des Jahres 2026 in Bezug auf Fingerprint-Qualität, Automatisierungsunterstützung, Preise und Proxy-Integration bewertet. Wir gehen auch darauf ein, wie diese Tools tatsächlich funktionieren, wann eine Scraping-API die klügere Wahl ist und welcher Proxy-Typ für den jeweiligen Anwendungsfall geeignet ist.

Mihnea-Octavian Manolache26 min read
Artikel lesen
Was sind ISP-Proxies? Leitfaden für Web Scraping und Automatisierung
Die Wissenschaft des Web-Scrapings

Was sind ISP-Proxies? Leitfaden für Web Scraping und Automatisierung

TL;DR: Was sind ISP-Proxys? Es handelt sich um statische private IPs, die in einem Rechenzentrum gehostet werden. Die Erkennungssysteme sehen eine private ASN, Sie erhalten einen Datacenter-Durchsatz. Sie sind die richtige Wahl, wenn Sitzungen, Kontobindung und vorhersehbare Preise pro IP wichtiger sind als die reine geografische Reichweite.

Mihnea-Octavian Manolache9 min read
Artikel lesen
HTTP-Header Web Scraping: Nicht mehr blockiert werden
Die Wissenschaft des Web-Scrapings

HTTP-Header Web Scraping: Nicht mehr blockiert werden

TL;DR: HTTP-Header sind in der Regel der Grund, warum Ihr Scraper eine 403 erhält, während Ihr Browser die gleiche URL problemlos lädt. Dieser Leitfaden zeigt, welche Header Anti-Bot-Systeme tatsächlich inspizieren, wie man den Header-Satz eines echten Browsers mit DevTools erfasst, wie man sie in Python und Node.js korrekt sendet und dreht, und wann sich manuelles Tuning nicht mehr lohnt und eine verwaltete Scraping-API der bessere Weg ist.

Raluca Penciuc12 min read
Artikel lesen
Beste rotierende Wohn-Proxys im Jahr 2026 für Web Scraping
Die Wissenschaft des Web-Scrapings

Beste rotierende Wohn-Proxys im Jahr 2026 für Web Scraping

TL;DR: Die besten rotierenden Wohn-Proxys im Jahr 2026 sind nicht diejenigen mit dem größten Billboard-Pool. Es sind diejenigen, deren Sitzungskontrolle, Geo-Targeting, ethische Beschaffung und Pro-GB-Wirtschaftlichkeit tatsächlich zu den von Ihnen gescrapten Zielen passen. Dieser Leitfaden bietet Ihnen einen anbieterneutralen Bewertungsrahmen, eine Vergleichstabelle mit 12 Anbietern und eine Übersicht über die Anwendungsfälle, damit Sie zwei oder drei in die engere Wahl nehmen können, bevor Sie eine Kreditkarte in die Hand nehmen.

Anda Miuțescu35 min read
Artikel lesen
Web Scraping mit Node-Unblocker: Ein praktischer Leitfaden
Die Wissenschaft des Web-Scrapings

Web Scraping mit Node-Unblocker: Ein praktischer Leitfaden

TL;DR: Node-unblocker verwandelt eine Express-Anwendung in einen URL-Präfix-HTTP-Proxy, den man hacken kann. Diese Web-Scraping-Node-Unblocker-Anleitung führt durch die Installation, die Verdrahtung von Request- und Response-Middlewares, die Rotation von Instanzen, die Bereitstellung auf Docker oder Heroku und das Erkennen des Punktes, an dem eine verwaltete Scraping-API die vernünftigere Antwort ist.

Sorin-Gabriel Marica10 min read
Artikel lesen
Was sind rotierende Proxys? Leitfaden zur IP-Rotation für Web Scraping
Die Wissenschaft des Web-Scrapings

Was sind rotierende Proxys? Leitfaden zur IP-Rotation für Web Scraping

TL;DR: Was sind also rotierende Proxys, in einer Zeile? Proxy-Server, die jeder Anfrage aus einem verwalteten Pool eine andere IP zuweisen. Auf diese Weise umgehen Scraper Ratenbeschränkungen pro IP, CAPTCHAs und Geo-Filter. In diesem Leitfaden erfahren Sie, wie die Rotation funktioniert, die vier Pool-Typen, den Einrichtungscode in drei Sprachen und wie Sie einen Anbieter auswählen.

Raluca Penciuc10 min read
Artikel lesen
CSS-Selektoren-Spickzettel – Tipps und Tricks zum Web-Scraping
Die Wissenschaft des Web-Scrapings

CSS-Selektoren-Spickzettel – Tipps und Tricks zum Web-Scraping

TL;DR: Nutze dieses CSS-Selektoren-Spickzettel, wenn du das Web wie ein Profi durchforsten möchtest

Ștefan Răcilă6 min read
Artikel lesen
Wie man einen Python Web Crawler erstellt: Vom Start bis zur Skalierung
Die Wissenschaft des Web-Scrapings

Wie man einen Python Web Crawler erstellt: Vom Start bis zur Skalierung

TL;DR: Ein Python-Web-Crawler automatisiert die mühsame Arbeit der Verfolgung von Links auf einer Website, um Inhalte zu entdecken und zu sammeln. Dieser Leitfaden zeigt Ihnen, wie Sie einen solchen Crawler von Grund auf mit Requests und BeautifulSoup erstellen und dann zu Scrapy für gleichzeitiges Crawling, Element-Pipelines und strukturierte Datenexporte übergehen. Sie werden auch lernen, wie Sie verantwortungsvoll crawlen, Proxies rotieren, um Blockaden zu vermeiden, und mit JavaScript-gerenderten Seiten umgehen.

Suciu Dan27 min read
Artikel lesen
Premium-Proxy-Liste 2026: Die 9 besten kostenpflichtigen Proxy-Dienste im Ranking
Die Wissenschaft des Web-Scrapings

Premium-Proxy-Liste 2026: Die 9 besten kostenpflichtigen Proxy-Dienste im Ranking

TL;DR: Kurzfassung: Für die meisten Scraping-Teams sind Oxylabs und Decodo die stärksten Allround-Premium-Proxy-Dienste, Bright Data passt zu Enterprise-Budgets, und Webshare ist der günstigste Einstieg mit einer statischen Liste. Wählen Sie eine statische Liste, wenn die IPs für die Mietdauer Ihnen gehören sollen, und ein rotierendes Gateway, wenn jede Anfrage oder Sitzung über eine andere IP laufen soll.

Gabriel Cioci23 min read
Artikel lesen
API-Stile: Vergleich von fünf praktischen Integrationsmodellen
Die Wissenschaft des Web-Scrapings

API-Stile: Vergleich von fünf praktischen Integrationsmodellen

TL;DR: Unterscheiden Sie fünf gängige API-Ansätze, ohne dabei Architektur, Protokolle und Bereitstellungsmuster zu vermischen. Vergleichen Sie deren Verträge anhand eines praktischen Katalogszenarios.

Robert Munceanu13 min read
Artikel lesen
Die besten kostenlosen Proxy-Listen für Web-Scraping, nach Rangfolge (2026)
Die Wissenschaft des Web-Scrapings

Die besten kostenlosen Proxy-Listen für Web-Scraping, nach Rangfolge (2026)

TL;DR: Kurzfassung: Die besten kostenlosen Proxy-Listen für Web-Scraping sind die Liste von ProxyScrape für Skripte, die von Geonode für Verfügbarkeit und ASN-Filter und monosans/proxy-list auf GitHub als Klartext-Feed für Pipelines. Behandeln Sie jede Liste als Pool von Kandidaten, denn nur ein kleiner Teil der gelisteten Proxys funktioniert an einem bestimmten Tag, und senden Sie niemals Logins oder Zahlungsseiten über einen kostenlosen Proxy.

Robert Munceanu23 min read
Artikel lesen
Die besten Shared- und Dedicated-Datacenter-Proxys im Jahr 2026
Die Wissenschaft des Web-Scrapings

Die besten Shared- und Dedicated-Datacenter-Proxys im Jahr 2026

TL;DR: Die Preise und Abrechnungsmodelle für Shared-, Semi-Dedicated- und Dedicated-Rechenzentrumsproxys unterscheiden sich so stark voneinander, dass der günstigste Listenpreis oft am Ende am teuersten ist. Dieser Leitfaden vergleicht 11 Anbieter anhand der aktuellen Listenpreise, wählt einen Anbieter pro Aufgabe aus, erläutert die Abrechnung pro IP im Vergleich zur Abrechnung pro GB sowie die Fair-Use-Richtlinien und enthält Python-Skripte zur Kostenschätzung und zur Überprüfung, ob Ihre IPs tatsächlich dediziert sind.

Anda Miuțescu22 min read
Artikel lesen
Web-Scraping vs. Web-Crawling: Ein Leitfaden für Einsteiger
Die Wissenschaft des Web-Scrapings

Web-Scraping vs. Web-Crawling: Ein Leitfaden für Einsteiger

TL;DR: Erfahren Sie, wie Crawler Seiten finden und Scraper nützliche Daten extrahieren. Sehen Sie sich ein Beispiel mit einer Buchhandlung an, vergleichen Sie die Ergebnisse und wählen Sie den passenden Arbeitsablauf für Ihr erstes Projekt aus.

Anda Miuțescu12 min read
Artikel lesen
Die 10 besten mobilen Proxy-Dienste für Web-Scraping
Die Wissenschaft des Web-Scrapings

Die 10 besten mobilen Proxy-Dienste für Web-Scraping

TL;DR: Proxys sind für das Web-Scraping unverzichtbar. Erfahren Sie, wie mobile Proxys Ihr Scraping-Projekt unterstützen und welche Anbieter die besten Online-Proxys bereitstellen.

Sergiu Inizian9 min read
Artikel lesen
Best Practices für Web-Scraping: Ein Leitfaden für den gesamten Lebenszyklus mit Tipps und funktionierendem Code
Die Wissenschaft des Web-Scrapings

Best Practices für Web-Scraping: Ein Leitfaden für den gesamten Lebenszyklus mit Tipps und funktionierendem Code

TL;DR: Bewährte Vorgehensweisen beim Web-Scraping für jede Phase des Scraper-Lebenszyklus: Planen Sie die Daten, halten Sie sich an die „robots.txt“-Datei gemäß der Definition in RFC 9309, legen Sie für jeden Host ein angemessenes Tempo fest und beachten Sie den „Retry-After“-Header, führen Sie eine defensive Datenauswertung durch, validieren Sie jeden Datensatz, überwachen Sie die Läufe, überprüfen Sie den Fortschritt und erfassen Sie die Kosten pro gültigem Datensatz. Zu jeder Phase gibt es ein kurzes, funktionsfähiges Python-Snippet.

Anda Miuțescu30 min read
Artikel lesen
Web Scraping ohne gesperrt zu werden: 2026 Playbook
Die Wissenschaft des Web-Scrapings

Web Scraping ohne gesperrt zu werden: 2026 Playbook

TL;DR: Moderne Blockaden passieren auf vier Ebenen: Netzwerk, Anfragesignatur, Browser und Verhalten. Diagnostizieren Sie zunächst die Ebene mithilfe von Statuscodes und Aufforderungsseiten und beheben Sie sie dann mit der richtigen Kombination aus rotierenden Residential Proxies, Headern in Browserqualität, TLS-Impersonation, Stealth-Browsern und menschenähnlichem Timing. Wenn das Volumen oder die Ausgereiftheit der Anti-Bot-Methode das Selbermachen unwirtschaftlich macht, verlagern Sie die Anforderungsschicht auf eine verwaltete API.

Sergiu Inizian32 min read
Artikel lesen
IP-Blöcke beim Web-Scraping: Diagnose vor einem erneuten Versuch
Die Wissenschaft des Web-Scrapings

IP-Blöcke beim Web-Scraping: Diagnose vor einem erneuten Versuch

TL;DR: Ermitteln Sie die Ursachen für einen fehlgeschlagenen Scrape, bevor Sie eine IP-Sperre verhängen. Diagnostizieren Sie Ratenbeschränkungen, Sitzungsprobleme und Zugriffsverweigerungen und überprüfen Sie anschließend, ob der Betrieb wiederhergestellt wurde.

Anda Miuțescu13 min read
Artikel lesen
Vorteile einer Web-Scraping-API: Was Sie tatsächlich auslagern
Die Wissenschaft des Web-Scrapings

Vorteile einer Web-Scraping-API: Was Sie tatsächlich auslagern

TL;DR: Prüfen Sie, welche Aufgaben eine Scraping-API übernehmen kann und welche weiterhin in Ihrer Verantwortung liegen. Bewerten Sie die Darstellung, die strukturierte Ausgabe, die Wiederherstellung und die Kosten pro nutzbarem Datensatz.

Anda Miuțescu13 min read
Artikel lesen
Die besten Proxies für Web Scraping im Jahr 2026
Die Wissenschaft des Web-Scrapings

Die besten Proxies für Web Scraping im Jahr 2026

TL;DR: Web-Scraping-Proxys sitzen zwischen Ihrem Scraper und der Zielsite, maskieren Ihre IP und ermöglichen es Ihnen, Ratenbeschränkungen, Geo-Walls und Anti-Bot-Abwehrsysteme zu umgehen. Die Wahl des richtigen Typs (Rechenzentrum, Privatanwender, ISP oder Mobilfunkanbieter) und des richtigen Protokolls (HTTP/HTTPS oder SOCKS5, IPv4 oder IPv6) hängt von den Verteidigungsmaßnahmen des Ziels, Ihren geografischen Anforderungen und dem Umfang der einzelnen Seiten ab. Dieser Leitfaden geht auf die Kompromisse ein und endet mit einer herstellerneutralen Checkliste.

Raluca Penciuc12 min read
Artikel lesen
Proxy-Verwaltung für Web-Scraping: Ein praxisorientierter Ansatz
Die Wissenschaft des Web-Scrapings

Proxy-Verwaltung für Web-Scraping: Ein praxisorientierter Ansatz

TL;DR: Gestalten Sie die Proxy-Zuweisung unter Berücksichtigung von Arbeitsanforderungen, Sitzungs-Leases, mehrstufiger Zustandsüberwachung und quellweiten Begrenzungen. Messen Sie akzeptierte Datensätze anstelle von Adressrotationen.

Raluca Penciuc13 min read
Artikel lesen
Die besten Proxys für Web-Scraping im Jahr 2026: Auswahl nach Einsatzzweck und Kosten
Die Wissenschaft des Web-Scrapings

Die besten Proxys für Web-Scraping im Jahr 2026: Auswahl nach Einsatzzweck und Kosten

TL;DR: Kurzfassung: Die besten Proxys für Web-Scraping sind die günstigsten, die Ihr Ziel akzeptiert. Nutzen Sie Rechenzentrums-Proxys für offene Websites in großem Umfang, ISP-Proxys, um eine IP über eingeloggte oder mehrstufige Abläufe zu halten, Residential-Proxys für strengere Websites und Targeting auf Stadtebene und Mobile-Proxys für Mobile-First-Ziele. Wählen Sie zuerst den Typ nach Aufgabe und vergleichen Sie dann Anbieter nach Kosten pro erfolgreicher Anfrage, nicht nach Preis pro GB.

Robert Munceanu23 min read
Artikel lesen
Maßgeschneiderter Scraper vs. Tools zur Datenextraktion: Selbst entwickeln oder kaufen?
Die Wissenschaft des Web-Scrapings

Maßgeschneiderter Scraper vs. Tools zur Datenextraktion: Selbst entwickeln oder kaufen?

TL;DR: Entscheiden Sie anhand eines Datenvertrags, eines Eigentumsvergleichs, eines Gesamtkostenmodells und eines praktischen Pilotprojekts, ob Sie Scraping-Tools selbst entwickeln, kaufen oder kombinieren möchten.

Sergiu Inizian14 min read
Artikel lesen
Die besten Web Scraping Tools des Jahres 2026
Die Wissenschaft des Web-Scrapings

Die besten Web Scraping Tools des Jahres 2026

TL;DR: Die besten Web-Scraping-Tools des Jahres 2026 lassen sich in drei Kategorien einteilen: verwaltete APIs, die Proxys, Headless-Browser und CAPTCHAs hinter einem HTTP-Aufruf verstecken; Open-Source-Frameworks wie Scrapy und Crawlee, die Ihnen die volle Kontrolle geben, wenn Sie sie hosten können; und visuelle Scraper ohne Code für Nicht-Entwickler. Es gibt keinen einzigen Gewinner. Wir vergleichen mehr als 22 Optionen in Bezug auf Preismodelle, JavaScript-Rendering, Anti-Bot-Stärke und ideale Anwendungsfälle, damit Sie zwei oder drei in die engere Wahl nehmen können, um sie mit Ihren tatsächlichen Zielseiten zu testen.

Gabriel Cioci47 min read
Artikel lesen
Was ist Web Scraping? Ein praktischer Leitfaden für Entwickler
Die Wissenschaft des Web-Scrapings

Was ist Web Scraping? Ein praktischer Leitfaden für Entwickler

TL;DR: Web Scraping ist die automatisierte Extraktion von öffentlichen Webdaten in ein strukturiertes Format, das Sie tatsächlich verwenden können, wie z. B. JSON oder eine Tabellenkalkulation. Dieser Leitfaden befasst sich mit der Definition von Web Scraping, der dahinter stehenden Request-and-Parse-Pipeline, dem Einsatz von Teams, dem Tooling-Spektrum von No-Code bis hin zu verwalteten APIs und der Frage, wie man sich auf der richtigen Seite der Anti-Bot-Abwehr und des Gesetzes bewegt.

Sergiu Inizian17 min read
Artikel lesen
Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.