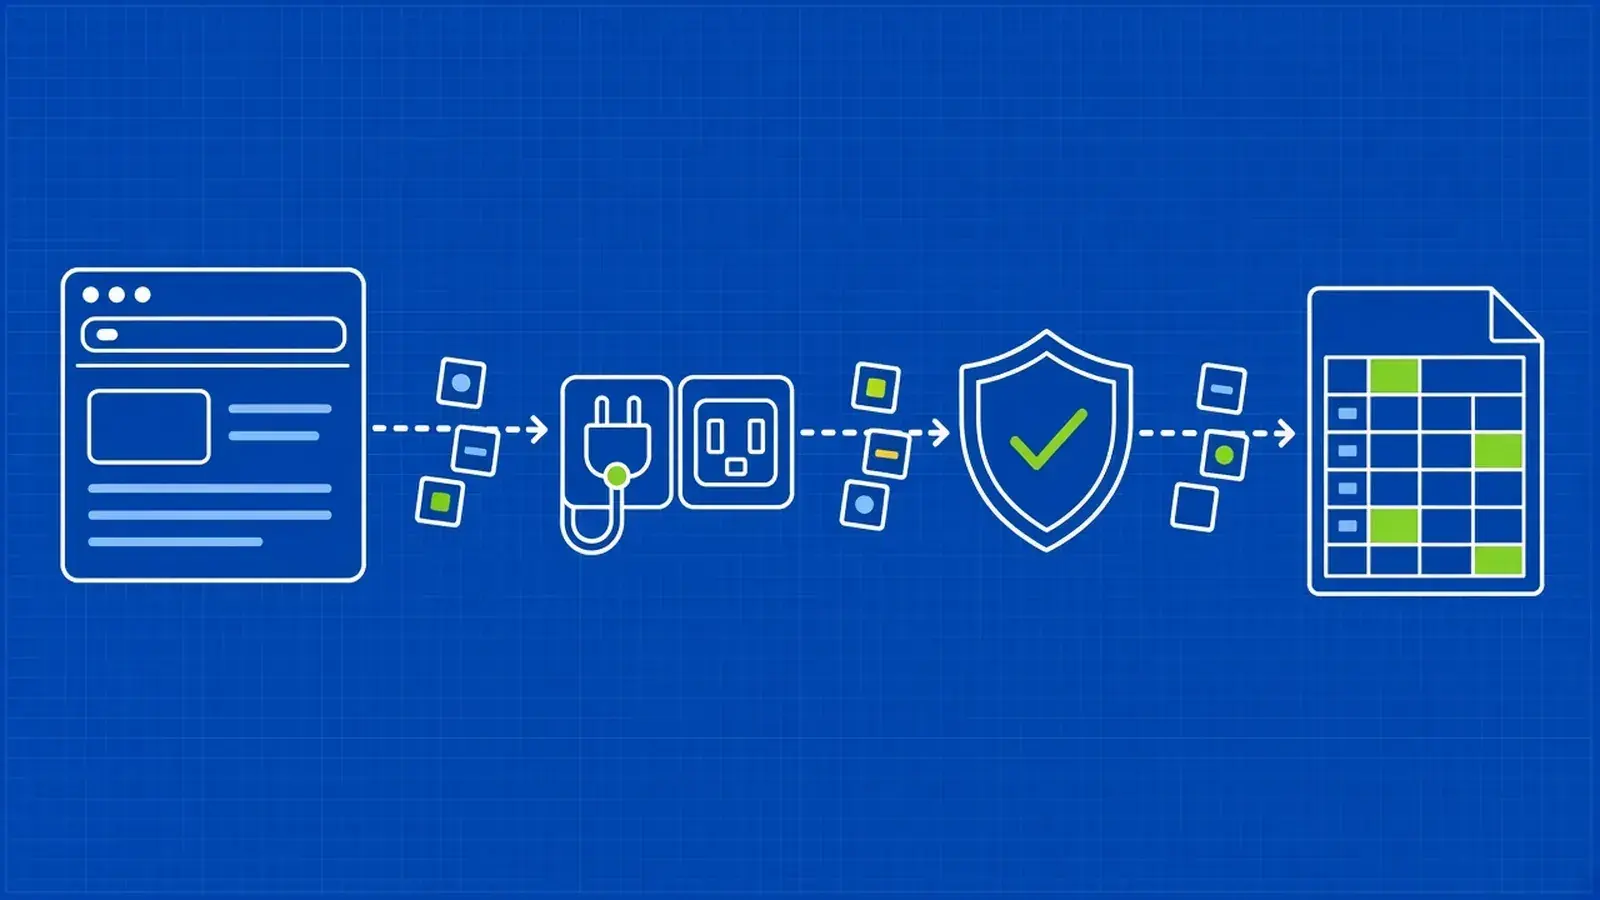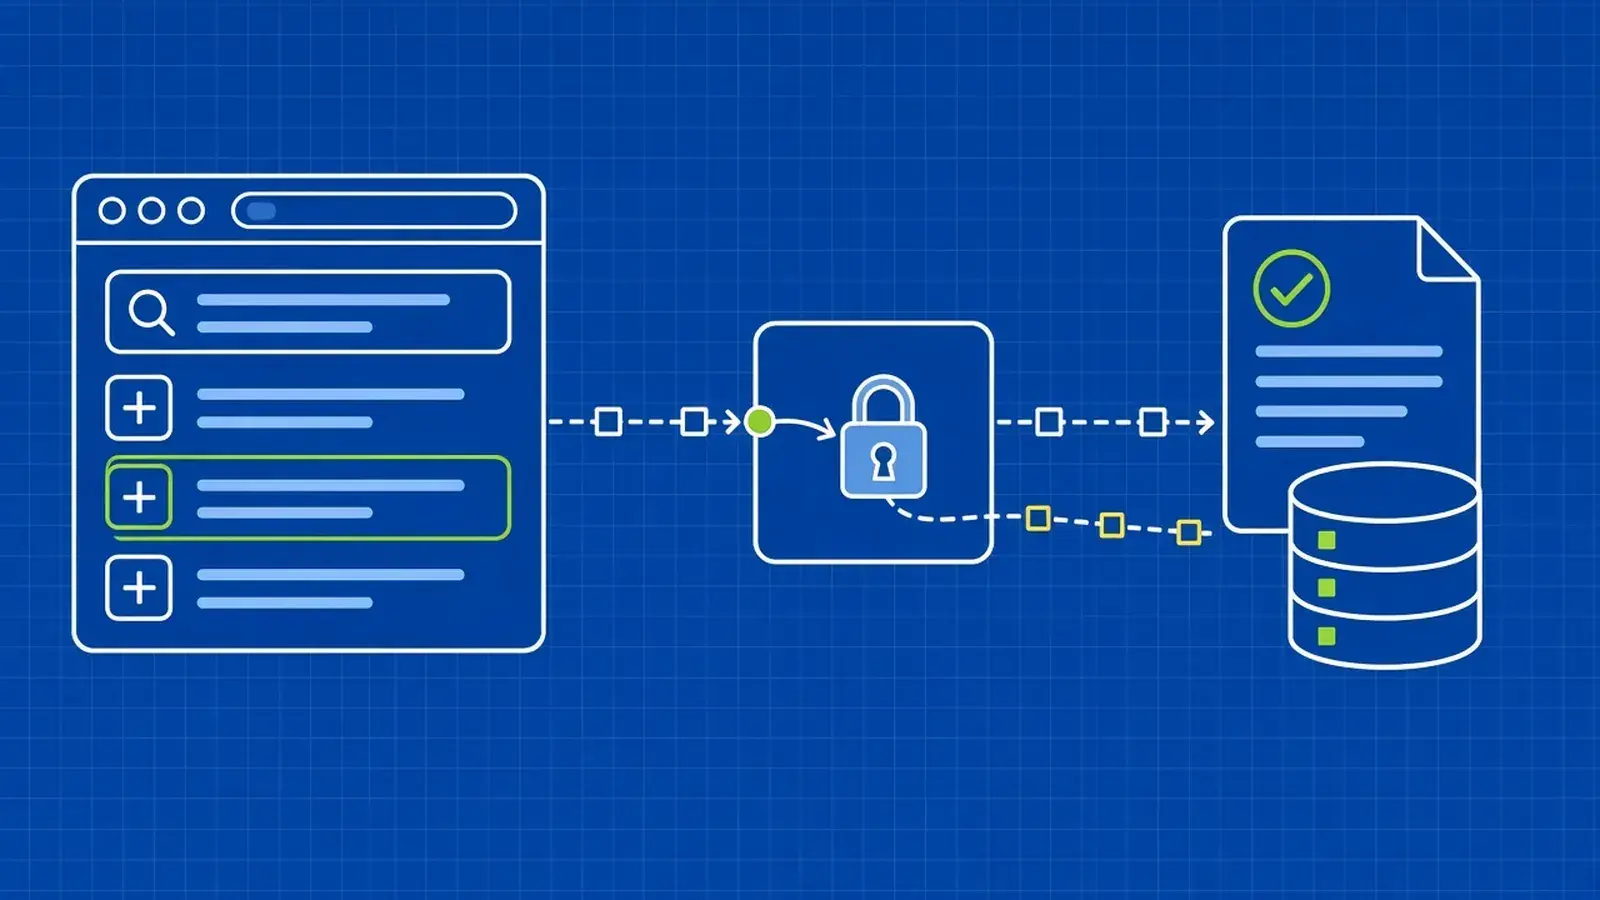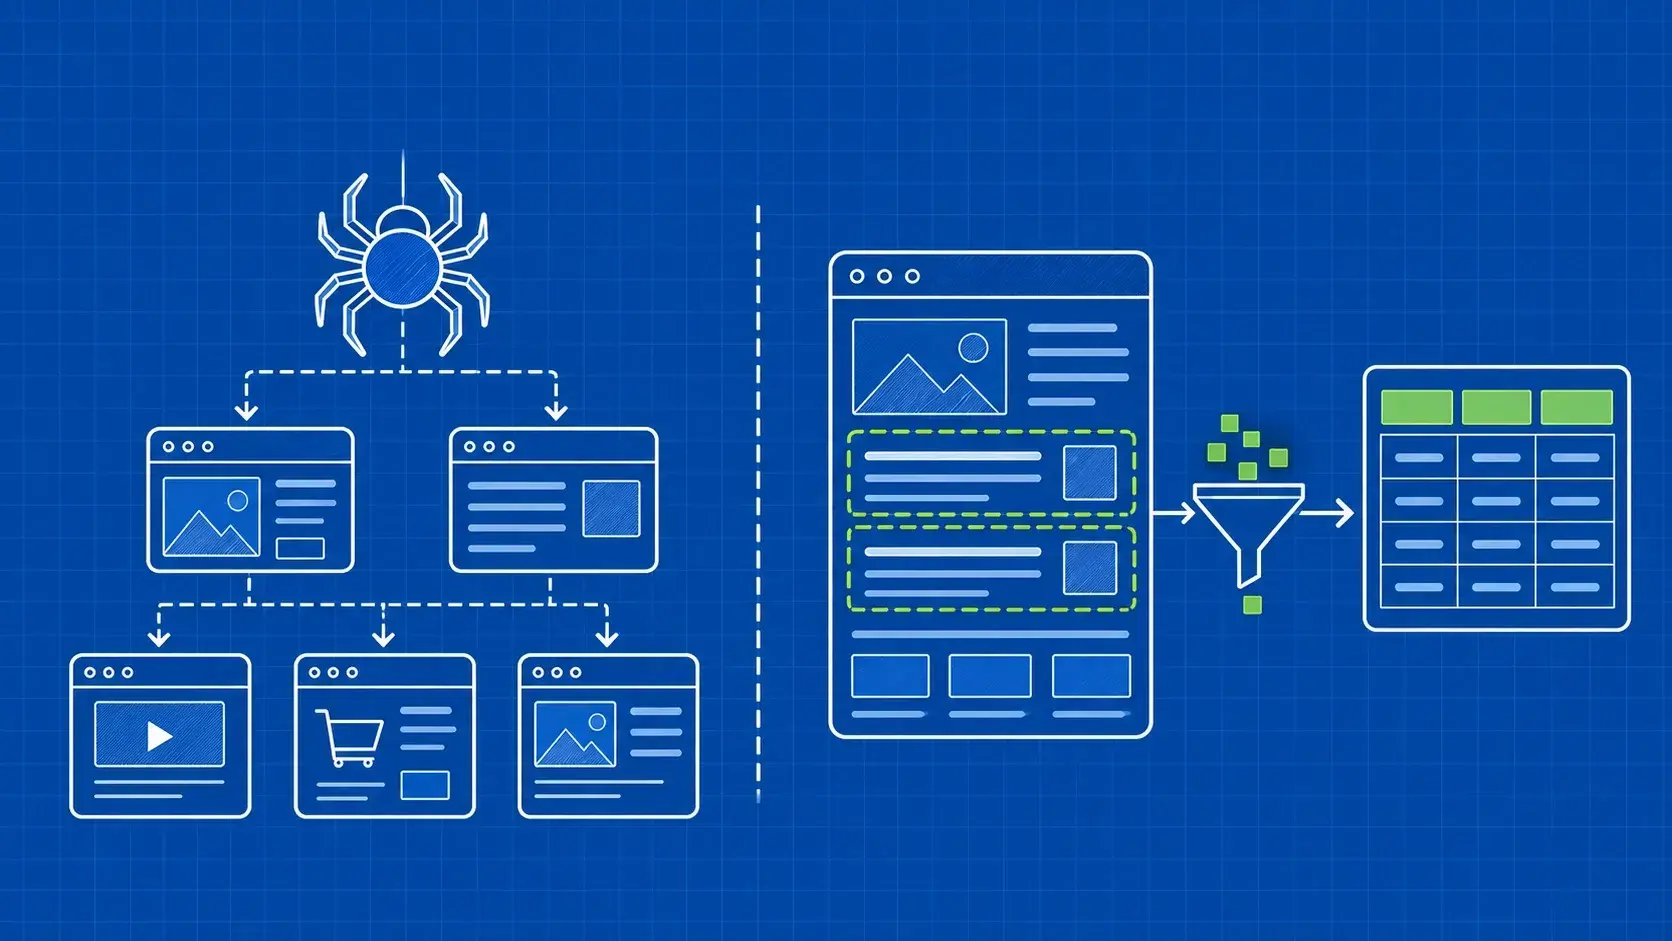
TL;DR: Beim Web-Crawling werden relevante Seiten ermittelt und aufgerufen; beim Web-Scraping werden nützliche Informationen aus deren Inhalten extrahiert. Wenn Sie die URLs bereits haben, können Sie direkt mit der Extraktion beginnen. Wenn Sie Seiten erst finden und deren Daten erfassen müssen, kombinieren Sie beide Aufgaben und überprüfen Sie die Ergebnisse separat.
Der Unterschied zwischen Web-Scraping und Web-Crawling besteht darin, ob Informationen aus Webseiten extrahiert werden oder ermittelt wird, welche Seiten besucht werden sollen. Mit Scraping sammeln Sie Werte wie Buchtitel und Preise; mit Crawling finden Sie die Seiten, die diese enthalten.
Stellen Sie sich vor, Sie benötigen eine Tabelle mit Programmierbüchern, die von einem Online-Shop verkauft werden. Die Kategorieseite bietet Ihnen einen Ausgangspunkt, kann jedoch auf mehrere Ergebnisseiten verweisen. Das Auffinden der Buch-URLs ist eine Aufgabe. Das Auslesen des richtigen Autors und Preises von jeder Buchseite ist eine andere.
Wenn Sie den Unterschied kennen, können Sie zwei frustrierende Ergebnisse vermeiden: eine lange Liste von Links ohne verwertbare Daten oder korrekte Daten von nur wenigen Seiten, während der Rest des Katalogs unberücksichtigt bleibt. Außerdem hilft es Ihnen zu verstehen, was ein Tool tatsächlich leistet, wenn es sich selbst als Scraper, Crawler, Spider oder Datenextraktionsdienst bezeichnet.
Dieser Leitfaden vergleicht die Ergebnisse, erklärt die Funktionsweise und begleitet eine fiktive Buchhandlung vom Auffinden bis hin zu validierten Datensätzen. So erhalten Sie eine praktische Methode, um einen Arbeitsablauf auszuwählen und ihn zunächst an einem kleinen Datensatz zu testen, bevor Sie ihn ausweiten.