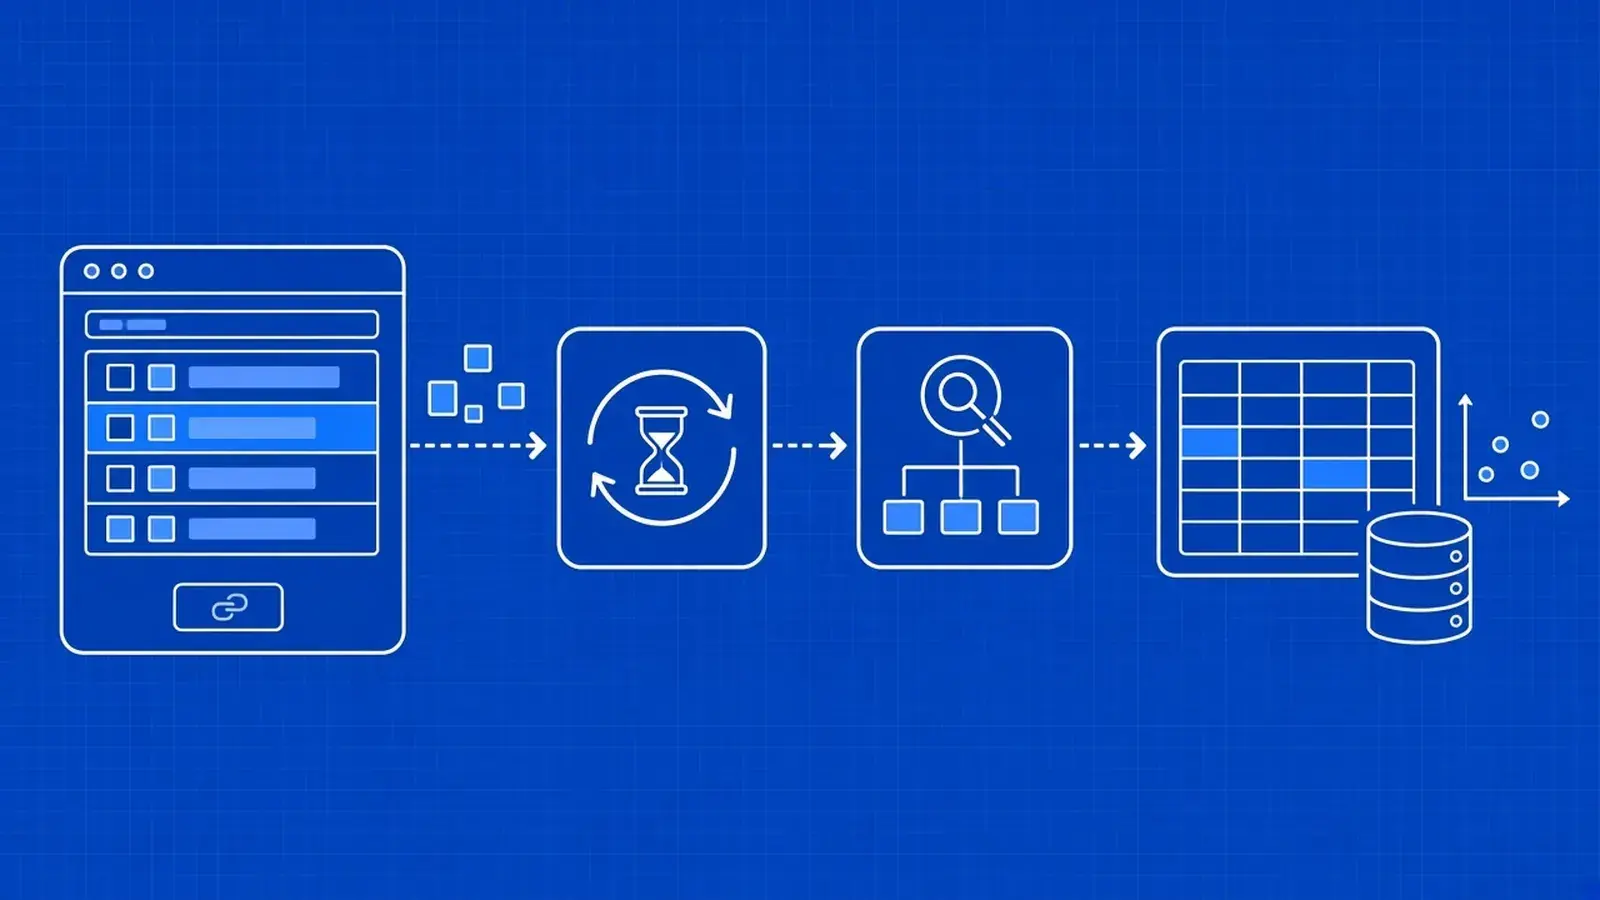
Kurz gesagt: Für Web Scraping mit R parsen Sie HTML mit rvest über CSS-Selektoren oder XPath und laden Seiten mit httr2, inklusive Wiederholungen und Ratenbegrenzung. Für eine einzelne Seite reicht rvest allein; sobald Sie crawlen, laden Sie mit httr2 und parsen mit rvest, und wenn JavaScript die Seite aufbaut, greifen Sie zu read_html_live(). Dieser Leitfaden behandelt Tabellen, Paginierung, Daten in Script-Tags, Scraper-APIs und Offline-Tests.
Die Daten, die Sie brauchen, stehen auf einer Webseite, und Sie möchten sie in einem Tibble haben, ohne R zu verlassen. Web Scraping mit R bringt Sie mit zwei Paketen und dem Tidyverse, das Sie schon kennen, ans Ziel. Neu im Thema? Beginnen Sie mit der Frage, was Web Scraping ist.
Als durchgehendes Beispiel dient Goodreads: die Leserliste „Best Books Ever“ und die Seite zu George Orwells 1984. Sie parsen eine Seite und eine Tabelle mit rvest, crawlen eine paginierte Liste rücksichtsvoll mit httr2, holen Daten, die JavaScript aufbaut, übergeben blockierte Seiten an eine Scraper-API, ohne Ihren Parser zu ändern, testen Ihren Code offline und fassen das Ergebnis zusammen.
Schnellstart
- Installieren:
install.packages(c("rvest", "httr2")) - Laden mit
read_html(), auswählen mithtml_elements(), extrahieren mithtml_text2()oderhtml_attr() read_html_live()für Seiten verwenden, die JavaScript aufbaut- R 4.1 oder neuer für die native Pipe
|>verwenden