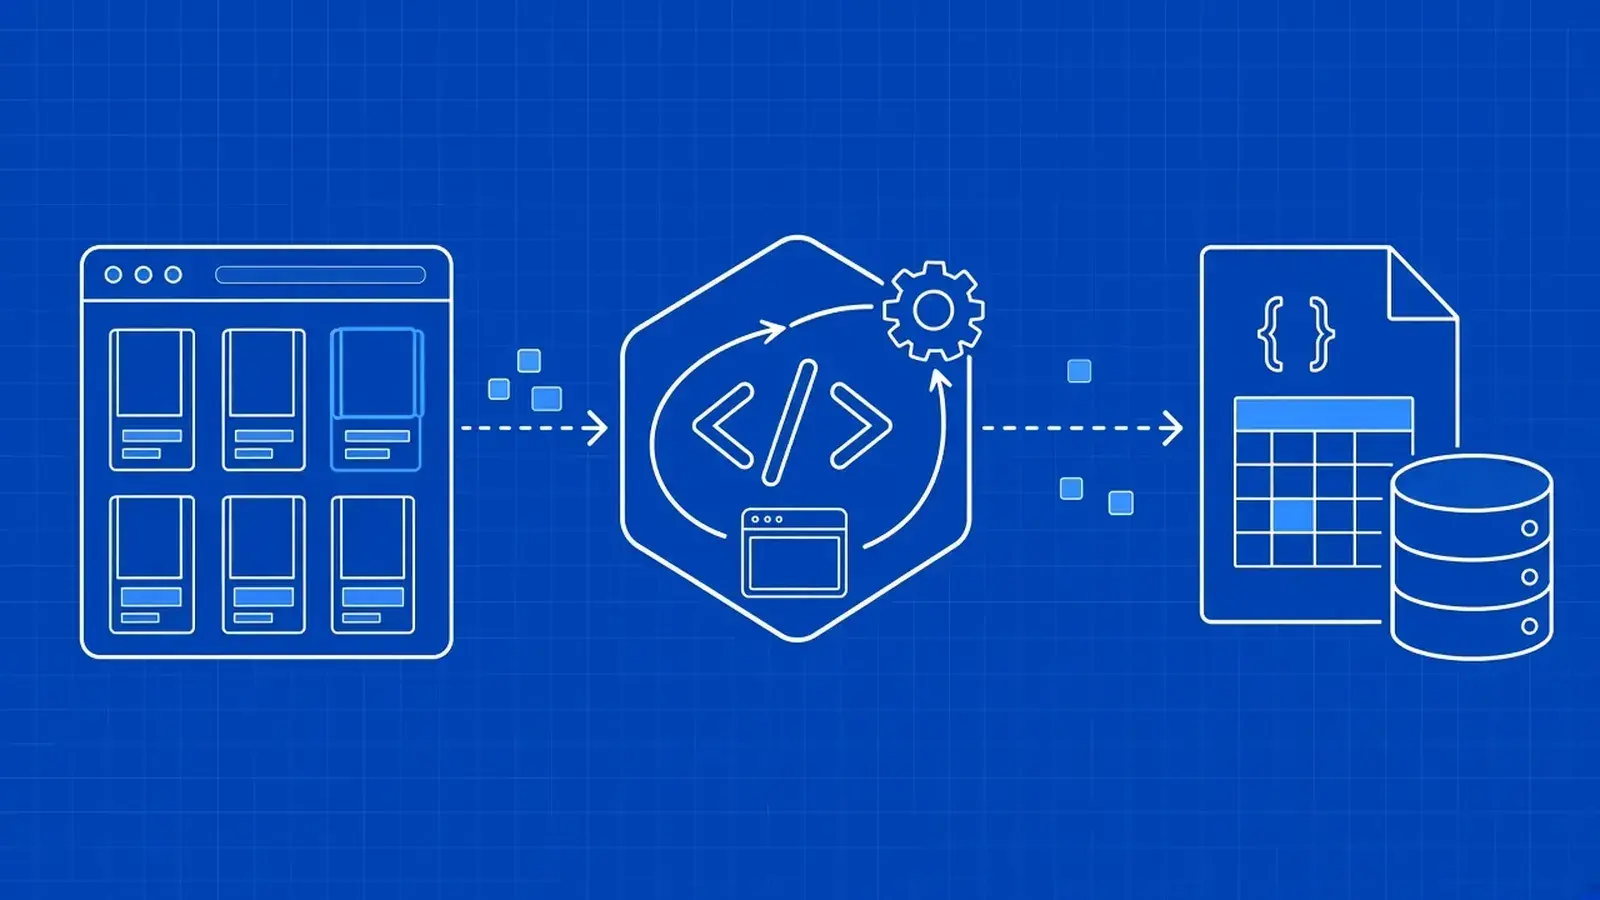
Kurzfassung: Web-Scraping mit JavaScript und Node.js erfordert Node.js 22.12 oder neuer, das integrierte fetch für Anfragen und Cheerio zum Parsen von HTML. Verwenden Sie Cheerio, wenn die Daten im HTML stehen, das Ihre Anfrage erhält, und Playwright, wenn JavaScript die Seite aufbaut oder Klicks und Wartezeiten nötig sind. Dieser Leitfaden baut einen Scraper – von Paginierung und verstecktem JSON bis zu Offline-Tests und einer Scraper-API als Fallback.
Web-Scraping mit JavaScript beginnt mit einer einfachen Aufgabe: Die Daten befinden sich auf einer Webseite, Sie schreiben JavaScript und möchten diese Daten als sauberes JSON erhalten, ohne sich mit Blöcken oder leeren Arrays herumschlagen zu müssen. Falls Ihnen dieses Konzept noch neu ist, lesen Sie zunächst nach, was Web-Scraping überhaupt ist.
Dieser Leitfaden verwendet books.toscrape.com, einen für Scraper entwickelten Übungsbuchladen, als Beispiel. Du wirst eine Seite mit nativem fetch und Cheerio abrufen und auswerten, einen paginierten Katalog behutsam durchforsten, prüfen, ob eine Seite mit JavaScript aufgebaut wird, Seiten mit Playwright rendern und durchklicken, Ihren Parser offline testen und blockierte Seiten an eine Scraper-API weiterleiten, ohne den Parser zu ändern.
Schnellstart
- Verwende Node.js 22.12 oder höher (24 oder 26 LTS empfohlen)
npm install cheeriofür Seiten, deren Daten im HTML-Code enthalten sindnpm install playwrightfür Seiten, die einen echten Browser erfordern- Überprüfen Sie vor dem Crawlen die robots.txt-Datei und die Nutzungsbedingungen der Website