Zum Inhalt springen

Blog · Artikel

Anleitungen

Schritt-für-Schritt-Anleitungen, bewährte Verfahren und praktische Leitfäden für Web-Scraping, Proxy-Verwaltung und Datenextraktion.

Veröffentlichte Artikel

104

Artikel

Anleitungen

104 Artikel

Web-Scraping mit AWS Lambda: Leitfaden für Python und Java 2026
Anleitungen

Web-Scraping mit AWS Lambda: Leitfaden für Python und Java 2026

TL;DR: Kurz gesagt: Web-Scraping mit AWS Lambda funktioniert am besten, wenn jeder Aufruf kurz, begrenzt und unabhängig wiederholbar ist. Beginnen Sie mit direktem HTTP, AWS SAM und S3 und fügen Sie erst dann SQS, Container, Browser-Rendering, Proxys oder eine verwaltete Abrufebene hinzu, wenn sich im Rahmen der Arbeitslast herausstellt, dass diese erforderlich sind.

Suciu Dan26 min read
Artikel lesen
So verwenden Sie GoSpider: Crawlen, URLs bereinigen und Daten extrahieren
Anleitungen

So verwenden Sie GoSpider: Crawlen, URLs bereinigen und Daten extrahieren

TL;DR: GoSpider ist ein Befehlszeilen-Crawler zum Auffinden von URLs, kein vollständiger Scraper für strukturierte Daten. Diese Anleitung zur Verwendung von GoSpider zeigt einen begrenzten Crawl, die saubere Verarbeitung der Ausgabe, die Übergabe von Colly an CSV sowie einen Diagnosepfad für 403-Antworten oder Seiten, die eine JavaScript-Darstellung erfordern.

Suciu Dan20 min read
Artikel lesen
Wie man Redfin scrappt: Python-Leitfaden für Immobiliendaten
Anleitungen

Wie man Redfin scrappt: Python-Leitfaden für Immobiliendaten

TL;DR: Redfin stellt versteckte API-Endpunkte zur Verfügung, die strukturiertes JSON für Immobilienangebote zurückgeben, wodurch das fragile HTML-Parsing vollständig übersprungen werden kann. Diese Anleitung führt Sie durch den Aufbau eines Python-Scrapers, der Miet- und Verkaufsdaten extrahiert, nach Standort sucht, neue Angebote über XML-Sitemaps überwacht und saubere Ergebnisse in CSV oder JSON exportiert.

Suciu Dan11 min read
Artikel lesen
So analysieren Sie JSON in Python: Von API-Antworten bis hin zu in Webseiten verstecktem JSON
Anleitungen

So analysieren Sie JSON in Python: Von API-Antworten bis hin zu in Webseiten verstecktem JSON

TL;DR: JSON in Python mit `json.loads` und `json.load` analysieren, Dekodierungsfehler beheben, verschachtelte Daten validieren, große Dateien streamen und in Webseiten versteckte JSON-LD- oder `__NEXT_DATA__`-Daten extrahieren – sowie WebScrapingAPI-Envelopes.

Suciu Dan12 min read
Artikel lesen
Die 10 besten KI-Web-Scraping-Tools für 2026
Anleitungen

Die 10 besten KI-Web-Scraping-Tools für 2026

TL;DR: Kein einzelner KI-Scraper eignet sich für jede Aufgabe. Vergleichen Sie 11 Tools hinsichtlich Extraktionsmethode, Nutzertyp, Funktionen und Kosten und wählen Sie anhand eines praktischen Testplans das für Sie passende Tool aus.

Suciu Dan20 min read
Artikel lesen
XPath Web Scraping: Ein praktischer Leitfaden mit Python-Beispielen
Anleitungen

XPath Web Scraping: Ein praktischer Leitfaden mit Python-Beispielen

TL;DR: XPath ist eine Abfragesprache zum Navigieren in HTML/XML-Bäumen nach Pfad, Attribut oder Textinhalt. Dieser Leitfaden behandelt XPath-Syntax, Achsen und Funktionen und zeigt dann funktionierende Python-Scraper mit lxml und Selenium. Sie erhalten auch einen konsolidierten Spickzettel und einen Abschnitt zur Fehlerbehebung für die häufigsten XPath-Fehler.

Suciu Dan9 min read
Artikel lesen
Scrapy Playwright Tutorial: JavaScript-lastige Websites in großem Umfang scrapen
Anleitungen

Scrapy Playwright Tutorial: JavaScript-lastige Websites in großem Umfang scrapen

TL;DR: Mit Scrapy-Playwright können Sie JavaScript-lastige Seiten direkt in Scrapy-Spidern rendern, indem Sie echte Chromium-, Firefox- oder WebKit-Browser über Playwright steuern. Dieses Tutorial führt Sie durch Installation, Konfiguration, Seiteninteraktionen, AJAX-Abfang, Anti-Detection und eine produktionsreife Projektstruktur, so dass Sie dynamische Seiten scrapen können, ohne das Scrapy-Ökosystem zu verlassen.

Raluca Penciuc17 min read
Artikel lesen
So scrapen Sie Expedia mit Python: Hotels, Preise und Bewertungen (Leitfaden 2026)
Anleitungen

So scrapen Sie Expedia mit Python: Hotels, Preise und Bewertungen (Leitfaden 2026)

TL;DR: Extrahieren Sie Hotelangebote von Expedia mit Python unter Verwendung von JS-Rendering, Proxys, CSS-Selektoren und Paginierung, bereinigen Sie die Daten anschließend und exportieren Sie sie in eine CSV-Datei.

Mihai Maxim11 min read
Artikel lesen
Leitfaden zur SERP-Scraping-API: Google, Bing, DuckDuckGo, Yandex
Anleitungen

Leitfaden zur SERP-Scraping-API: Google, Bing, DuckDuckGo, Yandex

TL;DR: Senden Sie Ihre erste WebScrapingAPI-SERP-API-Anfrage mit dem Schlüssel in einer Umgebungsvariablen, lokalisieren Sie anschließend die Google-Ergebnisse nach Land, Sprache und Gerät, lesen Sie die JSON-Daten von Google und Bing auf sichere Weise aus, extrahieren Sie die HTML-Daten von DuckDuckGo und Yandex selbst, führen Sie asynchrone Google-Jobs aus, versuchen Sie es anhand der dokumentierten Fehlercodes erneut und wählen Sie einen Tarif anhand der Google-Preise vom Oktober 2026 aus.

Suciu Dan21 min read
Artikel lesen
So nutzen Sie die Amazon Scraper API: Schnellstartanleitung
Anleitungen

So nutzen Sie die Amazon Scraper API: Schnellstartanleitung

TL;DR: Erste Schritte mit der Amazon-Scraper-API von WebScrapingAPI: Senden Sie Ihre erste Anfrage, wählen Sie aus neun Anfragetypen (Produkt, Suche, Bestseller, Angebote, Verkäuferbewertungen und mehr), nutzen Sie 20 Amazon-Marktplätze, analysieren Sie jede JSON-Antwort, behandeln Sie Fehler und Wiederholungsversuche und wählen Sie einen Tarif aus.

Robert Sfichi21 min read
Artikel lesen
Scrapy gegen Beautiful Soup: Welche Python Scraper zu wählen
Anleitungen

Scrapy gegen Beautiful Soup: Welche Python Scraper zu wählen

TL;DR: Scrapy ist ein vollständiges Crawling-Framework, das Anfragen, Parsing und Datenexport in einem Paket behandelt. Beautiful Soup ist eine leichtgewichtige Parsing-Bibliothek, die Sie mit einem HTTP-Client wie Requests kombinieren. Wählen Sie Scrapy, wenn Sie ein umfangreiches, gleichzeitiges Crawling mit integrierten Pipelines benötigen. Wählen Sie Beautiful Soup, wenn Sie ein schnelles, minimales Setup für das Parsen einer Handvoll Seiten benötigen.

Mihnea-Octavian Manolache10 min read
Artikel lesen
Scrapy Splash Tutorial: JavaScript-Seiten rendern
Anleitungen

Scrapy Splash Tutorial: JavaScript-Seiten rendern

TL;DR: Scrapy Splash verbindet die schnelle Crawling-Engine von Scrapy mit dem Headless-Browser Splash, um JavaScript-lastige Seiten zu rendern. Dieses Scrapy-Splash-Tutorial führt Sie durch die Docker-Einrichtung, die Konfiguration des Scrapy-Projekts, die Grundlagen von SplashRequest, Lua-Skripte zum Scrollen und Klicken, die Proxy-Integration und die Behebung der häufigsten Fehler, auf die Sie stoßen werden.

Ștefan Răcilă11 min read
Artikel lesen
Scrapen von Amazon Produktdaten mit Python: Hands-On Anleitung
Anleitungen

Scrapen von Amazon Produktdaten mit Python: Hands-On Anleitung

TL;DR: Amazon-Produktseiten sind vollgepackt mit wertvollen Daten (Preise, Bewertungen, Rezensionen, ASINs), aber um sie zuverlässig zu extrahieren, braucht es mehr als eine einfache HTTP-Anfrage. Dieser Leitfaden führt Sie durch die Erstellung eines Python-Scrapers mit Requests und BeautifulSoup, die Handhabung von Paginierung und Anti-Bot-Verteidigung, den Export nach CSV oder JSON und die Einspeisung der Ergebnisse in LLM-Workflows. Sie werden auch lernen, wann Sie eine Scraping-API verwenden sollten, anstatt Ihre eigene Lösung zu entwickeln.

Raluca Penciuc15 min read
Artikel lesen
Die besten Job Scraping Tools im Jahr 2026: Vergleich & Leitfaden
Anleitungen

Die besten Job Scraping Tools im Jahr 2026: Vergleich & Leitfaden

TL;DR: Job-Scraping-Tools reichen von leichtgewichtigen API-Diensten und Open-Source-Browser-Automatisierung bis zu KI-gestützten Extraktoren und visuellen No-Code-Plattformen. Dieser Leitfaden vergleicht die besten Job-Scraping-Tools für Google Jobs, Indeed, Monster, Upwork und Freelance-Marktplätze und führt Sie dann durch den Aufbau einer zuverlässigen Pipeline mit Deduplizierung, Zeitplanung und Anti-Bot-Behandlung, damit Sie beginnen können, saubere Jobdaten in großem Umfang zu sammeln.

Gabriel Cioci15 min read
Artikel lesen
Umgehung von Cloudflare mit Selenium: 5 Python-Methoden (2026)
Anleitungen

Umgehung von Cloudflare mit Selenium: 5 Python-Methoden (2026)

TL;DR: Cloudflare blockiert Vanilla Selenium durch Fingerprinting des Browsers, Inspektion von Headern und Analyse von Verhaltenssignalen. Dieser Leitfaden führt Sie durch fünf praktische Umgehungsmethoden (Undetected ChromeDriver, Selenium Stealth, SeleniumBase UC mode, CAPTCHA-Solver-Integration und Scraping APIs), komplett mit Python-Code, einer Vergleichstabelle und einem Runbook zur Fehlerbehebung, damit Sie den richtigen Ansatz für Ihren Umfang und Ihr Budget wählen können.

Mihnea-Octavian Manolache16 min read
Artikel lesen
die 7 besten SERP APIs im Jahr 2026: Preise und Funktionen im Vergleich
Anleitungen

die 7 besten SERP APIs im Jahr 2026: Preise und Funktionen im Vergleich

TL;DR: Es gibt keine offizielle Google SERP API, daher füllen Drittanbieter die Lücke. Die Preise reichen von etwa 0,30 bis 15 US-Dollar pro tausend Suchanfragen, und die richtige Wahl hängt von Ihrem Volumen, Budget und den SERP-Funktionen ab, die Sie extrahieren müssen. Dieser Leitfaden vergleicht die wichtigsten Anbieter nebeneinander, schlüsselt die tatsächlichen Kosten auf und gibt Ihnen einen Entscheidungsrahmen, um die beste SERP-API für Ihr Projekt auszuwählen.

Andrei Ogiolan18 min read
Artikel lesen
Wie man den Axios Proxy in Node.js einrichtet: Auth, Rotation, SOCKS5
Anleitungen

Wie man den Axios Proxy in Node.js einrichtet: Auth, Rotation, SOCKS5

TL;DR: Axios leitet Anfragen durch einen Proxy, indem es ein Proxy-Objekt mit Host, Port und optionalen Auth-Feldern akzeptiert. Diese Anleitung behandelt die Einrichtung der Axios-Proxy-Konfiguration von Grund auf: grundlegende Verkabelung, authentifizierte Proxys, HTTPS-Tunneling, ein Rotationssystem mit Interceptoren, SOCKS5 über socks-proxy-agent und die Diagnose von häufigen Fehlern. Jedes Snippet ist kopierbarer Node.js-Code.

Suciu Dan10 min read
Artikel lesen
Puppeteer Download-Datei: 4 Methoden für Node.js
Anleitungen

Puppeteer Download-Datei: 4 Methoden für Node.js

TL;DR: Ein Puppeteer-Dateidownload-Workflow hat vier gute Formen: Klicken Sie auf einen Button und lassen Sie Chrome in einen von Ihnen kontrollierten Ordner schreiben, führen Sie fetch() innerhalb der Seite aus und leiten Sie base64 zurück zu Node, steuern Sie das Chrome DevTools Protocol mit Download-Fortschrittsereignissen oder überspringen Sie den Browser und ziehen Sie die URL mit Axios unter Verwendung von Cookies, die von der Puppeteer-Sitzung gesammelt wurden. Wählen Sie die Dateigröße, die Autorisierung und die Art und Weise, wie die Website den Link offenlegt.

Mihnea-Octavian Manolache35 min read
Artikel lesen
Wie man einen Proxy in Node-Fetch verwendet: Ein praktischer Leitfaden
Anleitungen

Wie man einen Proxy in Node-Fetch verwendet: Ein praktischer Leitfaden

TL;DR: Node-Fetch hat keinen eingebauten Proxy-Switch, so dass Sie einen HTTP-, HTTPS- oder SOCKS5-Agenten über seine Agent-Option in die Anfrage einbinden. Dieser Leitfaden beschreibt die Verwendung eines Proxys in Node-Fetch von Anfang bis Ende: authentifizierte HTTP- und HTTPS-Proxys, SOCKS5, Rotation, Wiederholungen, TLS-Edge Cases, Fehlerbehebung und die moderne undici-Route für Node 18+ Native Fetch.

Mihnea-Octavian Manolache11 min read
Artikel lesen
Web Scraping JavaScript-Tabellen in Python: Von versteckten APIs zu Playwright
Anleitungen

Web Scraping JavaScript-Tabellen in Python: Von versteckten APIs zu Playwright

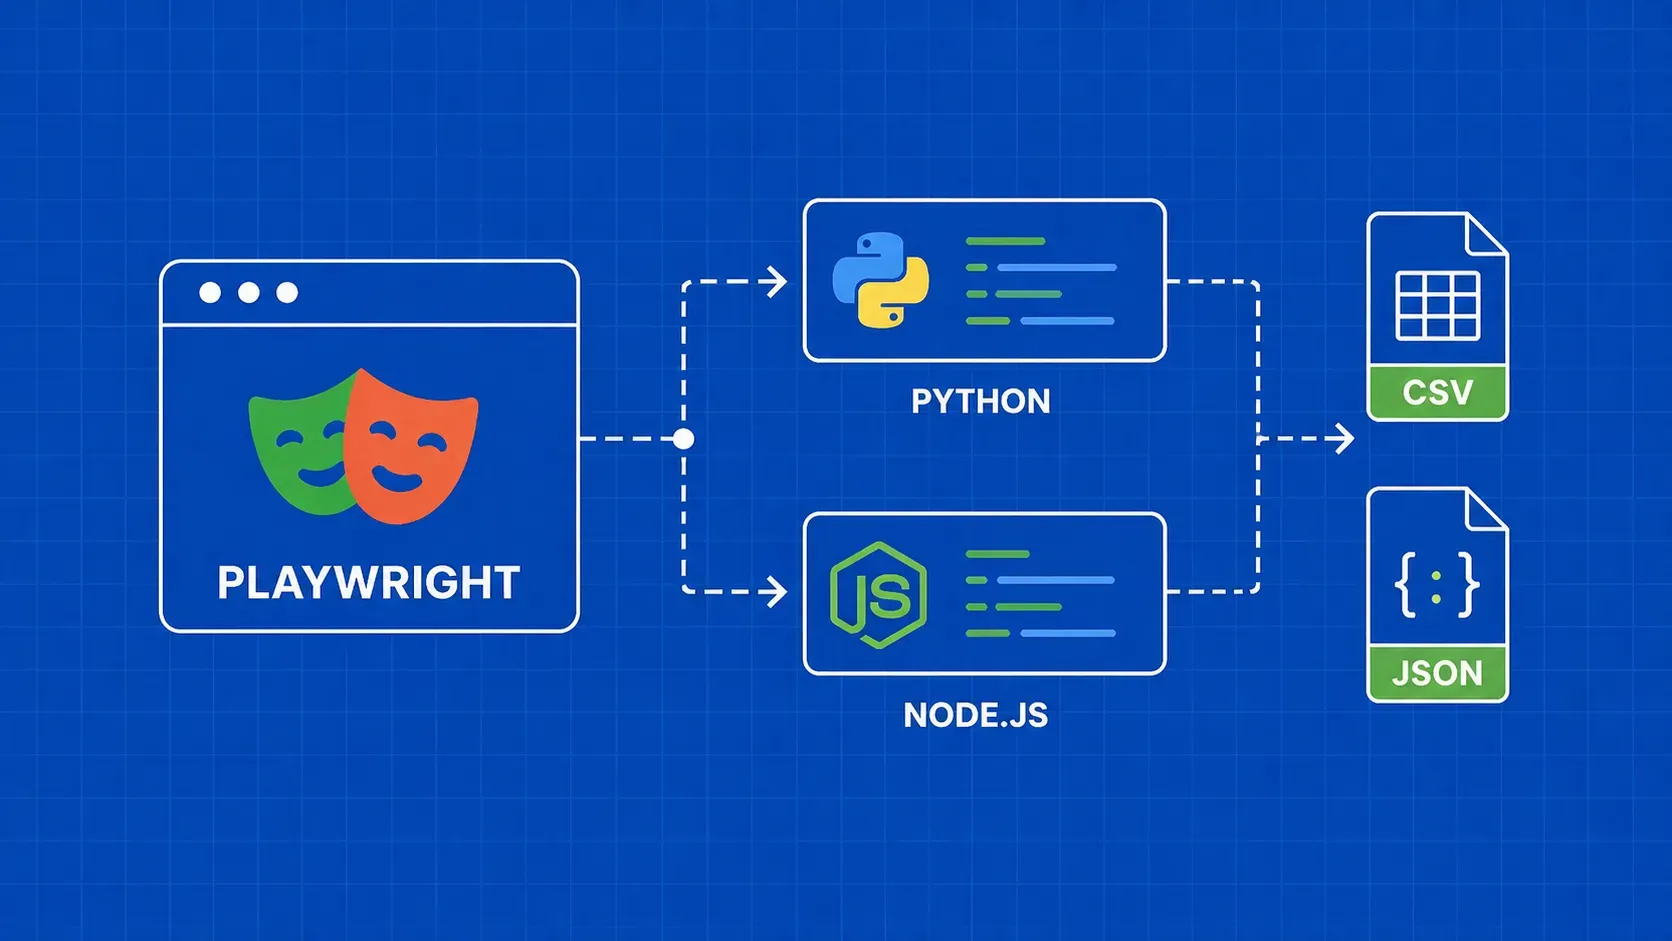
TL;DR: Web-Scraping von JavaScript-Tabellen in Python benötigt selten einen Headless-Browser. Öffnen Sie DevTools, finden Sie den JSON-Endpunkt, der das Raster hydratisiert, spielen Sie es mit Anfragen ab, paginieren Sie es und greifen Sie nur auf Playwright zurück, wenn der Netzwerkaufruf signiert, verschlüsselt oder anderweitig versiegelt ist.

Andrei Ogiolan11 min read
Artikel lesen
Wie man HTML-Tabellen in Golang mit Colly scrappt: End-to-End-Anleitung
Anleitungen

Wie man HTML-Tabellen in Golang mit Colly scrappt: End-to-End-Anleitung

TL;DR: Diese Anleitung zeigt, wie man HTML-Tabellen in Golang von Anfang bis Ende scrapen kann: Wählen Sie zwischen Colly, goquery und golang.org/x/net/html, zielen Sie auf das richtige <tbody>, modellieren Sie Zeilen als typisierte Struktur und exportieren Sie sauberes JSON und CSV. Außerdem erhalten Sie Paginierung, Anti-Block und JavaScript-gerenderte Tabellenmuster.

Andrei Ogiolan11 min read
Artikel lesen
Playwright Web Scraping: Der komplette Leitfaden für Python und Node.js
Anleitungen

Playwright Web Scraping: Der komplette Leitfaden für Python und Node.js

TL;DR: Playwright bietet Ihnen eine vollständige Browser-Automatisierung für das Scraping von JavaScript-lastigen Websites, mit erstklassiger Unterstützung für Python und Node.js. Dieser Leitfaden führt Sie durch die Installation, Element-Extraktion, Proxy-Konfiguration, Anti-Detection, Paginierung, Bild-Downloads und den Export von Daten in CSV oder JSON, alle mit Side-by-Side-Code-Beispiele in beiden Sprachen.

Mihnea-Octavian Manolache13 min read
Artikel lesen
Wie man Google Maps für Bewertungen scrapen kann: Eine praktische Python-Anleitung
Anleitungen

Wie man Google Maps für Bewertungen scrapen kann: Eine praktische Python-Anleitung

TL;DR: Um herauszufinden, wie man Google Maps für Bewertungen scrapen kann, gibt es drei Methoden: einen DIY-Selenium-Scraper hinter einem rotierenden Proxy, eine Scraping-API mit Render-Anweisungen oder eine strukturierte Maps Reviews API, die geparstes JSON zurückgibt. Dieser Leitfaden führt durch alle drei Methoden in Python mit kopierfähigem Code, Paginierungsmustern, Anti-Blockier-Taktiken und einem abschließenden Reinigungsschritt, der rohe Bewertungen in etwas verwandelt, das ein Unternehmen tatsächlich nutzen kann.

Andrei Ogiolan15 min read
Artikel lesen
Webseiten und Dateien mühelos mit Python und wget herunterladen
Anleitungen

Webseiten und Dateien mühelos mit Python und wget herunterladen

TL;DR: Automatisieren Sie das Web-Scraping und das Herunterladen von Dateien mit Python und wget. Erfahren Sie, wie Sie diese Tools nutzen können, um Daten zu sammeln und Zeit zu sparen.

Gabriel Cioci7 min read
Artikel lesen
Wie man Proxies mit Python-Requests verwendet: Von der Basis bis zur Produktion
Anleitungen

Wie man Proxies mit Python-Requests verwendet: Von der Basis bis zur Produktion

TL;DR: Dieser Leitfaden zeigt Ihnen, wie Sie Proxies mit Python Requests von Anfang bis Ende nutzen können: ein funktionierendes Proxies-Dict, authentifizierte URLs, Umgebungsvariablen, Session Reuse, SOCKS5 ohne DNS-Lecks und ein Rotationspool mit Wiederholungen und einem Circuit Breaker. Am Ende werden Sie wissen, wann eine verwaltete API einem DIY-Pool vorzuziehen ist.

Ștefan Răcilă10 min read
Artikel lesen
So extrahieren Sie Ergebnisse aus Google Maps über Web Scraping
Anleitungen

So extrahieren Sie Ergebnisse aus Google Maps über Web Scraping

TL;DR: Erfahren Sie, wie Sie mit unserer API und Node.js Ergebnisse aus Google Maps scrapen können: Schritt-für-Schritt-Anleitung, Vorteile eines professionellen Scrapers und mehr. Rufen Sie ganz einfach die data_id, Koordinaten und den „build“-Parameter ab.

Andrei Ogiolan6 min read
Artikel lesen
Web Scraping mit Regex: Ein praktischer Leitfaden
Anleitungen

Web Scraping mit Regex: Ein praktischer Leitfaden

TL;DR: Web Scraping mit Regex bietet sich an, wenn Sie kurze, vorhersagbare Textmuster (Preise, SKUs, E-Mails, Daten) aus HTML benötigen, dem Sie bereits vertrauen. Kombinieren Sie das re-Modul von Python mit Beautiful Soup, übertragen Sie Ihre Muster auf einen geparsten Knoten statt auf rohes Markup und halten Sie Regex vom Parsen des kompletten HTML-Baums fern. Dieser Leitfaden führt durch einen funktionierenden Titel- und Preis-Scraper, fortgeschrittene Regex-Funktionen und die Fallstricke, die echte Scraper in der Produktion haben.

Mihai Maxim10 min read
Artikel lesen
Von der Stimmungsanalyse bis zum Marketing: Die vielfältigen Vorteile des Web-Scrapings auf Twitter
Anleitungen

Von der Stimmungsanalyse bis zum Marketing: Die vielfältigen Vorteile des Web-Scrapings auf Twitter

TL;DR: Nutzen Sie Twitter-Daten optimal mit professionellem Web-Scraping. Erfahren Sie, wie Sie Twitter für Stimmungsanalysen, Marketing und Business Intelligence nutzen können. Ein umfassender Leitfaden mit TypeScript.

Raluca Penciuc9 min read
Artikel lesen
Wie man einen Proxy mit HttpClient in C# verwendet
Anleitungen

Wie man einen Proxy mit HttpClient in C# verwendet

TL;DR: Um einen Proxy mit HttpClient in C# zu verwenden, erstellen Sie einen WebProxy, fügen Sie es zu einem HttpClientHandler (oder SocketsHttpHandler), und übergeben Sie diesen Handler an den HttpClient-Konstruktor. Für die Produktion, tauschen Sie manuelle Schleifen für IHttpClientFactory, fügen Sie NetworkCredential für authentifizierte Proxys, und wickeln Anrufe in Wiederholungen mit Polly, so dass tote IPs nicht nehmen Sie Ihre Arbeiter nach unten.

Suciu Dan16 min read
Artikel lesen
Wie man HTML-Tabellen mit Python scrappt
Anleitungen

Wie man HTML-Tabellen mit Python scrappt

TL;DR: Die meisten HTML-Tabellen können mit einer einzigen Zeile von pandas.read_html ausgelesen werden. Wenn die Tabelle paginiert ist, mit JavaScript gerendert wurde oder zusammengefasste Kopfzeilen hat, wechseln Sie zu Requests + BeautifulSoup oder einem Headless-Browser wie Playwright. In diesem Leitfaden finden Sie eine Entscheidungsmatrix, Arbeitscode für alle drei Ansätze und die Bereinigungsschritte, die aus den gescrapten Zeilen pipelinefähige Daten machen.

Andrei Ogiolan16 min read
Artikel lesen
Cheerio vs. Puppenspieler: Wie man das richtige Tool auswählt
Anleitungen

Cheerio vs. Puppenspieler: Wie man das richtige Tool auswählt

TL;DR: Cheerio ist ein leichtgewichtiger HTML-Parser; Puppeteer steuert einen echten Chromium-Browser. Verwenden Sie Cheerio, wenn die Daten bereits im rohen HTML sind, Puppeteer, wenn JavaScript sie rendert, und kombinieren Sie sie, wenn eine JS-lastige Seite viele Felder pro Besuch zu extrahieren hat.

Sergiu Inizian8 min read
Artikel lesen
Wie man Realtor.com scrappt: Ein praktischer Leitfaden für 2026
Anleitungen

Wie man Realtor.com scrappt: Ein praktischer Leitfaden für 2026

TL;DR: Wenn Sie herausfinden, wie man Realtor.com sauber scrapen kann, sind drei Dinge am wichtigsten: stabile Selektoren, die ihre gehashten Klassennamen überleben, eine Anforderungsschicht, die Realtors Anti-Bot-Stack überlebt, und Code, der sowohl Listenseiten als auch Detailseiten durchläuft. Diese Anleitung ist der vollständige Python-Build, mit Anti-Block-Taktiken und LLM-fähigen Exporten.

Raluca Penciuc12 min read
Artikel lesen
Web Scraping Booking.com: Hotels, Preise und Bewertungen (2026 Guide)
Anleitungen

Web Scraping Booking.com: Hotels, Preise und Bewertungen (2026 Guide)

TL;DR: Dieser Leitfaden führt durch Web Scraping Booking.com Ende zu Ende in Python: Ziehen Suche Inserate, Hotel-Seiten, Übernachtungspreise und Gästebewertungen. Sie erhalten zwei sich ergänzende Methoden: einen Selenium-Wire-Workflow für JS-gerenderte Seiten und einen schnelleren Weg, der den internen /dml/graphql-Endpunkt von Booking.com direkt aufruft, sowie ein Anti-Block-Playbook, die Behandlung von Währungen und einen Workaround für die Obergrenze von etwa 1.000 Ergebnissen.

Raluca Penciuc13 min read
Artikel lesen
Wie man Daten von Idealista abgreift: Ein Spielbuch für 2026
Anleitungen

Wie man Daten von Idealista abgreift: Ein Spielbuch für 2026

TL;DR: Idealista ist der größte Immobilienmarktplatz in Spanien, Italien und Portugal, aber es sitzt hinter einem ernsthaften Anti-Bot-Stack, der naive Scraper schnell blockiert. Dieser Leitfaden zeigt Ihnen, wie Sie Daten von Idealista durchgängig in Python scrapen können. Er umfasst Site Mapping, Selenium mit undetected-chromedriver, DataDome-Behandlung, Proxy-Rotation und saubere Exporte, mit Produktionshärtung, die Konkurrenten normalerweise überspringen.

Raluca Penciuc14 min read
Artikel lesen
Wie man Yelp mit Python scrappt: Bewertungen, Listen und LLM-fähige Datenpipelines
Anleitungen

Wie man Yelp mit Python scrappt: Bewertungen, Listen und LLM-fähige Datenpipelines

TL;DR: Dieser Leitfaden führt Sie durch den Aufbau einer kompletten Yelp Scraper in Python, Abdeckung Suchergebnisse, Business-Details, und Bewertungen mit Arbeits-Code. Sie werden auch lernen, wie man Anti-Bot-Schutz zu behandeln, exportieren Daten zu CSV oder JSON, und füttern gescrapte Bewertungen in einem LLM für Sentiment-Analyse, etwas, das keine andere Yelp Scraping-Tutorial abdeckt.

Raluca Penciuc13 min read
Artikel lesen
So extrahieren Sie mit Node.js Daten von „Google Shopping“-Anbietern in der Nähe
Anleitungen

So extrahieren Sie mit Node.js Daten von „Google Shopping“-Anbietern in der Nähe

TL;DR: Erfahren Sie, wie Sie mit Node.js und unserer API Anbieter in Ihrer Nähe aus Google Shopping extrahieren können. Mit unserem professionellen Web-Scraper können Sie wertvolle Daten schnell und einfach extrahieren.

Andrei Ogiolan6 min read
Artikel lesen
Puppeteer Formular einreichen: Node.js-Leitfaden für 2026
Anleitungen

Puppeteer Formular einreichen: Node.js-Leitfaden für 2026

TL;DR: Verwenden Sie page.locator(selector).fill(value) für schnelle, deterministische Puppeteer Submit-Formularskripte und page.type(), wenn die Seite auf echte Tastenanschläge wartet (Autocomplete, Anti-Bot, Live-Validierung). Senden Sie durch Klicken auf die Schaltfläche, Drücken der Eingabetaste oder Aufrufen von form.requestSubmit(), und warten Sie immer auf ein konkretes Erfolgssignal anstelle eines festen Timeouts.

Mihnea-Octavian Manolache13 min read
Artikel lesen
Wie man einen Web Scraper mit Pyppeteer erstellt (2026 Anleitung)
Anleitungen

Wie man einen Web Scraper mit Pyppeteer erstellt (2026 Anleitung)

TL;DR: Pyppeteer ist die inoffizielle Python-Portierung von Puppeteer und funktioniert immer noch, um ein echtes Chromium von asyncio zu steuern. In diesem Leitfaden werden Sie es installieren, einen modernen Web-Scraper mit Pyppeteer unter Verwendung von asyncio.run und try/finally schreiben, mit Wartezeiten, Formularen, Screenshots, unendlichem Scrollen, Cookies und Proxys umgehen und lernen, wann Sie zu Playwright, Selenium oder einer gehosteten Scraping-API migrieren sollten.

Mihnea-Octavian Manolache11 min read
Artikel lesen
Wie man Walmart.com scrapen kann: 2026 End-to-End-Anleitung
Anleitungen

Wie man Walmart.com scrapen kann: 2026 End-to-End-Anleitung

TL;DR: Dieser Leitfaden zeigt, wie man Walmart-Produktdaten in Python von Anfang bis Ende scrapen kann, vom Parsen des versteckten __NEXT_DATA__ JSON bis zur Skalierung mit Proxies, Retries und asynchronen Abrufen. Es zieht auch eine ehrliche Linie dafür, wann eine verwaltete Scraper-API DIY schlägt.

Raluca Penciuc12 min read
Artikel lesen
Erfahren Sie, wie Sie mit Node.js Produktspezifikationen aus Google Shopping extrahieren
Anleitungen

Erfahren Sie, wie Sie mit Node.js Produktspezifikationen aus Google Shopping extrahieren

TL;DR: Entdecken Sie die Schritt-für-Schritt-Anleitung zum Web-Scraping von Produktdaten aus Google Shopping mit Node.js. Verbessern Sie Ihre Web-Scraping-Kenntnisse mit diesem Tutorial.

Andrei Ogiolan6 min read
Artikel lesen
So umgehen Sie Cloudflare im Jahr 2026: Tools, Code und Taktiken
Anleitungen

So umgehen Sie Cloudflare im Jahr 2026: Tools, Code und Taktiken

TL;DR: Cloudflare blockiert Scraper, indem TLS-Fingerprinting, JavaScript-Herausforderungen, Verhaltensanalyse und Turnstile CAPTCHAs zu einem zusammengesetzten Vertrauenswert zusammengefügt werden. Um Cloudflare zuverlässig zu umgehen, müssen Sie alle Ebenen gleichzeitig abdecken. Dieser Leitfaden behandelt den Erkennungsstapel, vergleicht vier praktische Tools (Nodriver, SeleniumBase UC, Camoufox, curl-impersonate) und geht auf Proxy-Strategien, Sitzungspersistenz, Fehlerbehebung und Produktionsskalierung ein.

Mihnea-Octavian Manolache13 min read
Artikel lesen
So nutzen Sie Web Stealth Proxy wie ein Profi: Schnellstartanleitung
Anleitungen

So nutzen Sie Web Stealth Proxy wie ein Profi: Schnellstartanleitung

TL;DR: Entdecken Sie mit unserer Schnellstartanleitung, wie Sie Web Stealth Proxy wie ein Profi nutzen. Erhalten Sie Schritt-für-Schritt-Anleitungen, um Ihre Proxy-Nutzung zu optimieren und Ihre Online-Privatsphäre auf ein neues Niveau zu heben. Legen Sie noch heute los!

Mihai Maxim5 min read
Artikel lesen
Wie man YouTube mit Python im Jahr 2026 scrapen kann
Anleitungen

Wie man YouTube mit Python im Jahr 2026 scrapen kann

TL;DR: Dies ist ein 2026 Playbook, wie man YouTube mit Python scrapen kann. Sie wählen die richtige Methode (Daten-API v3, yt-dlp, versteckte /youtubei/v1/-Endpunkte oder einen verwalteten Scraper) anhand einer Entscheidungsmatrix aus und führen dann Code für Video-Metadaten, Kommentare, Kanäle, Suche, Shorts und Transkripte aus, mit einem Produktionsabschnitt über Proxies, Header und 429 Backoff, damit Sie nicht blockiert werden.

Raluca Penciuc17 min read
Artikel lesen
Python Headless Browser-Bibliotheken für Web Scraping im Jahr 2026
Anleitungen

Python Headless Browser-Bibliotheken für Web Scraping im Jahr 2026

TL;DR: Mit einem Python-Browser ohne Kopfhörer können Sie JavaScript rendern, sich durch SPAs klicken und Websites scrapen, die einfache HTTP-Clients nicht erreichen können. Selenium ist der sicherste Standard, Playwright ist die moderne Wahl für neuen Code, Pyppeteer und Splash haben immer noch Nischenanwendungen, und eine gehostete Browser-API ist das, was Sie erreichen, wenn Anti-Bot-Abwehr oder Skala beginnen zu beißen.

Mihnea-Octavian Manolache18 min read
Artikel lesen
Ruby-HTML- und XML-Parser: Ein auf der Arbeitslast basierender Vergleich
Anleitungen

Ruby-HTML- und XML-Parser: Ein auf der Arbeitslast basierender Vergleich

TL;DR: Kurz gesagt: Wählen Sie Ruby-HTML- und XML-Parser je nach Anwendungsfall aus, nicht anhand einer allgemeinen Rangliste. Beginnen Sie mit Nokogiri für das allgemeine Parsen von HTML- und XML-Bäumen, ziehen Sie Ox oder LibXML Ruby für XML-spezifische Aufgaben in Betracht und fügen Sie Selenium nur dann hinzu, wenn ein echter Browser die Seite rendern oder mit ihr interagieren muss.

Raluca Penciuc12 min read
Artikel lesen
Fehler beim Proxy-Status: Diagnose des fehlgeschlagenen Anfrage-Hops
Anleitungen

Fehler beim Proxy-Status: Diagnose des fehlgeschlagenen Anfrage-Hops

TL;DR: Ermitteln Sie den fehlerhaften Hop, bevor Sie eine Proxy-Anfrage erneut versuchen. Nutzen Sie Statuscodes, CONNECT-Ergebnisse und sichere Diagnoseprotokolle, um Proxy-Fehler von Zielantworten zu unterscheiden.

Mihai Maxim14 min read
Artikel lesen
So extrahieren Sie HTML-Tabellen in JavaScript und exportieren saubere CSV-Dateien
Anleitungen

So extrahieren Sie HTML-Tabellen in JavaScript und exportieren saubere CSV-Dateien

TL;DR: Stellen Sie zunächst fest, ob die Tabellenzeilen in der HTTP-Antwort vorhanden sind, über eine Datenanfrage eingehen oder von einem Browser gerendert werden müssen. Verwenden Sie dann das statische Axios- und Cheerio-Skript oder den unten beschriebenen Puppeteer-Ansatz, um HTML-Tabellen in JavaScript zu scrapen, header-gesteuerte Datensätze zu validieren, Seiten zu deduplizieren und CSV-Dateien sicher zu schreiben. Eine HTML-Tabelle organisiert Informationen in Zeilen und Spalten, in der Regel mithilfe der Elemente <table>, <tr>, <th> und <td>. Das Auslesen einer HTML-Tabelle in JavaScript bedeutet, dieses Markup abzurufen oder zu rendern, jede Datenzeile in ein JavaScript-Objekt umzuwandeln, das Ergebnis zu validieren und es in ein Format wie CSV zu serialisieren.

Mihai Maxim13 min read
Artikel lesen
HTML-Parsing in Java mit Jsoup
Anleitungen

HTML-Parsing in Java mit Jsoup

TL;DR: Jsoup ist die Standardbibliothek für HTML-Parsing in Java. Dieser Leitfaden beschreibt den gesamten Lebenszyklus (Maven-Setup, Laden eines Dokuments, CSS-Selektoren, DOM-Traversal, Extraktion, Modifikation und Serialisierung), sowie ein lauffähiges Scraping-Projekt, Fehlerbehandlung, Paginierung und die Grenzen, die Sie in Richtung eines Headless Browsers oder einer Scraping-API drängen.

Mihai Maxim11 min read
Artikel lesen
Python Text aus HTML extrahieren
Anleitungen

Python Text aus HTML extrahieren

TL;DR: Um Text in Python aus HTML zu extrahieren, parsen Sie das Markup mit einem echten Parser (BeautifulSoup, lxml.html oder html-text), entfernen Sie Skripte, Stile und Site-Chrome und normalisieren Sie dann Leerzeichen und Unicode vor dem Speichern. Dieser Leitfaden vergleicht die wichtigsten Bibliotheken, behebt die üblichen Aufräumfallen und endet mit einem lauffähigen Crawler, der JSONL und seitenweise .txt-Dateien schreibt.

Mihai Maxim22 min read
Artikel lesen
Web Scraping mit Scrapy: 2026 Playbook
Anleitungen

Web Scraping mit Scrapy: 2026 Playbook

TL;DR: Dies ist eine meinungsstarke, durchgängige Anleitung zum Web-Scraping mit Scrapy im Jahr 2026. Sie werden Scrapy installieren, Selektoren in der Shell prototypisieren, einen mehrseitigen E-Commerce-Spider bauen, Elemente mit Item Loaders bereinigen, in einer Datenbank persistieren, Einstellungen gegen Verbote abhärten und Scrapy-Playwright für JavaScript-gerenderte Seiten einbinden.

Mihai Maxim15 min read
Artikel lesen
JavaScript mit Scrapy: Daten zuerst, Darstellung nur bei Bedarf
Anleitungen

JavaScript mit Scrapy: Daten zuerst, Darstellung nur bei Bedarf

TL;DR: Kurz gesagt: Für die Verwendung von JavaScript mit Scrapy ist nicht immer ein Browser erforderlich. Überprüfen Sie zunächst die Rohantwort, die Netzwerkanfragen und den Status der eingebetteten Seite; fügen Sie „scrapy-playwright“ nur dann hinzu, wenn die Zieldaten tatsächlich von der Ausführung im Browser abhängen, und steuern Sie anschließend Wartezeiten, Interaktionen, Bereinigung und Parallelität gezielt.

Mihai Maxim11 min read
Artikel lesen
Axios setzt Header im Jahr 2026: Das Entwickler Playbook
Anleitungen

Axios setzt Header im Jahr 2026: Das Entwickler Playbook

TL;DR: Axios setzt Header auf fünf Ebenen: Konfiguration pro Anfrage, globale Standardwerte, axios.create()-Instanzen, Anfrage- und Antwort-Interceptoren und die Antwort selbst. Dieser Leitfaden beschreibt jede Ebene mit lauffähigen v1-Schnipseln und behebt dann die vier Fehler, die jeden beißen: mehrteilige Grenzen, CORS-Cookies, selbstsignierte Zertifikate und Header-Casing.

Mihnea-Octavian Manolache15 min read
Artikel lesen
Web-Scraping mit JavaScript und Node.js: Ein praktischer Leitfaden
Anleitungen

Web-Scraping mit JavaScript und Node.js: Ein praktischer Leitfaden

TL;DR: Web-Scraping mit JavaScript und Node.js: Seiten mit den nativen „fetch“-Funktionen und Cheerio abrufen und analysieren, paginierte Websites auf höfliche Weise crawlen, versteckte JSON-Endpunkte aufrufen, Seiten mit Playwright oder Puppeteer rendern, Ihren Parser offline testen und gesperrte Seiten an eine Scraper-API weiterleiten, ohne diese neu schreiben zu müssen.

Robert Sfichi23 min read
Artikel lesen
Web-Scraping mit Ruby: Von Faraday und Nokogiri bis hin zu Selenium
Anleitungen

Web-Scraping mit Ruby: Von Faraday und Nokogiri bis hin zu Selenium

TL;DR: Beim Web-Scraping mit Ruby werden Webinhalte abgerufen, nützliche Werte in HTML- oder browserrenderten Dokumenten ermittelt und diese Werte mithilfe von Ruby-Code in strukturierte Datensätze umgewandelt. Der am besten wartbare Ansatz besteht darin, den schlanksten Stack zu verwenden, der zuverlässig auf die Daten zugreifen kann.

Raluca Penciuc16 min read
Artikel lesen
Web Scraping mit PHP: Ein praktischer Leitfaden für Bibliotheken, Code und bewährte Praktiken
Anleitungen

Web Scraping mit PHP: Ein praktischer Leitfaden für Bibliotheken, Code und bewährte Praktiken

TL;DR: PHP ist eine perfekt geeignete Sprache für Web-Scraping, dank eingebauter Erweiterungen wie cURL und DOMDocument sowie einem reichhaltigen Composer-Ökosystem, das Guzzle, Symfony DomCrawler und Symfony Panther für Headless Browsing umfasst. Dieser Leitfaden führt Sie durch den gesamten Arbeitsablauf: Abrufen von Seiten, Parsen von HTML, Speichern von Ergebnissen in CSV/JSON/MySQL, Behandlung von Fehlern und Vermeiden von Blockaden.

Sorin-Gabriel Marica16 min read
Artikel lesen
Cheerio Web Scraping in Node.js: load() für einen getesteten Scraper
Anleitungen

Cheerio Web Scraping in Node.js: load() für einen getesteten Scraper

TL;DR: Kurzfassung: Cheerio ist ein schneller HTML-Parser für Node.js mit einer API im jQuery-Stil und eignet sich daher für Web-Scraping, wenn die Daten bereits im rohen HTML der Seite stehen. Nutzen Sie fetch plus Cheerio für statische Seiten, rufen Sie das JSON der Seite direkt ab, wenn sie ihre Daten so lädt, und rendern Sie nur dann mit einem Browser, wenn JavaScript den Inhalt aufbaut. Dieser Leitfaden baut einen getesteten Scraper mit Paginierung, Wiederholungen und JSON- oder CSV-Export.

Raluca Penciuc18 min read
Artikel lesen
XPath Spickzettel für Web Scraping: Syntax, Achsen und echter Code
Anleitungen

XPath Spickzettel für Web Scraping: Syntax, Achsen und echter Code

TL;DR: Dieser XPath-Spickzettel enthält die Syntax, Prädikate, Achsen und Funktionen, die Sie für Web Scraping benötigen, sowie eine CSS-zu-XPath-Übersetzungstabelle und lauffähige Puppeteer- und Scrapy-Beispiele. Verwenden Sie es als Nachschlagewerk, wenn das nächste Mal ein CSS-Selektor auf einer Website, auf die Sie angewiesen sind, nicht funktioniert.

Mihai Maxim13 min read
Artikel lesen
Wie man cURL mit Python im Jahr 2026 verwendet
Anleitungen

Wie man cURL mit Python im Jahr 2026 verwendet

TL;DR: Es gibt drei sinnvolle Möglichkeiten, cURL mit Python zu verwenden: shell out to the curl binary with subprocess, bind to libcurl through PycURL, or skip curl entirely and use the Requests library. Um cURL gut mit Python nutzen zu können, muss man alle drei Möglichkeiten kennen. In diesem Leitfaden finden Sie lauffähige Beispiele für alle drei, eine Übersetzungstabelle für curl-Flags in Python und eine Entscheidungsmatrix, damit Sie gleich beim ersten Mal das richtige Werkzeug auswählen können.

Andrei Ogiolan13 min read
Artikel lesen
Erfahren Sie, wie Sie mit dem NPM-Paket „Node-Fetch“ HTTP-Anfragen in Node.js stellen
Anleitungen

Erfahren Sie, wie Sie mit dem NPM-Paket „Node-Fetch“ HTTP-Anfragen in Node.js stellen

TL;DR: Erfahren Sie, wie Sie mit dem neu veröffentlichten „node-fetch“ HTTP-Anfragen direkt aus Node.js heraus stellen können. „Node-fetch“ entspricht der „fetch“-API in JavaScript.

Sorin-Gabriel Marica8 min read
Artikel lesen
Die 6 besten Python-HTTP-Clients für das Web-Scraping
Anleitungen

Die 6 besten Python-HTTP-Clients für das Web-Scraping

TL;DR: Wählen Sie den richtigen Python-HTTP-Client für Ihren Scraper aus. Vergleichen Sie Requests, HTTPX, aiohttp, urllib3, curl_cffi und Niquests anhand praktischer Beispiele und Tipps zur Zuverlässigkeit.

Mihnea-Octavian Manolache19 min read
Artikel lesen
Wie man LinkedIn im Jahr 2026 scrapen kann: Eine Python-Anleitung
Anleitungen

Wie man LinkedIn im Jahr 2026 scrapen kann: Eine Python-Anleitung

TL;DR: Scraping LinkedIn bedeutet, um eine aggressive Auth Wall, Behavioral Tracking und TLS Fingerprinting zu arbeiten. Dieser Leitfaden enthält einen Entscheidungsbaum für jede einzelne Seite, Python-Muster für Jobs, Profile und Unternehmen (versteckte API, JSON-LD, Selenium, wenn nötig) und eine konsolidierte Anti-Block-Checkliste für 2026.

Suciu Dan12 min read
Artikel lesen
die 12 besten kostenlosen Web Scraping Tools im Jahr 2026: Vergleich
Anleitungen

die 12 besten kostenlosen Web Scraping Tools im Jahr 2026: Vergleich

TL;DR: Die 12 besten kostenlosen Web-Scraping-Tools im Jahr 2026 sind in vier Kategorien unterteilt: verwaltete APIs mit kostenlosen Credits, Open-Source-Frameworks, Browser-Erweiterungen ohne Code und KI-Extraktoren. Wählen Sie zuerst nach Anwendungsfall (einmaliges Scrapen vs. geplante Pipeline) und dann nach Qualifikationsniveau. Die meisten kostenlosen Stufen decken die Evaluierung ab, nicht die Produktion. Sobald Ihre Erfolgsquote unter ~90 % fällt oder Sie mehr Stunden für Blöcke als für Daten aufwenden, ist es an der Zeit, auf eine kostenpflichtige API umzusteigen.

Suciu Dan24 min read
Artikel lesen
Alternativen zur Yahoo Finance-API: Ein Leitfaden für Entwickler
Anleitungen

Alternativen zur Yahoo Finance-API: Ein Leitfaden für Entwickler

TL;DR: Vergleichen Sie Anbieter von dokumentierten Marktdaten und führen Sie anschließend die Migration unter Berücksichtigung der spezifischen Anforderungen hinsichtlich Datenfeed, Zeitzone, Anpassung, Lizenzierung und Validierung durch.

Raluca Penciuc13 min read
Artikel lesen
Ist Web Scraping im Jahr 2026 noch legal? Rahmen für die Einhaltung der Vorschriften
Anleitungen

Ist Web Scraping im Jahr 2026 noch legal? Rahmen für die Einhaltung der Vorschriften

TL;DR: Ist Web Scraping legal? In der Regel ja, aber mit Einschränkungen. Die Rechtmäßigkeit hängt von der Art der Daten, dem Zugriffspfad, den beteiligten Gerichtsbarkeiten und dem Umgang mit dem Output ab. In diesem Leitfaden finden Sie ein direktes Urteil, ein Fünf-Minuten-Framework vor dem Scraping, die wichtigsten Fälle und eine Checkliste, die Sie vor dem Versand abarbeiten können.

Suciu Dan13 min read
Artikel lesen
Die 9 besten Google-Bildersuch-APIs 2022
Anleitungen

Die 9 besten Google-Bildersuch-APIs 2022

TL;DR: Entdecken Sie die 9 besten Tools für die Google-Bildersuche-API zum effizienten Auslesen von Bildern. Erfahren Sie, wie Sie Ihre Bildersuche optimieren und Ihre Datenerfassung mit diesen leistungsstarken APIs verbessern können.

Raluca Penciuc8 min read
Artikel lesen
Wie man Proxies testet: 6 praktische Methoden
Anleitungen

Wie man Proxies testet: 6 praktische Methoden

TL;DR: Schlechte Proxys sind teuer. Sie verbrauchen Bandbreite, lösen Sperren aus und beschädigen stillschweigend die Daten, auf die Ihre Scraper angewiesen sind. Dieser Leitfaden zeigt, wie man Proxys anhand von fünf Gesundheitssignalen (Konnektivität, Exit-IP, Geschwindigkeit, Anonymität und Reputation) mit Ping, Curl, Online-Checkern, IP-Datenbanken und einem wiederverwendbaren Python-Skript testet, das Sie in Ihre CI-Pipeline einbauen können.

Robert Munceanu9 min read
Artikel lesen
Die besten Web-Scraping-APIs im Jahr 2026: 12 im Vergleich nach Einsatzbereich und Kosten
Anleitungen

Die besten Web-Scraping-APIs im Jahr 2026: 12 im Vergleich nach Einsatzbereich und Kosten

TL;DR: Kurzfassung: Die beste Web-Scraping-API hängt von der Aufgabe ab: Eine günstige Seiten-API gewinnt bei statischem HTML, ein Render-Flag oder gehosteter Browser bei JavaScript-lastigen Apps, ein SERP- oder E-Commerce-Endpunkt bei geparsten Datensätzen und eine Markdown-orientierte API bei LLM-Pipelines.

Suciu Dan25 min read
Artikel lesen
webscraper.io im Test: Preise, Limits und wann ein Wechsel sinnvoll ist
Anleitungen

webscraper.io im Test: Preise, Limits und wann ein Wechsel sinnvoll ist

TL;DR: Kurzfassung: Web Scraper von webscraper. io ist eine kostenlose Chrome- und Firefox-Erweiterung plus die kostenpflichtige Web Scraper Cloud und eine solide Wahl für kleine und mittlere wiederkehrende Aufgaben auf gewöhnlichen öffentlichen Websites. Bleiben Sie dabei, wenn wenige Personen eine Handvoll Websites täglich oder wöchentlich aktualisieren und jemand die Selektoren pflegt.

Suciu Dan17 min read
Artikel lesen
HTTP-Cookies: Ein Leitfaden für Entwickler zum Auslesen von Sitzungen
Anleitungen

HTTP-Cookies: Ein Leitfaden für Entwickler zum Auslesen von Sitzungen

TL;DR: Erfahren Sie, wie sich Cookie-Speicher, Browsereinstellungen und die Zuordnung von Sitzungen auf die erfassten Antworten auswirken. Lernen Sie, Authentifizierungsfehler zu diagnostizieren, ohne Anmeldedaten preiszugeben.

Gabriel Cioci12 min read
Artikel lesen
Apps zum Datenscraping: Vier reale Arbeitsabläufe im Vergleich
Anleitungen

Apps zum Datenscraping: Vier reale Arbeitsabläufe im Vergleich

TL;DR: Vergleichen Sie Octoparse, ParseHub, Web Scraper und Apify hinsichtlich Projekteinrichtung, Ausführung, Exportmöglichkeiten und Wartung anhand eines Pilotprojekts, das den gesamten Liefer-Workflow testet.

Mihnea-Octavian Manolache13 min read
Artikel lesen
Automatisiertes Web-Scraping: Erstellen Sie Jobs, die Sie wiederherstellen können
Anleitungen

Automatisiertes Web-Scraping: Erstellen Sie Jobs, die Sie wiederherstellen können

TL;DR: Erstellen Sie geplante Collector-Prozesse mit expliziten Ausführungsidentitäten, begrenzten Wiederholungsversuchen, Validierung und wiederholungssicherer Übermittlung. Erfahren Sie, wie Sie Fehler beheben können, ohne fehlende Daten zu verbergen.

Andrei Ogiolan15 min read
Artikel lesen
Alternativen zu Scrapebox: Fünf Tools für unterschiedliche Aufgaben
Anleitungen

Alternativen zu Scrapebox: Fünf Tools für unterschiedliche Aufgaben

TL;DR: Finden Sie die passende Alternative für Website-Audits, benutzerdefiniertes Crawling, Browser-Interaktionen, visuelle Datenextraktion oder die Bereinigung von Datensätzen und überprüfen Sie die Umstellung anschließend im Rahmen eines Pilotprojekts.

Raluca Penciuc13 min read
Artikel lesen
Tools zum Extrahieren von Inhalten: Wählen Sie nach Textgenauigkeit aus
Anleitungen

Tools zum Extrahieren von Inhalten: Wählen Sie nach Textgenauigkeit aus

TL;DR: Wählen Sie einen Extraktor für Artikel mit unterschiedlichen Layouts oder präzisen Vorlagenregeln aus und testen Sie anschließend die Textgenauigkeit, die Metadaten, die Struktur und die Fehlerbehandlung anhand Ihres eigenen Korpus.

Robert Munceanu13 min read
Artikel lesen
Puppeteer-Alternativen: Top-Tools für Scraping & Testing 2026
Anleitungen

Puppeteer-Alternativen: Top-Tools für Scraping & Testing 2026

TL;DR: Puppeteer ist großartig für die schnelle Chromium-Automatisierung, aber seine Single-Browser-Bindung, ressourcenintensive Skalierung und die fehlende eingebaute Anti-Bot-Unterstützung zwingen viele Teams zu Alternativen. Dieser Leitfaden schlüsselt die stärksten Puppeteer-Alternativen nach Anwendungsfällen auf (Scraping, E2E-Tests, browserübergreifende QA, mobile Anwendungen), gibt Ihnen eine Vergleichstabelle an die Hand und endet mit einem Entscheidungsrahmen, damit Sie das richtige Tool ohne Versuch und Irrtum auswählen können.

Suciu Dan14 min read
Artikel lesen
Screen-Scraping von Websites: Ein praktischer DOM-Workflow
Anleitungen

Screen-Scraping von Websites: Ein praktischer DOM-Workflow

TL;DR: Entwickeln Sie einen Browser-Collector mit expliziter Bereitschaftsanzeige, validierten Datensätzen und zuverlässigen Abbruchbedingungen. Erfahren Sie, wann die DOM-Extraktion gegenüber Screenshots und OCR vorzuziehen ist.

Raluca Penciuc12 min read
Artikel lesen
Alternative zu Charles Proxy: Auswahl nach Debugging-Aufgabe
Anleitungen

Alternative zu Charles Proxy: Auswahl nach Debugging-Aufgabe

TL;DR: Vergleichen Sie mitmproxy, Fiddler Everywhere, HTTP Toolkit und Proxyman anhand verschiedener Debugging-Aufgaben. Überprüfen Sie anhand eines kontrollierten Tests die Erfassung, den Austausch von Beweismaterial und die Bereinigung von Zertifikaten.

Robert Sfichi13 min read
Artikel lesen
Alternative zu import.io: Auswahl nach Daten-Workflow
Anleitungen

Alternative zu import.io: Auswahl nach Daten-Workflow

TL;DR: Vergleichen Sie Octoparse, Browse AI, Apify und Scrapy hinsichtlich der Zuständigkeit für die Datenextraktion und der Anforderungen an die Datenbereitstellung. Erstellen Sie ein Pilotprojekt, mit dem Sie die Vollständigkeit, Aktualität und Migrationsbereitschaft überprüfen.

Ștefan Răcilă14 min read
Artikel lesen
Site Scraper: Erstellen Sie einen Collector, den Sie validieren können
Anleitungen

Site Scraper: Erstellen Sie einen Collector, den Sie validieren können

TL;DR: Entwerfen Sie einen Website-Collector – von der Datensatzdefinition bis zur verifizierten Bereitstellung. Legen Sie den Quellbereich fest, wählen Sie ein Ausführungsmodell aus, validieren Sie die Erfassungen und stellen Sie unvollständige Durchläufe wieder her.

Mihnea-Octavian Manolache14 min read
Artikel lesen
Alternativen zu PhantomJS: Was man jetzt nutzen sollte und wie man migriert
Anleitungen

Alternativen zu PhantomJS: Was man jetzt nutzen sollte und wie man migriert

TL;DR: Die Entwicklung von PhantomJS wurde 2018 eingestellt. Wählen Sie je nach den Funktionen Ihres Skripts einen Ersatz aus, ordnen Sie die PhantomJS-Aufrufe Playwright oder Puppeteer zu und entfernen Sie alte Abhängigkeiten.

Sorin-Gabriel Marica18 min read
Artikel lesen
8 Scrapy-Alternativen für 2026: Auswahl nach Engpässen, Kosten und Risiken
Anleitungen

8 Scrapy-Alternativen für 2026: Auswahl nach Engpässen, Kosten und Risiken

TL;DR: Die richtige Wahl hängt davon ab, ob der Engpass bei Scrapy im Rendering, im Blockieren, in der Sprachkompatibilität oder in den Operationen liegt. Behalten Sie funktionierende Spider nach Möglichkeit bei oder erweitern Sie sie; nutzen Sie Browser-Tools für interaktive Seiten, gehostete Plattformen für Operationen, leichtgewichtige Stacks für begrenzte statische Aufgaben und verwaltete APIs, wenn die Anfrage-Infrastruktur die Einschränkung darstellt. Überprüfen Sie die engere Auswahl anhand eines Kostenmodells und eines repräsentativen Proof-of-Concept.

Mihai Maxim17 min read
Artikel lesen
Alternative zum Web-Scraper: Passen Sie zunächst den Arbeitsablauf an
Anleitungen

Alternative zum Web-Scraper: Passen Sie zunächst den Arbeitsablauf an

TL;DR: Vergleichen Sie Octoparse, Browse AI, Apify und Playwright anhand ihres Erstellungsmodells. Behalten Sie die Navigation, die Identitätserfassung und das Ausführungsverhalten bei, wenn Sie den Web-Scraper ersetzen.

Suciu Dan14 min read
Artikel lesen
Alternative zu WebHarvy: Produktdaten-Workflows vergleichen
Anleitungen

Alternative zu WebHarvy: Produktdaten-Workflows vergleichen

TL;DR: Vergleichen Sie Octoparse, ParseHub, Web Scraper und Apify hinsichtlich der Produkt-Extraktion. Überprüfen Sie Varianten, Angebote, fehlende Artikel und Exporte, bevor Sie WebHarvy ersetzen.

Suciu Dan14 min read
Artikel lesen
Alternative zum Niche Scraper: Wählen Sie bessere Recherchedaten
Anleitungen

Alternative zum Niche Scraper: Wählen Sie bessere Recherchedaten

TL;DR: Vergleichen Sie Alternativen zur Produktrecherche hinsichtlich Aufgabenstellung, Herkunft der Belege und Lieferanforderungen. Erstellen Sie einen wiederholbaren Test, ohne den geschätzten Bedarf mit den nachgewiesenen Verkaufszahlen zu verwechseln.

Mihnea-Octavian Manolache13 min read
Artikel lesen
Beste Alternativen zu Wget: Moderne CLI-Download-Tools im Vergleich
Anleitungen

Beste Alternativen zu Wget: Moderne CLI-Download-Tools im Vergleich

TL;DR: Wget ist zuverlässig, aber in die Jahre gekommen. Wenn Sie parallele Downloads benötigen, nehmen Sie aria2. Für eine breite Protokollabdeckung und Skripting ist curl die erste Wahl. Sie wollen einen einfacheren Workflow für API-Tests? HTTPie (oder sein Rust-Geschwisterchen xh) passt perfekt. Und wenn Sie den nächsten Upgrade-Pfad wünschen, fügt wget2 HTTP/2, Multithreading und ein Plugin-System hinzu, während es die gleichen Befehlsmuster beibehält, die Sie bereits kennen.

Anda Miuțescu10 min read
Artikel lesen
5 Alternativen zu node-fetch im Vergleich: Native Fetch, Axios, Got, Ky und SuperAgent
Anleitungen

5 Alternativen zu node-fetch im Vergleich: Native Fetch, Axios, Got, Ky und SuperAgent

TL;DR: Beginnen Sie bei unterstützten Node.js-Versionen mit dem nativen „Fetch“-Befehl und fügen Sie erst dann eine Abhängigkeit hinzu, wenn diese sinnvollen benutzerdefinierten Code ersetzt. Axios bietet Komfort über verschiedene Laufzeiten hinweg, Got ermöglicht eine tiefgreifendere Node-spezifische Steuerung, Ky verbessert die Handhabung von „Fetch“ und SuperAgent eignet sich für flüssige Formular- und Datei-Workflows. Egal, wofür Sie sich entscheiden: Behalten Sie bei der Migration das Verhalten in Bezug auf Status, Timeout, Wiederholungsversuche, Cookies und Streams bei.

Raluca Penciuc14 min read
Artikel lesen
Wie Web-Scraping in R Data Science spannend macht
Anleitungen

Wie Web-Scraping in R Data Science spannend macht

TL;DR: Erfahren Sie, wie Sie Ihr nächstes Projekt mit Web-Scraping in R und rvest in Angriff nehmen können.

Raluca Penciuc8 min read
Artikel lesen
Profit Scraper: Verfügbarkeit prüfen und den Workflow ersetzen
Anleitungen

Profit Scraper: Verfügbarkeit prüfen und den Workflow ersetzen

TL;DR: Überprüfen Sie die aktuelle Service-Identität, bevor Sie alte Empfehlungen von Profit Scraper befolgen. Erstellen Sie einen Ersatz-Workflow für Angebotsdaten, die Recherche von Verkaufspreisen und transparente Kostenannahmen.

Mihai Maxim13 min read
Artikel lesen
Der ultimative Leitfaden für den Einstieg in das Web-Scraping mit Elixir
Anleitungen

Der ultimative Leitfaden für den Einstieg in das Web-Scraping mit Elixir

TL;DR: Dies ist der umfassende Leitfaden zum Web-Scraping mit Elixir. Erfahren Sie, wie Sie einen Web-Scraper mit einer der besten Programmiersprachen für Parallelität erstellen.

Robert Sfichi8 min read
Artikel lesen
Der Einsteigerfreundliche Leitfaden zum Web-Scraping mit Rust
Anleitungen

Der Einsteigerfreundliche Leitfaden zum Web-Scraping mit Rust

TL;DR: Rust ist eine schnelle und speichereffiziente Programmiersprache. Aber wie eignet sie sich für das Web-Scraping? Schau dir diesen einsteigerfreundlichen Leitfaden an und erfahre, wie du damit einen einfachen Web-Scraper erstellen kannst.

Mihai Maxim7 min read
Artikel lesen
Web-Scraping mit Go: Einen zuverlässigen HTML-Scraper erstellen
Anleitungen

Web-Scraping mit Go: Einen zuverlässigen HTML-Scraper erstellen

TL;DR: Erstellen Sie einen Go-Scraper, der Buchdatensätze in JSON extrahiert. Orientieren Sie sich an einem erprobten Beispiel mit goquery und planen Sie anschließend die Paginierung, Colly, die Darstellung im Browser und die Fehlerbehandlung.

Sorin-Gabriel Marica13 min read
Artikel lesen
Octoparse-Alternative: Vergleichen Sie die von Ihnen entwickelten Lösungen
Anleitungen

Octoparse-Alternative: Vergleichen Sie die von Ihnen entwickelten Lösungen

TL;DR: Vergleichen Sie Web Scraper, Browse AI, Apify und Scrapy anhand der verbleibenden Arbeitsleistung. Führen Sie einen kontrollierten Reparaturfähigkeitstest durch und überprüfen Sie die vollständige Lieferung, bevor Sie Octoparse ersetzen.

Gabriel Cioci14 min read
Artikel lesen
Web-Scraping in C# mit HttpClient, AngleSharp und Playwright
Anleitungen

Web-Scraping in C# mit HttpClient, AngleSharp und Playwright

TL;DR: Kurzfassung: Für Web-Scraping in C# starten Sie mit .NET 10, dem integrierten HttpClient zum Herunterladen von Seiten und AngleSharp zum Parsen von HTML mit CSS-Selektoren. Wählen Sie HtmlAgilityPack, wenn Sie XPath bevorzugen oder älteren Code pflegen, und ergänzen Sie Playwright für .NET, wenn JavaScript die Seite aufbaut. Dieser Leitfaden baut einen Scraper mit höflichen Wiederholungen, begrenztem Crawling, CSV- und JSON-Export sowie Offline-Tests.

Sorin-Gabriel Marica27 min read
Artikel lesen
Beste Node.js Web Scraper im Jahr 2026: 6 Bibliotheken im Vergleich
Anleitungen

Beste Node.js Web Scraper im Jahr 2026: 6 Bibliotheken im Vergleich

TL;DR: Die besten Node.js Web Scraper im Jahr 2026 teilen sich in zwei Lager: HTTP-Clients wie Axios und Superagent für statische Seiten und Headless-Browser wie Puppeteer und Playwright für JavaScript-lastige Websites. Wählen Sie nach Arbeitsabläufen aus, nicht nach Beliebtheit, und verlagern Sie das Rendering auf eine verwaltete Scraping-API, sobald die Anti-Bot-Abwehr oder die Skalierung Ihre Entwicklungszeit in Anspruch nehmen.

Suciu Dan10 min read
Artikel lesen
ProxyScrape-Alternative: Wählen Sie den richtigen Ersatz
Anleitungen

ProxyScrape-Alternative: Wählen Sie den richtigen Ersatz

TL;DR: Vergleichen Sie Proxy-Netzwerke und verwaltete Abrufverfahren hinsichtlich ihres Sitzungsverhaltens, der Datenbeschaffung und der Kosten pro akzeptiertem Datensatz. Führen Sie einen kontrollierten Test durch und erstellen Sie einen reversiblen Migrationsplan.

Ștefan Răcilă12 min read
Artikel lesen
7 Axios-Alternativen im Vergleich: für Browser, Node.js und Web-Scraping
Anleitungen

7 Axios-Alternativen im Vergleich: für Browser, Node.js und Web-Scraping

TL;DR: Verwenden Sie natives Fetch für eine Basisversion mit wenigen Abhängigkeiten, Ky für eine benutzerfreundlichere Handhabung von Fetch, Got oder SuperAgent für ein umfangreicheres Client-Verhalten und Alova, wenn der Status der Frontend-Anfragen die eigentliche Anforderung ist. Entscheiden Sie sich nur dann für Puppeteer oder eine verwaltete Scraping-API, wenn Rendering, Interaktion, Proxys oder Anti-Bot-Systeme den gewöhnlichen HTTP-Transport unzureichend machen.

Raluca Penciuc13 min read
Artikel lesen
So extrahieren Sie Daten von eBay-Seiten für Preisanalysen
Anleitungen

So extrahieren Sie Daten von eBay-Seiten für Preisanalysen

TL;DR: Bei neuen Produkten ist es schwierig, den richtigen Preis festzulegen. Nun, es gibt eine Lösung: Sammeln Sie Daten von E-Commerce-Giganten und legen Sie Preise auf der Grundlage klarer Daten fest

Gabriel Cioci4 min read
Artikel lesen
Web Scrape mit Puppeteer und NodeJS 2026 Anleitung
Anleitungen

Web Scrape mit Puppeteer und NodeJS 2026 Anleitung

TL;DR: Puppeteer gibt Ihnen die volle Kontrolle über eine Headless-Chrome-Instanz von Node.js aus und ist damit das Tool der Wahl für das Scraping von JavaScript-gerenderten Seiten. Dieser Leitfaden führt Sie durch die Installation, die selektorbasierte Extraktion, das unendliche Scrollen, die Formularanmeldung, das Abfangen von Anfragen, Stealth-Plugins, den Export strukturierter Daten und die Docker-Bereitstellung, damit Sie von einem Spielzeug-Skript zu einem produktionsfähigen Scraper werden.

Gabriel Cioci15 min read
Artikel lesen
BeautifulSoup Anleitung: Bauen Sie einen echten Python Scraper von Grund auf neu
Anleitungen

BeautifulSoup Anleitung: Bauen Sie einen echten Python Scraper von Grund auf neu

TL;DR: Dieses BeautifulSoup-Tutorial führt Sie durch einen kompletten Python-Scraper, von der Pip-Installation bis zu einem gehärteten Skript, das Hacker News paginiert, nach CSV und JSON exportiert und höflich genug bleibt, um nicht blockiert zu werden. Jedes Snippet ist lauffähig, und wir nennen die genauen Momente, in denen BeautifulSoup das falsche Werkzeug ist.

Sorin-Gabriel Marica17 min read
Artikel lesen
Web-Scraping mit Java: Einen zuverlässigen Java-Scraper erstellen
Anleitungen

Web-Scraping mit Java: Einen zuverlässigen Java-Scraper erstellen

TL;DR: Beginnen Sie mit HttpClient und Jsoup, wenn Daten im zurückgegebenen HTML vorhanden sind, rufen Sie bei Bedarf eine öffentlich zugängliche JSON-Quelle auf und fügen Sie Rendering oder Selenium nur für browserabhängige Zustände hinzu. Dieses Java-Tutorial zum Web-Scraping erweitert eine Java-21-Codebasis um Paginierung, begrenzte Parallelität, Wiederholungsversuche, Sitzungen, Validierung und dauerhafte Ausgabe.

Raluca Penciuc28 min read
Artikel lesen
Web Scraping mit Selenium: Python-Schritt-für-Schritt-Tutorial
Anleitungen

Web Scraping mit Selenium: Python-Schritt-für-Schritt-Tutorial

TL;DR: Mit Selenium können Sie JavaScript-lastige Websites scrapen, indem Sie einen echten Browser mit Python-Code steuern. Dieses Tutorial führt Sie durch alle Phasen: Installation von Selenium, Konfiguration von Chrome, Auffinden von und Interaktion mit Elementen, Umgang mit Wartezeiten und Paginierung, Export von sauberen Daten und Skalierung Ihres Scrapers mit Proxies, Selenium Grid und API-basierten Alternativen.

Robert Sfichi27 min read
Artikel lesen
Web-Scraping mit C und C++ unter Verwendung von libcurl und lexbor
Anleitungen

Web-Scraping mit C und C++ unter Verwendung von libcurl und lexbor

TL;DR: Webseiten in C und C++ mit libcurl und lexbor auslesen: Erstellen Sie einen „höflichen“ C++20-Crawler mit CMake und vcpkg, exportieren Sie saubere CSV- und JSON-Dateien, verarbeiten Sie JavaScript-Seiten auf drei verschiedene Arten und führen Sie denselben Scraper in reinem C aus.

Raluca Penciuc25 min read
Artikel lesen
Web-Scraping von Sitemaps: URLs mit sicheren Grenzwerten ermitteln
Anleitungen

Web-Scraping von Sitemaps: URLs mit sicheren Grenzwerten ermitteln

TL;DR: Verwandeln Sie Sitemap-Indizes in eine nachverfolgbare Warteschlange zur URL-Erkennung. Erfahren Sie mehr über namensraumbasiertes Parsing, Protokollbeschränkungen, Hinweise zur Aktualität und sichere Grenzen für nicht vertrauenswürdige URLs.

Robert Munceanu13 min read
Artikel lesen
So verwenden Sie die WebScrapingAPI: Leitfaden zur Scraper-API und zum Web MCP
Anleitungen

So verwenden Sie die WebScrapingAPI: Leitfaden zur Scraper-API und zum Web MCP

TL;DR: Senden Sie Ihre erste WebScrapingAPI-Scraper-API-Anfrage mit dem Schlüssel in einer Umgebungsvariablen und fügen Sie erst dann JavaScript-Rendering, Geotargeting, Extraktionsregeln und asynchrone Jobs hinzu, wenn ein Ziel diese benötigt. Der Leitfaden behandelt alle dokumentierten Fehlercodes, die Kostenverfolgung pro Aufruf, die Tarife ab Oktober 2026, wann stattdessen die Browser-, SERP-, Crawl- oder Data-API gewählt werden sollte und wie KI-Agenten über Web MCP verbunden werden können.

Robert Munceanu24 min read
Artikel lesen
Web-Scraping mit Python im Jahr 2026: Das praktische Handbuch für Entwickler
Anleitungen

Web-Scraping mit Python im Jahr 2026: Das praktische Handbuch für Entwickler

TL;DR: Dies ist ein praxisorientierter Leitfaden zum Web-Scraping mit Python, der mit einem Entscheidungsbaum beginnt und anschließend Requests in Verbindung mit Beautiful Soup, XPath mit lxml, Playwright, Selenium, Scrapy sowie eine Scraping-API für schwierige Ziele behandelt. Am Ende verfügen Sie über funktionierenden Code, ein Handbuch zur Umgehung von Blockierungen, LLM-fähige Speichermuster und eine Checkliste für den produktiven Einsatz.

Raluca Penciuc30 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.