
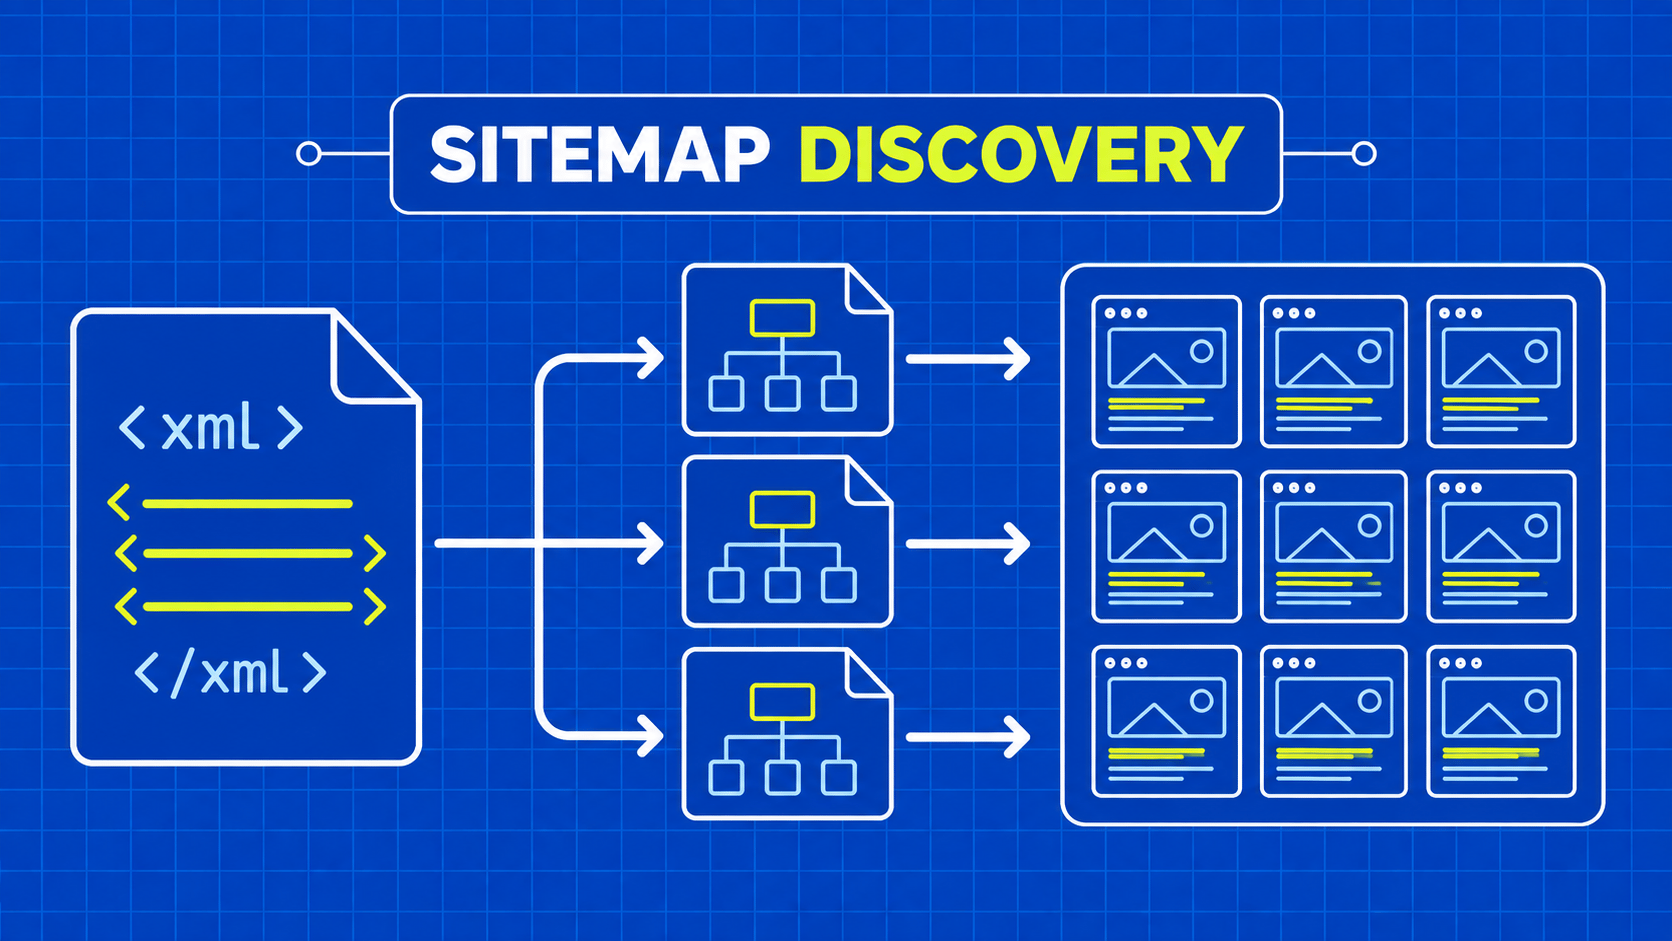
TL;DR: Eine Sitemap dient als Ausgangspunkt für die Erkundung, nicht als vollständiger Datensatz oder als Erlaubnis, jede aufgeführte URL abzurufen. Unterscheiden Sie URL-Mengen von Indizes, analysieren Sie Namespaces sorgfältig, behandeln Sie Metadaten zur Aktualität als Quellenangabe und legen Sie Abgrenzungen für den Abruf fest, bevor Sie Ziele zur Sammelwarteschlange hinzufügen.
Eine Produktkategorie zeigt zwanzig Links an, doch ihre Sitemap listet Tausende von Produktadressen auf. Das Web-Scraping von Sitemaps kann Ihnen helfen, diese größere Kandidatenmenge zu entdecken, ohne jedes Menü durchklicken zu müssen. Der wichtige Unterschied besteht darin, dass eine Sitemap Standorte und begrenzte Metadaten liefert; sie liefert nicht die Produktdatensätze selbst und garantiert auch nicht, dass jede aufgeführte Seite verfügbar ist.
Die Sitemap-basierte Erkennung verändert zudem die Vertrauensgrenze. XML-Dateien und die darin enthaltenen URLs sind externe Eingaben. Ein Parser kann ein Dokument erfolgreich erkennen, während die resultierende Adresse außerhalb Ihres Erfassungsbereichs liegt. Ein Index kann auf viele Dokumente verweisen, und komprimierte Dateien können weit über ihre übertragene Größe hinaus anwachsen.
Dieser Leitfaden trennt die Erkennung, Validierung und Erfassung voneinander. Sie werden die beiden wichtigsten XML-Formate untersuchen, ein lokales Python-Fixture ausführen, Durchsuchungsgrenzen festlegen und entscheiden, wie Sie lastmod , ohne dies als Nachweis für eine Änderung zu betrachten. Die Übung verwendet fiktive Dokumente, die im Speicher gehalten werden, und führt keine Netzwerkanfragen durch. Wenden Sie dieselbe Vorgehensweise auf eine genehmigte Website an, bevor Sie deren erkannte Seiten einer echten Abrufwarteschlange hinzufügen.


