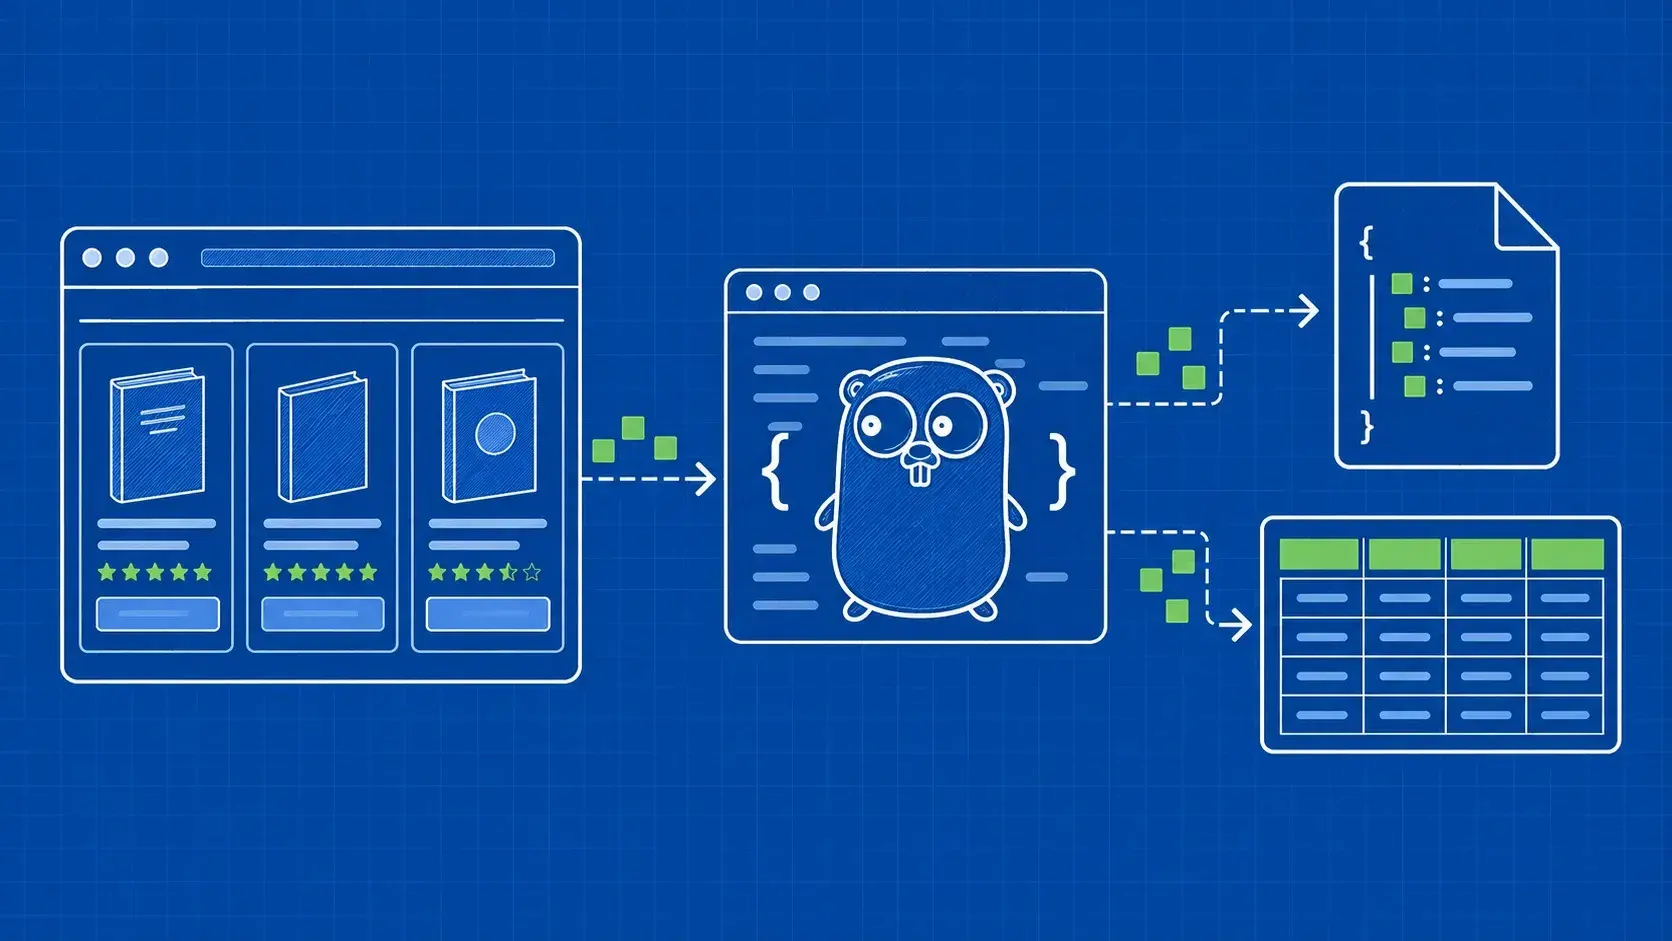
TL;DR: Für Web-Scraping mit Go verwenden Sie net/http , um statisches HTML abzurufen, und `gquery`, um Felder mit CSS-Selektoren zu extrahieren. Beginnen Sie mit einer Seite, validieren Sie jeden Datensatz und exportieren Sie JSON. Fügen Sie „Colly“ für die Crawling-Planung oder einen Browser für JavaScript hinzu, sofern Ihr Ziel dies erfordert. Das vollständige Beispiel unten umfasst Timeouts, Antwortbeschränkungen, Statusprüfungen und explizite Parsing-Fehler.Ein Scraper, der einmalig einen Titel ausgibt, lässt sich leicht demonstrieren. Ein Scraper, der dir mitteilt, wenn sich eine Seite ändert, eine Anfrage fehlschlägt oder ein Feld verschwindet, ist in einer Go-Anwendung jedoch weitaus nützlicher. Der Unterschied ergibt sich aus den Grenzen, die du beim Abrufen, Parsen und Exportieren von Daten setzt.
Dieser Leitfaden führt Sie anhand einer Beispiel-Buchhandlung durch das Web-Scraping mit Go. Sie werden ein Modul erstellen, eine Katalogseite abrufen, Buchdatensätze extrahieren und eine JSON-Datei schreiben. Das Programm ist vollständig, sodass Sie es ausführen können, bevor Sie die Selektoren an eine andere Quelle anpassen. Sie sollten bereits mit Go-Funktionen, Structs, Fehlerrückgaben und grundlegenden Befehlszeilenoperationen vertraut sein.
Der gleiche Ansatz gilt für viele Web-Scraping-Projekte in Go: Definieren Sie zunächst die Ausgabefelder, untersuchen Sie den Quell-HTML-Code und machen Sie fehlende Daten erkennbar. Anschließend werden wir uns mit Paginierung, Colly, Browser-Rendering und Tests befassen, damit Sie die erste Version erweitern können, ohne die Kontrolle über ihr Verhalten zu verlieren.
Halten Sie das anfängliche Erfolgskriterium konkret: Eine angeforderte Seite liefert einen gültigen Satz von Buchdatensätzen oder einen Fehler, der erklärt, warum dies nicht möglich war. So haben Sie einen nützlichen Maßstab, bevor Sie weitere Seiten oder Worker hinzufügen.