Zum Inhalt springen
Zurück zum Blog

Daten aus APIs extrahieren: Eine zuverlässige erste Pipeline

Gabriel CiociZuletzt aktualisiert am 12 min read
Daten aus APIs extrahieren: Eine zuverlässige erste Pipeline
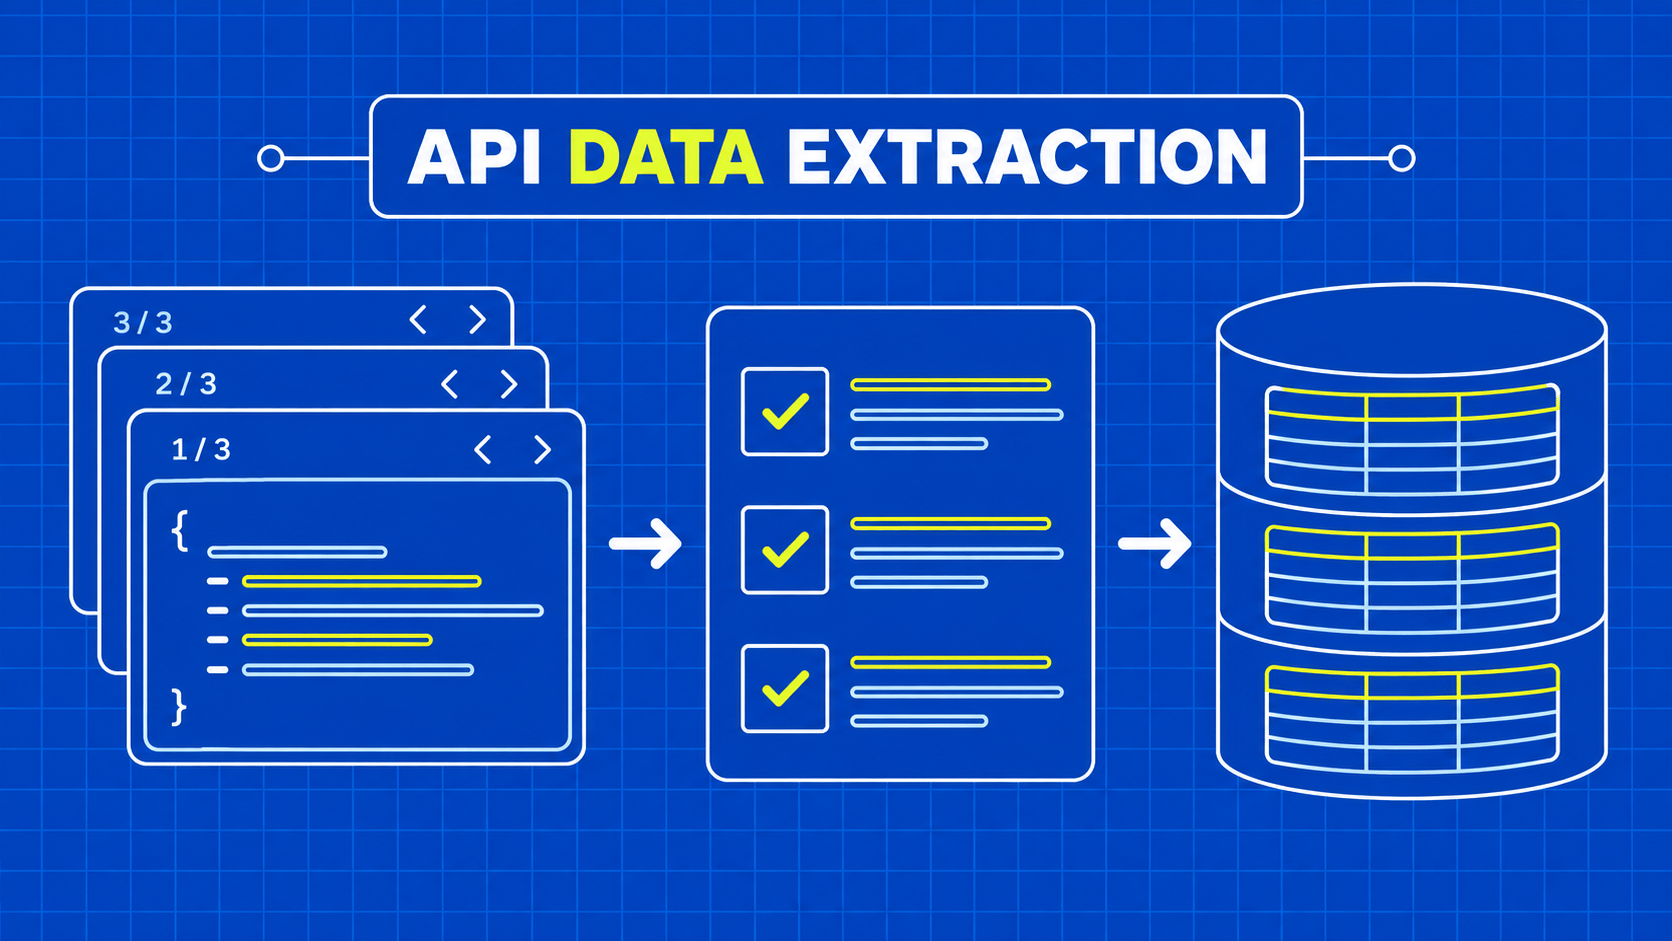
TL;DR: Die API-Extraktion ist ein Prozess, der von dokumentierten Anfragen bis hin zu validierten Datensätzen reicht. Beginnen Sie mit einem kleinen Ausgabekonzept, testen Sie die Paginierung und Fehlerfälle lokal und fügen Sie anschließend einen echten Client, dauerhafte Checkpoints sowie eine explizite Meldung hinzu, ob die Erfassung abgeschlossen ist.

Eine Anfrage gibt eine Produktliste zurück, Ihr Skript analysiert das JSON und das Terminal gibt eine Zeile aus. Das ist eine nützliche erste Überprüfung, aber das Extrahieren von Daten aus APIs bedeutet mehr als nur den Empfang einer Antwort. Ein zuverlässiger Extraktor muss entscheiden, welche Datensätze gültig sind, wie es weitergehen soll und was gemeldet werden muss, wenn nur ein Teil der beabsichtigten Datensammlung eintrifft.

Dieser Leitfaden entwickelt diese Entscheidungen anhand eines fiktiven Produktkatalogs. Die Übung nutzt eine lokale Python-Fixture anstelle eines Netzwerkdienstes, sodass Sie die Fortsetzung, die Behandlung von Duplikaten und abgelehnte Datensätze ohne Anmeldedaten oder externen Datenverkehr testen können. Sobald diese Regeln funktionieren, kann ein echter HTTP-Client Seiten über dieselbe Schnittstelle bereitstellen.

Der Schwerpunkt liegt auf der Implementierung und nicht auf der Terminologie. Falls dir Methoden, Header und Antwortstatus noch unbekannt sind, erklärt der API-Leitfaden für Anfänger diese Grundlagen. Das Ergebnis ist hier ein kleines Extraktionsdesign mit beobachtbaren Erfolgs- und Fehlerbedingungen. Du wirst in der Lage sein zu sagen, was akzeptiert und was abgelehnt wurde und ob die in der Dokumentation der Quelle angegebene Endbedingung erreicht wurde.
Planen Sie die Datenextraktion aus APIs anhand eines Ausgabekontrakts

Notieren Sie sich die Zeile, die Sie ausliefern möchten, bevor Sie eine Schleife erstellen. Für den fiktiven Katalog benötigt jede akzeptierte Zeile eine eindeutige Produkt-ID, einen nicht leeren Namen, einen nicht negativen ganzzahligen Preis in Cent und die Währung EUR. Dies sind übungsspezifische Regeln, keine Annahmen, die für jeden Anbieter gelten.

Trennen Sie den Quellvertrag vom Zielschema. Die Quelle könnte Geld als Dezimaltext, als Ganzzahl oder als formatierten Anzeigewert darstellen. Behalten Sie diese Bedeutung bei der Zuordnung zum Ziel explizit bei. Ein Feld mit dem Namen price gibt von sich aus keine Auskunft über seine Einheit, steuerliche Behandlung oder Währung.

Entscheidung

Beispielregel

Was Sie vermeiden sollten

Identität

Beibehaltung der Produkt-ID der Quelle

Behandlung der Array-Position als Produktschlüssel

Erforderlicher Text

Der Name muss Text ohne Leerzeichen enthalten

Veröffentlichung eines leeren Feldes als vollständiger Datensatz

Numerische Bedeutung

Ganzzahlige Cent-Beträge im Rahmen dieses Mietvertrags

Ermittlung der Einheit anhand des Wertes

Regel bei Duplikaten

Behalten Sie für diese Übung das erste Vorkommen bei

Stilles Zusammenführen widersprüchlicher Beobachtungen

Vervollständigung

Halten Sie am dokumentierten Null-Cursor an

Aufruf eines „Page-Budget“-Stopps als abgeschlossen

Herkunft

Beibehaltung des Anforderungsumfangs und des Erfassungszeitpunkts

Verlust des Kontexts, der diese Datensätze ausgewählt hat

Bei der Duplikatsrichtlinie ist eine explizite Entscheidung erforderlich. Das Beispiel behält das erste gültige Vorkommen bei, da seine Fixture ein identisches Produkt wiederholt. Ein sich tatsächlich ändernder Katalog erfordert möglicherweise stattdessen einen Vergleich von Zeitstempeln oder einen Konfliktdatensatz. Die Deduplizierung sollte die gewählte Richtlinie umsetzen und nicht Unstimmigkeiten zwischen Beobachtungen verbergen.

Bei der Extraktion von Daten aus APIs sollte zwischen einem abgelehnten Datensatz und einer fehlgeschlagenen Seite unterschieden werden. Ein ungültiger Datensatz kann unter Quarantäne gestellt werden, während andere Datensätze gemäß Ihrer Richtlinie weiterhin verwendbar bleiben. Ein nicht erkannter Seitenumschlag kann dazu führen, dass Sie weder den Datensätzen noch dem Fortsetzungswert vertrauen können; ein blindes Fortfahren wäre daher ein weiteres Risiko.

Definieren Sie schließlich den Erfassungsumfang. Halten Sie gegebenenfalls das Konto, die Filter, den Zeitraum und die Endpunktversion fest. Ein korrekter Datensatz außerhalb dieses Umfangs ist für den Auftrag immer noch die falsche Ausgabe.

Trennen Sie Abruf, Dekodierung und Akzeptanz von Datensätzen

Verwenden Sie bei der Implementierung drei Abgrenzungen. Die Abrufphase holt eine Antwort vom Anbieter ein. Die Dekodierungsphase interpretiert die Darstellung. Die Akzeptanzphase validiert und ordnet Geschäftsdatensätze zu. Jede Abgrenzung sollte ein brauchbares Ergebnis oder einen klassifizierten Fehler zurückgeben, anstatt ein Problem stillschweigend durch eine leere Erfassung zu ersetzen.

Die Abrufebene verarbeitet die dokumentierte Anfrage, Anmeldedaten, Zeitüberschreitungen beim Datentransport und den HTTP-Antwortstatus. Sie sollte genügend bereinigte Informationen bereitstellen, um einen Fehler diagnostizieren zu können. Der Datensatzvalidierer sollte nicht dafür zuständig sein, zu erraten, ob eine HTML-Fehlerseite durch eine Zeitüberschreitung oder eine Anmeldeanforderung verursacht wurde.

Die Dekodierungsschicht prüft das erwartete Format und die Hülle. Das JSON-Parsing stellt fest, dass der Text der JSON-Syntax entspricht; es beweist jedoch nicht, dass es sich bei dem Ergebnis um eine Produktseite handelt. Die JSON-Spezifikation definiert Werte und Struktur, überlässt die Bedeutung der Felder jedoch dem Anwendungskontrakt.

Für diese Übung enthält eine Seite eine items Liste und einen next Wert, der entweder null oder eine nicht leere Zeichenkette ist. Ein unerwarteter Umschlag gilt als Seitenfehler. Jedes Element wird anschließend unabhängig anhand der Produktregeln geprüft, bevor es in die akzeptierte Ausgabe gelangt.

Diese Abgrenzungen erleichtern das Testen der Datenextraktion aus APIs. Eine lokale Testumgebung kann den Abruf ersetzen, während die Dekodierungs- und Akzeptanzlogik der Produktionsumgebung weiterhin getestet wird. Sie können eine fehlerhafte Zeile oder einen wiederholten Cursor reproduzieren, ohne darauf angewiesen zu sein, dass ein Anbieter diese Bedingung auf Abruf erzeugt.

Wenn Sie einen echten Client hinzufügen, halten Sie dessen Aufgabenbereich eng gefasst. Der Python-HTTP-Client-Vergleich ist nützlich für die Bewertung von Anforderungssteuerungen, aber keine Client-Bibliothek kann Ihre Definition eines gültigen Produkts ableiten. Bewahren Sie diese Definition in einer separaten, überprüfbaren Funktion auf.

Vermeiden Sie es außerdem, jede Ausnahme abzufangen und []. Dieses Muster macht eine nicht verfügbare Infrastruktur nicht von einem gültigen, leeren Katalog unterscheidbar. Ein Aufrufer sollte erkennen können, ob der Anbieter keine passenden Datensätze zurückgegeben hat oder der Extraktor kein gültiges Ergebnis erzielen konnte.

Führen Sie eine lokale Paginierungs- und Validierungsübung durch

Speichern Sie Folgendes als extract_fixture.py und führen Sie es mit Python 3 aus. Es verwendet ausschließlich die Standardbibliothek und führt keine Netzwerkanfragen durch. Die gefälschten Seiten enthalten zwei gültige Produkte, einen ungültigen Preis und ein identisches Duplikat. Die abschließenden Assertions überprüfen zudem, dass ein wiederholter Fortsetzungscursor sichtbar fehlschlägt.

from copy import deepcopy

PAGES = {
    None: {"items": [
        {"id": "p1", "name": "Lamp", "price_minor": 2400,
         "currency": "EUR"},
        {"id": "bad", "name": "Chair", "price_minor": True,
         "currency": "EUR"},
    ], "next": "page-b"},
    "page-b": {"items": [
        {"id": "p1", "name": "Lamp", "price_minor": 2400,
         "currency": "EUR"},
        {"id": "p2", "name": "Book", "price_minor": 650,
         "currency": "EUR"},
    ], "next": None},
}

def valid_record(row):
    return (
        isinstance(row, dict)
        and isinstance(row.get("id"), str) and bool(row["id"].strip())
        and isinstance(row.get("name"), str) and bool(row["name"].strip())
        and type(row.get("price_minor")) is int
        and row["price_minor"] >= 0
        and row.get("currency") == "EUR"
    )

def collect(fetch_page, max_pages=5):
    cursor, visited, accepted = None, set(), {}
    rejected = duplicates = 0
    for _ in range(max_pages):
        if cursor in visited:
            raise ValueError("pagination cursor repeated")
        visited = visited | {cursor}
        page = fetch_page(cursor)
        if not isinstance(page, dict) or not isinstance(page.get("items"), list):
            raise ValueError("invalid page envelope")
        if "next" not in page or not (
            page["next"] is None
            or isinstance(page["next"], str) and bool(page["next"])
        ):
            raise ValueError("invalid continuation")
        for row in page["items"]:
            if not valid_record(row):
                rejected += 1
            elif row["id"] in accepted:
                duplicates += 1
            else:
                accepted = {**accepted, row["id"]: dict(row)}
        cursor = page["next"]
        if cursor is None:
            return list(accepted.values()), rejected, duplicates
    raise ValueError("page budget exhausted before completion")

rows, rejected, duplicates = collect(lambda cursor: deepcopy(PAGES[cursor]))
assert [row["id"] for row in rows] == ["p1", "p2"]
assert (rejected, duplicates) == (1, 1)
assert not valid_record({"id": "x", "name": "X",
                         "price_minor": True, "currency": "EUR"})
try:
    collect(lambda cursor: {"items": [], "next": "same"})
except ValueError as error:
    assert str(error) == "pagination cursor repeated"
else:
    raise AssertionError("repeated cursor was accepted")
print("2 accepted, 1 rejected, 1 duplicate; cycle check passed")

Der gefälschte Transport gibt eine Kopie zurück, sodass die Extraktion die Fixture nicht verändert. Der Collector validiert den Envelope vor der Verarbeitung der Zeilen, verfolgt Cursor getrennt von Produktidentitäten und akzeptiert nur Datensätze, die den deklarierten Regeln entsprechen. Eine wiederholte Seite und ein wiederholtes Produkt sind unterschiedliche Beobachtungen.

Beachten Sie die numerische Typüberprüfung. In Python sind Boolesche Werte eine Unterklasse der Ganzzahlen, sodass eine allgemeine Überprüfung auf Ganzzahl-Instanzen True als Preis akzeptieren. Diese Fixture schließt dies bewusst durch einen exakten Typvergleich aus. Andere Sprachen und Schema-Tools erfordern eine entsprechende Beachtung von Typumwandlungen und akzeptierten Typen.

Das Seitenbudget ist eine Schutzgrenze, kein Anspruch auf Vollständigkeit. Wenn es abläuft, bevor die Null-Fortsetzung erscheint, löst die Übung einen Fehler aus. Sie gibt niemals ein normales Endergebnis zurück, nur weil die Schleife ihr konfiguriertes Maximum erreicht hat.

Dies ist ein Extraktor für Lehrzwecke, kein produktives Speichersystem. Es sammelt akzeptierte Datensätze im Speicher und löst bei einem Seitenfehler einen Fehler aus, anstatt den teilweisen Fortschritt dauerhaft zu speichern. Bevor Sie Daten in großem Maßstab aus APIs extrahieren, ersetzen Sie diese Einschränkungen durch einen „Sink“ und einen „Run-Record“, die bereits akzeptierte Arbeit bewahren.

Die nächsten lokalen Tests sollten Ihren Vertrag widerspiegeln: einen fehlenden Fortsetzungsschlüssel, ein Feld, das keine Liste ist items Feld und widersprüchliche Duplikate. Formulieren Sie die erwarteten Ergebnisse explizit. Das Ziel ist es, Entscheidungen zu testen, die die reale Quelle erzwingen kann, und nicht, eine umfangreiche Testsuite hinzuzufügen, die lediglich die Implementierung wiederholt.

Machen Sie den Abschluss der Paginierung und die Kontrollpunkte explizit

Die Übung verwendet Cursor-Werte, aber Anbieter veröffentlichen unterschiedliche Paginierungsverträge. Einige geben Links zurück, manche verwenden Offsets, und wieder andere erfordern Seitenzahlen oder Fortsetzungstoken. Die Paginierungsdokumentation von GitHub veranschaulicht die linkbasierte Fortsetzung für diesen Dienst; es handelt sich um ein Beispiel, nicht um ein universelles API-Format.

Behalten Sie undurchsichtige Fortsetzungswerte genau so bei, wie es der Anbieter vorschreibt. Behalten Sie relevante Filter und den Kontokonttext im Arbeitselement bei. Ein für einen bestimmten Anforderungsbereich generiertes Token sollte nicht als eigenständige Anweisung behandelt werden, die für jede nachfolgende Abfrage gilt.

Validieren Sie URL-basierte Fortsetzungslinks, bevor Sie ihnen folgen. Ein in der Antwort bereitgestellter „next“-Link sollte innerhalb der Ziele liegen, zu deren Kontaktaufnahme Ihre Integration berechtigt ist, und Weiterleitungen erfordern dieselben Grenzprüfungen. Leiten Sie keine Anmeldedaten an einen nicht zugehörigen Host weiter, nur weil eine Antwort diese URL enthielt.

Wenn Sie Daten aus APIs in einen dauerhaften Speicher extrahieren, schreiben Sie akzeptierte Daten fest, bevor Sie den Checkpoint fortsetzen. Wenn der Checkpoint zuerst verschoben wird und der Speichervorgang fehlschlägt, können bei einem Neustart Datensätze übersprungen werden. Wenn Daten zuerst gespeichert werden und die Aktualisierung des Checkpoints fehlschlägt, kann der nächste Versuch eine Seite erneut wiedergeben, was durch eine gezielte Duplikatsrichtlinie gehandhabt werden kann.

Eine atomare Transaktion kann hilfreich sein, wenn Senke und Checkpoint dasselbe Speichersystem nutzen. Ist dies nicht der Fall, dokumentieren Sie, wie die Wiederholung und der Abgleich funktionieren. Vermeiden Sie es, eine „Exactly-Once“-Verarbeitung zu behaupten, nur weil im „Happy Path“ eine Zeile pro Quellkennung gespeichert wird.

Erfassen Sie den Grund für den Abbruch. Eine von der Quelle bereitgestellte letzte Seite, ein Seitenbudget, eine Frist und eine abgelehnte Antwort sind unterschiedliche Ergebnisse. Ein Bericht, der nur die Anzahl der akzeptierten Datensätze enthält, kann nicht erklären, ob der Auftrag seinen beabsichtigten Umfang abgedeckt hat.

Testen Sie außerdem die Annahmen des Anbieters bezüglich sich ändernder Daten. Eine offsetbasierte Liste kann sich während des Durchlaufs verschieben, und ein Cursor kann vor einem späteren Neustart ablaufen. Erfassen Sie das Erfassungsfenster und verwenden Sie einen dokumentierten Snapshot oder einen inkrementellen Mechanismus, wenn die Aufgabe eine stärkere Konsistenz erfordert, als ein Live-Durchlauf bietet.

Behandeln Sie Wiederholungsversuche, ohne Lücken oder Duplikate zu verbergen

Ein Wiederholungsversuch ist ein weiterer Versuch einer Operation, keine Korrektur ihrer Eingaben. Die Wiederholung einer Anfrage mit ungültigen Anmeldedaten oder fehlerhaften Parametern führt in der Regel zur Wiederholung des Problems. Beginnen Sie damit, den Fehler zu klassifizieren und festzustellen, was sich gegebenenfalls vor einem weiteren Versuch ändern könnte.

Bei HTTP hilft die Methodensemantik in RFC 9110 dabei, sichere Abrufe von Operationen zu unterscheiden, deren Wiederholung geschäftliche Auswirkungen haben kann. Selbst bei Lesevorgängen sollten Sie die Anzahl der Versuche begrenzen und das dokumentierte Verhalten des Anbieters beachten. Aktivieren Sie keine allgemeine Wiederholungsfunktion, ohne zu prüfen, welche Fehler und Operationen dadurch wiederholt werden.

Bei Ratenbegrenzungen muss die Gesamtlast beachtet werden. Eine 429 Antwort signalisiert eine Begrenzungsbedingung; der Zählbereich wird vom Dienst definiert, und die Antwort kann Hinweise zur Verzögerung enthalten. RFC 6585 definiert den Status. Mehrere Worker, die sich Anmeldedaten teilen, können dasselbe Kontingent verbrauchen.

Wählen Sie einen Verantwortlichen für Wiederholungsversuche aus. Wenn der Client, der Vermittler und der Job-Runner alle im Hintergrund Wiederholungsversuche durchführen, kann eine beabsichtigte Anfrage zu mehr Datenverkehr führen, als der Collector erfasst. Machen Sie die Anzahl der Versuche und die verstrichene Job-Laufzeit ausreichend sichtbar, um diese Multiplikation untersuchen zu können.

Behalten Sie beim Extrahieren von Daten aus APIs einen separaten Status für die teilweise Erfassung bei. Wenn drei Seiten akzeptiert wurden und die vierte fehlgeschlagen ist, bewahren Sie die akzeptierten Daten gemäß den Richtlinien auf und protokollieren Sie den fehlenden Umfang. Erstellen Sie keine Markierung für die letzte Seite und liefern Sie keinen unqualifizierten „vollständigen“ Datensatz.

Schützen Sie den Fehlerbericht selbst. Speichern Sie bereinigte Anfrage-Identifikatoren, Antwortkategorien und Schemafehler. Vermeiden Sie es, Anmeldedaten, vollständige Kontodaten oder uneingeschränkte Dateninhalte in ein allgemeines Protokoll zu schreiben, nur weil etwas schiefgelaufen ist.

Schließlich sollten wiederholte Abrufe von wiederholten Übermittlungen unterschieden werden. Wenn der nachgelagerte Export nach erfolgreicher Erfassung fehlschlägt, bleibt die ursprüngliche Beobachtung erhalten, wenn der Export aus den gespeicherten Datensätzen erneut versucht wird. Ein erneutes Abrufen der Quelle erzeugt einen anderen Durchlauf, dessen Werte und Vollständigkeit abweichen können.

Liefern Sie Datensätze mit Herkunfts- und Änderungsprüfungen

Eine akzeptierte Zeile sollte genügend Kontext enthalten, um zu erklären, woher sie stammt. Je nach Aufgabe umfasst dies die Identität der Quelle, den Erfassungszeitpunkt, den Umfang der Anfrage, die Endpunktversion und die Transformationsversion. Halten Sie den Zeitpunkt der Quellmodifikation getrennt von dem Zeitpunkt, zu dem Ihr Collector den Datensatz erfasst hat.

Überprüfen Sie sowohl die Übergabegrenze als auch die Antwort der Quelle. Eine korrekte Ganzzahl kann bei einem Export zu Text werden, ein Nullwert kann zu einer leeren Zelle werden oder ein Verbraucher kann einen Zeitstempel in einer anderen Zeitzone interpretieren. Definieren Sie das Ausgabeschema und überprüfen Sie eine repräsentative Datei oder Nachricht, bevor Sie einen gesamten Durchlauf veröffentlichen.

Fügen Sie für die planmäßige Extraktion von Daten aus APIs einen Monitor für geringfügige Änderungen hinzu. Vergleichen Sie die Anzahl der Ablehnungen, das Vorhandensein von Pflichtfeldern und das Abschlussverhalten mit den Erwartungen für diese Quelle. Ein plötzlicher Rückgang der akzeptierten Datensätze verdient eine Untersuchung, ist jedoch nicht automatisch auf einen Fehler bei der Extraktion zurückzuführen; möglicherweise haben sich Quellenfilter oder der Bestand rechtmäßig geändert.

Halten Sie eine genehmigte Testvorlage für die Wartung bereit. Wenn ein Anbieter ein optionales Feld ändert, sollte ein Test zeigen, ob Ihr Mapping dieses Feld sicher ignoriert oder aktualisiert werden muss. Wenn sich die Bedeutung eines Pflichtfeldes ändert, überarbeiten Sie den Vertrag, anstatt einen pauschalen Fallback hinzuzufügen, der plausible Ergebnisse liefert.

Der Leitfaden zum automatisierten Web-Scraping verknüpft diese Akzeptanz- und Liefergrenzen mit dem gesamten Auftragslebenszyklus. Es gilt dieselbe operative Disziplin, unabhängig davon, ob die Eingabe von einer dokumentierten API oder einer geparsten Webseite stammt.

Schließen Sie die erste Implementierung mit einem Ausführungsbericht ab, den andere nutzen können: Anzahl der akzeptierten, abgelehnten, doppelten und fehlerhaften Seiten; den Grund für die Ablehnung; sowie den Speicherort der validierten Ausgabe. Dieser Bericht verwandelt ein funktionierendes Skript in einen Erfassungsprozess, dessen Einschränkungen sichtbar bleiben.

Wichtige Erkenntnisse

  • Definieren Sie Feldbedeutung, Identität, Duplikatrichtlinie und Fertigstellung, bevor Sie Daten in einer Schleife aus APIs extrahieren.
  • Halten Sie das Abrufen, die Dekodierung und die geschäftliche Validierung voneinander getrennt, damit Übertragungsfehler nicht zu leeren Erfolgsergebnissen führen.
  • Testen Sie wiederholte Cursor, ungültige Zeilen und Seitenkontingente lokal, bevor Sie den Extraktor mit einem Live-Anbieter verbinden.
  • Speichern Sie akzeptierte Daten, bevor Sie einen Checkpoint weiterverfolgen, und gestalten Sie das Neustartverhalten so, dass es mit einer gezielten Wiederholung kompatibel ist.
  • Bewahren Sie Nachweise über Teilausführungen auf und validieren Sie das endgültige Auslieferungsformat ebenso sorgfältig wie die Antwort der Quelle.

FAQ

Sollten Erfassung und Transformation denselben Zeitplan verwenden?

Nicht unbedingt. Das Erfassen einer Quellbeobachtung und das Transformieren gespeicherter Daten sind unterschiedliche Aufgaben. Durch deren Trennung können Sie eine Zuordnung korrigieren, ohne eine weitere Quellenanfrage stellen zu müssen. Legen Sie fest, wie lange Rohbeobachtungen aufbewahrt werden sollen und welche Transformationsversionen die Verbraucher benötigen, und planen Sie dann jeden Schritt entsprechend diesen Anforderungen.

Wie sollte ein API-Collector mit einem neuen optionalen Feld umgehen?

Befolgen Sie die Kompatibilitätsrichtlinie, die Sie für die Quelle gewählt haben. Ein Kollektor, der unbekannte optionale Felder ignoriert, kann unverändert weiterarbeiten, während ein Kollektor, der ein vollständiges Rohdokument beibehält, diese Felder zur späteren Überprüfung aufbewahren kann. Geben Sie nicht automatisch jedes neue Feld an nachgelagerte Verbraucher weiter, ohne dessen Bedeutung und die Auswirkungen auf den Zugriff zu überprüfen.

Kann ein CSV-Export jeden API-Wert beibehalten?

Nicht ohne eine explizite Zuordnung. CSV behält von Natur aus keine verschachtelten Objekte, Arrays oder Unterscheidungen wie „null“ gegenüber leerem Text bei. Glätten oder kodieren Sie diese Werte gezielt, dokumentieren Sie die Konvention und testen Sie die Interpretation durch den Verbraucher. Behalten Sie eine reichhaltigere Quelldarstellung bei, falls bei der späteren Verarbeitung Informationen benötigt werden, die in der Tabelle fehlen.

Fazit

Beginnen Sie die Datenextraktion aus APIs mit einem kleinen Vertrag und einer auf Fehler reagierenden Schleife. Die lokale Übung veranschaulicht die entscheidenden Entscheidungen: Akzeptieren Sie nur definierte Datensätze, behandeln Sie doppelte Produkte getrennt von wiederholten Cursorn und verlangen Sie eine echte Endbedingung. Ein echter HTTP-Client fügt Transportaspekte hinzu, ohne diese Regeln zu ersetzen.

Bevor Sie den Job einplanen, weisen Sie akzeptierten Daten einen dauerhaften Speicherort zu, stellen Sie sicher, dass der Checkpoint sicher wiedergegeben werden kann, und erstellen Sie einen Bericht, der vollständige von teilweisen Durchläufen unterscheidet. Diese Kontrollmaßnahmen ermöglichen es Ihnen, den Umfang zu erweitern, ohne dass fehlende Daten schwerer zu erkennen sind.

Falls einige erforderliche Felder nur über Webseiten verfügbar sind, ziehen Sie die Scraper-API von WebScrapingAPI als zusätzliche Eingabequelle in Betracht. Behalten Sie für diese Daten dieselben Vereinbarungen hinsichtlich Akzeptanz, Herkunft und Bereitstellung bei, damit die Pipeline auch bei unterschiedlichen Erfassungsmethoden konsistent bleibt.

Über den Autor

Gabriel Cioci, Full-Stack-Entwickler @ WebScrapingAPI

Gabriel Cioci

Full-Stack-Entwickler

Gabriel Cioci ist Full-Stack-Entwickler bei WebScrapingAPI und verantwortlich für die Entwicklung und Wartung der Websites, des Benutzerportals sowie der wichtigsten benutzerseitigen Komponenten der Plattform.

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.