Zum Inhalt springen
Zurück zum Blog

APIs für Einsteiger: Leseanfragen und Datenabruf

Robert MunceanuZuletzt aktualisiert am 14 min read
APIs für Einsteiger: Leseanfragen und Datenabruf
TL;DR: Eine API ist eine Schnittstelle, über die Software die Funktionen eines anderen Systems nutzen kann. Für die Datenerfassung sollten Sie lernen, den Anforderungskontext zu lesen, sowohl den Status als auch den Inhalt der Antwort zu interpretieren, Zugangsdaten zu schützen und nachzuweisen, dass Sie die gewünschten Datensätze erfasst haben, bevor Sie weitere Anfragen planen.

Ein Anbieter stellt eine Produktseite und eine dokumentierte API zum Abrufen desselben Katalogs bereit. Sie möchten Namen, Preise und Produktkennungen in einem Datensatz haben. In diesem Moment wird das Thema „APIs für Anfänger“ praktisch relevant: Sie müssen verstehen, wie ein Programm Daten anfordert, welche Daten zurückgegeben werden und ob das Ergebnis das bedeutet, was Sie vermuten.

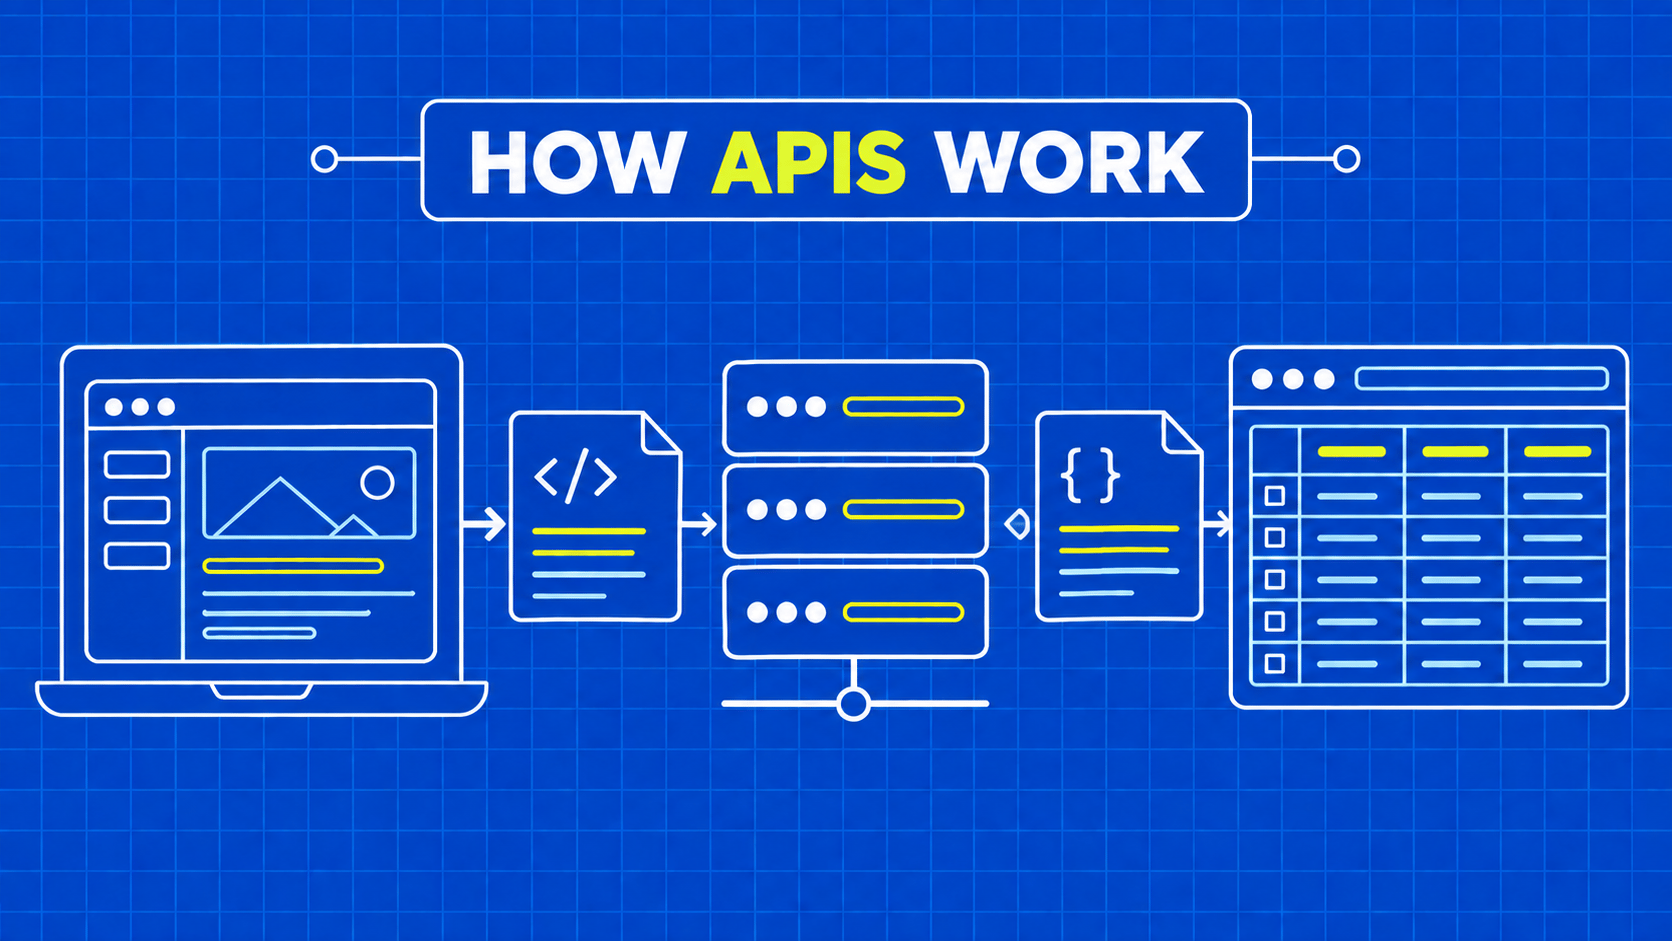
Eine Anwendungsprogrammierschnittstelle (API) definiert, wie Software mit einer Funktion interagieren kann. Nicht jede API wird über ein Netzwerk aufgerufen; auch eine Programmierbibliothek stellt eine Schnittstelle bereit. Dieser Leitfaden konzentriert sich auf Web-APIs zum Abrufen von Daten, bei denen Ihr Programm eine Anfrage an einen Dienst sendet und dessen Antwort auswertet. Die API-Einführung von MDN erläutert diese allgemeinere Unterscheidung.

Beginnen Sie mit einem dokumentierten Lesevorgang und einem erwarteten Datensatz. Wir werden einen fiktiven Katalog verwenden und anschließend ein in sich geschlossenes Antwortbeispiel untersuchen. Es sind weder ein Konto, ein API-Schlüssel, ein externer Dienst noch eine Softwareinstallation erforderlich. Das Ziel ist es, die Fragen zu entwickeln, die Ihre erste echte Integration zuverlässig machen.

APIs für Anfänger anhand einer Katalogaufgabe verstehen

Stellen Sie sich vor, Ihre Aufgabe besteht darin, jeden Morgen den Listenpreis des Anbieters für eine Schreibtischlampe zu erfassen. Ein Mensch kann die Produktseite öffnen und den Preis ablesen. Ein Programm benötigt jedoch eine wiederholbare Methode, um das Produkt zu identifizieren und eine Darstellung abzurufen, die die relevanten Felder enthält.

Eine dokumentierte API kann diese Schnittstelle bereitstellen. Ihre Dokumentation sollte Ihnen erklären, welcher Vorgang Produkte abruft, wie Identifikatoren funktionieren, welche Anmeldedaten erforderlich sind und wie Felder zu interpretieren sind. Sie müssen dennoch die Abdeckung überprüfen: Eine unterstützte API lässt möglicherweise Informationen aus, die auf der Website angezeigt werden, oder aktualisiert diese nach einem anderen Zeitplan.

Begriff

Einfache Bedeutung

Fiktives Katalogbeispiel

Client

Software, die eine Anfrage stellt

Ihr Abfrageskript

Server

Software, die die Anfrage bearbeitet

Der Katalogdienst des Anbieters

Endpunkt

Eine Adresse, die für einen API-Vorgang verwendet wird

Die Adresse der dokumentierten Produkte

Anfrage

Die Nachricht des Clients, in der er nach Aufgaben oder Daten fragt

Produkte einer Kategorie lesen

Antwort

Die Antwort des Servers

Status, Header und ein Produktdokument

Schema

Regeln, die die Datenstruktur und deren Bedeutung beschreiben

Produkt-ID, Name, Preis, Währung

APIs für Anfänger sollten zudem zwischen unterstützten Schnittstellen und zufälligen Implementierungsdetails unterscheiden. Die Entwicklertools eines Browsers können zwar die von einer Website verwendeten Anfragen offenlegen, doch diese Erkenntnis begründet weder einen öffentlichen Vertrag noch eine Erlaubnis zur Wiederverwendung dieser Anfragen. Bevorzugen Sie eine dokumentierte Schnittstelle und halten Sie sich an deren Zugangsbedingungen.

Scraping und die Nutzung von APIs können Eingaben für dieselbe Datenpipeline sein. Beim Scraping werden Informationen aus einer Darstellung oder einem Dokument extrahiert; die Nutzung einer dokumentierten API folgt einem veröffentlichten Softwarevertrag. Beides garantiert nicht automatisch, dass ein Feld aktuell, vollständig oder für Ihren Zweck geeignet ist.

Definieren Sie vor dem Absenden von Anfragen eine als erfolgreich geltende Beobachtung: ein bekanntes Produkt, einen nicht leeren Namen, den Preis in einer bekannten Einheit und Währung sowie den Zeitpunkt der Erfassung. Diese Definition dient als Leitfaden für jede nachfolgende Überprüfung.

Lesen Sie die Anfrage durch, bevor Sie einen Client auswählen

Eine HTTP-Anfrage ist mehr als nur eine URL. Sie umfasst eine Methode, ein Ziel, Header und manchmal einen Body. Jeder Teil hat eine bestimmte Aufgabe. Lies die Funktionsbeschreibung des Anbieters, bevor du entscheidest, welche Werte du senden möchtest, oder bevor du ein Beispiel von einem anderen Dienst kopierst.

Die Methode beschreibt die Semantik der Anfrage. GET wird zum Abrufen verwendet; andere Methoden dienen unterschiedlichen Zwecken. Leiten Sie die Auswirkungen eines unbekannten Endpunkts nicht allein aus dessen Namen ab. Der HTTP-Semantik-Standard definiert die gemeinsamen Bedeutungen, auf denen Implementierungen aufbauen.

Die URL gibt an, wohin die Anfrage gesendet wird. Ein Pfad kann ein Produkt oder eine Sammlung bezeichnen, während Abfrageparameter dokumentierte Filter oder Paginierungswerte liefern können. Behandeln Sie Identifikatoren und Cursor als Daten. Nutzen Sie bei der Implementierung der Anfrage die Funktionen Ihres Clients zum Erstellen von URLs, damit Leerzeichen, Satzzeichen und reservierte Zeichen korrekt kodiert werden.

Header enthalten Metadaten. Je nach Vertrag können sie akzeptierte Formate angeben, den Client authentifizieren oder Bedingungen für eine Anfrage bereitstellen. Ein Body enthält zusätzliche Inhalte, wenn die Operation dies erwartet. Ein Feld an der falschen Stelle zu platzieren, ist nicht gleichbedeutend mit der korrekten Angabe, selbst wenn sein Name richtig aussieht.

Erstellen Sie für den fiktiven Katalog ein Arbeitsblatt für Anfragen in einfacher Sprache: Lesevorgang, Kategoriefilter, erwartete Darstellung, erforderliche Authentifizierungsmethode, Timeout und dokumentiertes Paginierungsverhalten. Lassen Sie unbekannte Einträge als Fragen für die Dokumentation offen. Füllen Sie diese nicht mit Konventionen eines anderen Anbieters aus.

Das Client-Tool sollte gegenüber diesem Arbeitsblatt zweitrangig sein. Befehlszeilen-Clients, Python-Bibliotheken und SDKs erstellen Anfragen mit unterschiedlichen Annehmlichkeiten und Standardeinstellungen. Unser Leitfaden zum Python-HTTP-Client hilft Ihnen beim Vergleich der Anfrageschicht, wenn Sie bereit sind, diese zu implementieren.

Halten Sie den ersten Live-Test klein und schreibgeschützt. Nutzen Sie die Testumgebung des Anbieters oder einen zulässigen Beispieldatensatz, sofern verfügbar, und prüfen Sie dann die Antwort, bevor Sie den Umfang der Anfrage erweitern.

Betrachten Sie die Antwort als Status und als Datenvertrag

Eine HTTP-Antwort enthält einen Statuscode, Header und möglicherweise einen Body. Eine erfolgreiche Übertragung und ein gültiger Geschäftsdatensatz sind unterschiedliche Feststellungen. Ihr Collector sollte beides überprüfen, bevor er die Daten akzeptiert.

Ein Statuscode fasst das Ergebnis der Anfrage auf HTTP-Ebene zusammen. Ein erfolgreicher Status bedeutet nicht zwangsläufig, dass der Hauptteil genau die Felder enthält, die Ihr Job benötigt. Umgekehrt kann ein fehlgeschlagener Status einen strukturierten Fehlertext enthalten, der einen fehlenden Parameter oder abgelaufene Anmeldedaten erklärt.

Beobachtung

Was als Nächstes zu prüfen ist

Was Sie nicht voraussetzen sollten

Keine HTTP-Antwort

Hinweise auf Verbindungsprobleme, DNS-Fehler, TLS-Probleme oder Zeitüberschreitungen

Der Katalog war leer

Authentifizierungsfehler

Dokumentierte Anforderungen an die Anmeldedaten

Die erneute Eingabe der unveränderten Anmeldedaten behebt das Problem

Berechtigung verweigert

Kontobereich und Ressourcenzugriff

Jede Verweigerung ist eine Netzwerksperre

Antwort zur Ratenbegrenzung

Anbieterbeschränkungen und Hinweise zu Verzögerungen

Mehr parallele Anfragen helfen

Erfolg bei unerwarteten Inhalten

Medientyp, Schema und Seitenidentität

Jeder zurückgegebene Body gilt als akzeptable Daten

Gültige leere Sammlung

Angewandte Filter und Abschlussstatus

Leer bedeutet immer, dass die Abfrage fehlgeschlagen ist

Header helfen dabei, den Hauptteil zu erklären. Ein Medientyp wie application/json identifiziert ein Darstellungsformat, dennoch sollten Sie mit fehlerhaften oder unerwarteten Inhalten umgehen können. Ein von einer anderen Komponente generierter Fehler kann in einem anderen Format als dem von Ihnen angeforderten eintreffen.

JSON ist ein Textformat, das Werte wie Objekte, Arrays, Zeichenketten, Zahlen, Boolesche Werte und „null“ enthält. Es ist nicht die API selbst und liefert nicht automatisch geschäftliche Bedeutung. Der JSON-Standard definiert das Format; der Anbieter legt fest, ob ein bestimmtes Feld Cent, Euro, ein Datum oder etwas anderes bedeutet.

Wenn Sie sich als Anfänger mit APIs vertraut machen, vermeiden Sie es, „erfolgreich geparst“ mit „korrekt“ gleichzusetzen. Überprüfen Sie nach dem Parsen die Pflichtfelder, Datentypen, Einheiten und die Identität. Unterscheiden Sie außerdem zwischen fehlenden Werten, „null“, Null und leerem Text. Der Vertrag weist jedem dieser Elemente möglicherweise eine andere Bedeutung zu, und eine automatische Standardzuweisung kann diese Unterscheidung aufheben.

Behandeln Sie Anmeldedaten und Zugriff als separate Aspekte

Ein API-Schlüssel ist ein Anmelde- und Zugriffsnachweis, der von einigen Diensten zur Identifizierung oder Authentifizierung eines Aufrufers verwendet wird. Andere Schnittstellen nutzen Zugriffstoken, signierte Anfragen oder andere Mechanismen. In der Dokumentation des Anbieters sollte angegeben sein, welche Methode erforderlich ist und wo der Anmelde- und Zugriffsnachweis anzugeben ist.

Authentifizierung und Autorisierung beantworten unterschiedliche Fragen. Die Authentifizierung stellt fest, wer oder was den Aufruf tätigt. Die Autorisierung bestimmt, ob dieser Aufrufer diese Aktion an dieser Ressource durchführen darf. Ein funktionierender Schlüssel gewährt nicht unbedingt Zugriff auf jeden Endpunkt oder die Daten jedes Kontos.

Für den fiktiven Katalog könnte ein Lieferant öffentliche Produktbeschreibungen zulassen, während er die Lagerbestände auf bestimmte Kunden beschränkt. Wenn die Preisabfrage erfolgreich ist und die Lagerabfrage fehlschlägt, überprüfen Sie zunächst die dokumentierten Berechtigungen. Gehen Sie nicht davon aus, dass ein gültiges Anmeldeobjekt bedeutet, dass auch die zweite Anfrage zugelassen werden muss.

Halten Sie Geheimnisse aus Artikelbeispielen, festgeschriebenen Dateien, geteilten Screenshots und gewöhnlichen Protokollen fern. Verwenden Sie bei der Implementierung eines Clients eine Umgebungsvariable oder den in Ihrer Bereitstellung genehmigten Mechanismus für Geheimnisse. Zeichnen Sie bei Bedarf zu Diagnosezwecken eine Kennung der Anmeldeinformationen auf, nicht den geheimen Wert selbst.

APIs für Einsteiger sollten eine weitere Unterscheidung deutlich machen: Die Browserumgebung und ein serverseitiges Programm weisen unterschiedliche Sicherheitsrisiken auf. Ein in vom Browser bereitgestelltem Code eingebettetes Geheimnis ist für die Person zugänglich, die diesen Browser ausführt. Behandeln Sie es nicht als auf dem Server gespeicherte Anmeldeinformationen, nur weil die Variable den Namen „private“ trägt.

Machen Sie sich vor der Planung von Arbeiten mit dem Lebenszyklus von Anmeldedaten vertraut. Ermitteln Sie, wie Anmeldedaten ablaufen oder rotieren, wie der Prozess Ersatzdaten erhält und welcher Verantwortliche Zugriffsfehler beheben kann. Ein geplanter Collector benötigt einen eindeutigen Fehlerzustand, wenn die Authentifizierung nicht mehr funktioniert, anstatt in einer Schleife zu verharren, die dieselbe abgelehnte Anfrage wiederholt.

Wenn Sie einen Problembericht weiterleiten, geben Sie den Vorgang, den Status, den Zeitpunkt und die bereinigten Fehlerdetails an. Diese Informationen helfen dem Anbieter bei der Untersuchung, ohne dass die Zugangsdaten offengelegt werden, die den Zugriff auf Ihre Daten ermöglichen.

Üben Sie die Interpretation einer in sich geschlossenen Antwort

Nehmen wir an, der fiktive Katalogvertrag besagt price_minor eine ganze Zahl in Cent ist, currency die Währung identifiziert und next_cursor entweder ein undurchsichtiger Fortsetzungswert oder „null“ ist, wenn dieses Ergebnis keine nächste Seite hat. Diese Regeln wurden für diese Übung erfunden und dürfen nicht auf eine andere API übertragen werden.

Das Folgende ist eine Vorlage für den Antworttext, keine Anfrage, die Sie irgendwohin senden sollten:

{
  "items": [
    {
      "id": "lamp-17",
      "name": "Desk lamp",
      "price_minor": 2400,
      "currency": "EUR"
    }
  ],
  "next_cursor": null
}

Beginnen Sie mit der Identität. Der Artikel identifiziert lamp-17, daher sollte Ihr Datensatz diesen Wert beibehalten, anstatt seine Position im Array als Produktkennung zu verwenden. Der Name ist ein separates Feld und könnte sich ändern, ohne dass dadurch ein anderes Produkt entsteht.

Wende als Nächstes die angegebene Einheitsregel an. Der Betrag beträgt 24,00 EUR, da in dieser Übung die Ganzzahl explizit als Cent definiert ist. Ohne diese Definition wäre die Division durch hundert nur eine Vermutung. Behalte die ursprüngliche Ganzzahl und die Währung neben jedem formatierten Anzeigewert bei, damit spätere Umwandlungen nachvollziehbar bleiben.

Prüfen Sie anschließend die Fortsetzung. „Null“ bedeutet, dass es unter diesem fiktiven Vertrag keine nächste Seite gibt. Das beweist nicht, dass das gesamte Sortiment des Anbieters nur ein Produkt enthält; die Anfrage könnte eine Kategorie oder einen anderen Filter ausgewählt haben. Vollständigkeit bezieht sich immer auf einen definierten Anfrageumfang.

Erstellen Sie schließlich im Kopf Negativfälle: Entfernen Sie den Namen, ersetzen Sie die Ganzzahl durch ein Wort oder geben Sie eine unerwartete Währung an. Entscheiden Sie, welche Fälle Ihr Collector ablehnen oder in Quarantäne stellen würde. Ein Body kann gültiges JSON bleiben, obwohl er gegen jede nützliche Geschäftsregel verstößt.

Diese Übung verdeutlicht den Kern von APIs für Anfänger: Syntax, Bedeutung und Akzeptanz sind separate Ebenen. Eine echte Implementierung sollte diese Ebenen sichtbar machen, sodass eine unbekannte Antwort als klassifizierter Fehler und nicht als plausibler, aber falscher Datensatz gewertet wird.

Mehr als eine Seite abrufen, ohne an Aussagekraft zu verlieren

APIs unterteilen größere Sammlungen häufig in Seiten. Der Anbieter verwendet dabei möglicherweise Seitenzahlen, Offsets, Cursor oder Links. Machen Sie sich mit dem dokumentierten Fortsetzungsmechanismus vertraut, anstatt davon auszugehen, dass durch das Erhöhen einer Zahl alle Daten abgerufen werden.

Ein Cursor ist für den Verbraucher oft undurchsichtig: Man gibt den bereitgestellten Wert wie angegeben zurück, ohne ihn zu interpretieren oder zu verändern. Er kann einen Zustand kodieren, den der Anbieter ändern kann. Ein Link zur nächsten Seite lässt den Dienst ebenfalls das Ziel vorgeben. Der REST-Architekturleitfaden erklärt, warum unterstützte Übergänge in einer ressourcenorientierten Schnittstelle wichtig sind.

Behalten Sie für den fiktiven Katalog die Anforderungsfilter zusammen mit dem Fortsetzungswert bei. Ein Cursor für eine Kategorie gilt möglicherweise nicht für eine andere. Zeichnen Sie die Identitäten akzeptierter Elemente auf und legen Sie fest, wie mit Duplikaten umgegangen wird, insbesondere wenn ein sich ändernder Katalog Datensätze während der Erfassung verschieben kann.

Ratenbegrenzungen schränken das Anforderungsvolumen gemäß den Richtlinien des Anbieters ein. Eine 429 Too Many Requests Antwort weist auf eine Ratenbegrenzungsbedingung hin, doch der Status definiert nicht, wie der Anbieter die Nutzung erfasst. RFC 6585 beschreibt den Status 429 und weist darauf hin, dass eine Antwort Retry-After Hinweise enthalten.

Befolgen Sie die geltenden Empfehlungen zur Verzögerung und begrenzen Sie die Anzahl der Wiederholungsversuche. Behandeln Sie einen wiederholten Berechtigungsfehler anders als einen vorübergehenden Dienstausfall. Berücksichtigen Sie zudem den gesamten Auftrag: Mehrere Worker, die jeweils eine geringe Anzahl von Anfragen stellen, können gemeinsam die zulässige Rate überschreiten.

APIs für Anfänger sollten eine Definition des Begriffs „abgeschlossen“ enthalten. Wurde die dokumentierte letzte Seite erreicht, wurde der Vorgang aufgrund eines Zeitbudgets abgebrochen oder ist er nach der Annahme einiger Datensätze fehlgeschlagen? Speichern Sie diese Klassifizierung zusammen mit dem Lauf. „500 Produkte gesammelt“ gibt keinen Aufschluss darüber, ob der Umfang der Anfrage 500 oder weitaus mehr umfasste.

Speichern Sie den Fortschritt, nachdem die akzeptierten Daten dauerhaft gespeichert wurden, und gestalten Sie das Neustartverhalten so, dass keine Arbeit übersprungen wird. Behalten Sie das Erfassungsfenster in der Ausgabe bei, da eine lange Durchquerung einer sich ändernden Quelle eher Beobachtungen über einen bestimmten Zeitraum darstellen kann als eine exakte Momentaufnahme.

Von einer erfolgreichen Anfrage zu einem zuverlässigen Job

Eine erfolgreiche Antwort beweist, dass eine Interaktion unter bestimmten Bedingungen funktioniert hat. Ein geplanter Collector muss auch mit geänderten Daten, abgelaufenen Zugriffsrechten, Teilausführungen und Ausgabfehlern umgehen können. Fügen Sie diese Aufgaben bewusst hinzu, anstatt zunächst das Anfragevolumen zu erhöhen.

Beginnen Sie mit einem kurzen Akzeptanzbericht. Geben Sie den Umfang der Anfrage, den Erfassungszeitpunkt, die Anzahl der akzeptierten Datensätze, die Anzahl der abgelehnten Datensätze, den Fortsetzungsstatus und gegebenenfalls die Fehlerkategorie an. Vermeiden Sie es, unverschlüsselte Geheimnisse oder uneingeschränkte Antwortinhalte in diesen Bericht aufzunehmen.

Behalten Sie den Unterschied zwischen dem Abruf der Quelle und der Datenübermittlung bei. Wenn die Datensätze lokal akzeptiert wurden, der Export jedoch fehlgeschlagen ist, kann die geeignete Abhilfemaßnahme darin bestehen, die gespeicherte Ausgabe erneut zu senden, anstatt die Quelle erneut abzurufen. Ein zweiter Abruf kann zu einer anderen Beobachtung führen und sollte die ursprüngliche nicht stillschweigend ersetzen.

Legen Sie fest, wie die Aktualität gehandhabt wird. Eine gespeicherte Antwort ist nicht automatisch aktuell, nur weil sie einmal gültig war. Das HTTP-Caching unterliegt Regeln für die Wiederverwendung und Validierung, die in RFC 9111 dokumentiert sind. Geben Sie für Ihren Datensatz außerdem an, wie alt die Beobachtungen sein dürfen, die nachgelagerte Verbraucher tolerieren können.

Testen Sie vor der Planung eine kurze Reihe von Fehlerfällen: ungültige Anmeldedaten, ein fehlendes Pflichtfeld, ein leeres gültiges Ergebnis und einen abgebrochenen Paginierungslauf. Verwenden Sie Testdaten oder eine zugelassene Testumgebung, anstatt unnötigen Datenverkehr beim Anbieter zu erzeugen. Jeder Fall sollte zu einem eindeutigen Ergebnis führen.

„APIs für Anfänger“ wird zu Operational Engineering, wenn diese Ergebnisse Verantwortliche haben. Legen Sie fest, wer sich um Zugriffsprobleme kümmert, wer das Schema-Mapping aktualisiert und wer entscheidet, ob ein unvollständiger Lauf ausgeliefert werden soll. Der Leitfaden zur automatisierten Datenerfassung verbindet diese Prüfungen mit der Planung und der Wiederherstellung.

Halten Sie den ersten Produktions-Workflow eng gefasst. Ein kleiner Collector mit dokumentiertem Umfang und zuverlässiger Validierung lässt sich leichter erweitern als ein umfassender, dessen erfolgreicher Abschluss fehlende Daten verschleiert.

Wichtige Erkenntnisse

  • Lesen Sie den dokumentierten Anforderungsvertrag, bevor Sie einen Client auswählen, einschließlich Methode, Ziel, Parameter, Header und erforderlicher Anmeldedaten.
  • Überprüfen Sie den Antwortstatus, das Darstellungsformat und die Geschäftsfelder separat; gültiges JSON garantiert noch keinen gültigen Produktdatensatz.
  • Behalten Sie Identifikatoren, Originalwerte, Einheiten und den Erfassungskontext bei, damit Datentransformationen nachvollziehbar und reversibel bleiben.
  • Definieren Sie den Abschluss der Paginierung, den Umgang mit Ratenbeschränkungen und das Neustartverhalten, bevor Sie davon ausgehen, dass eine erfolgreiche Anfrage zu einem geplanten Job werden kann.
  • Verwenden Sie explizite Fehlerkategorien und schützen Sie vertrauliche Daten, damit die Wartung nicht vom Kopieren sensibler Anfrageverläufe abhängt.

FAQ

Ist eine API dasselbe wie eine Datenbank?

Nein. Eine Datenbank speichert und verwaltet Daten, während eine API eine Schnittstelle für die Nutzung von Funktionen oder Informationen bereitstellt. Ein Dienst kann mehrere Datenbanken kombinieren oder ein Ergebnis berechnen, ohne diese Details offenzulegen. Nutzer sollten sich auf den veröffentlichten API-Vertrag verlassen, anstatt zu raten, welche interne Tabelle eine Antwort darstellt.

Benötige ich einen Browser, um eine API aufzurufen?

Nicht unbedingt. Viele dokumentierte Web-APIs können von einem serverseitigen HTTP-Client genutzt werden, ohne dass eine Seite gerendert wird. Die Authentifizierungs- und Interaktionsanforderungen des Anbieters bestimmen, was erforderlich ist. Ein Browser kann zum Durchsehen der Dokumentation nützlich sein, aber sein Vorhandensein ersetzt nicht das Verständnis des Anforderungskontrakts oder die korrekte Verarbeitung der Antwort.

Werden bei jeder API Gebühren pro Anfrage erhoben?

Nein. Die Zugangsbedingungen variieren je nach Anbieter und Dienst; prüfen Sie daher den jeweiligen Tarif und die Nutzungsbedingungen. Gehen Sie nicht davon aus, dass eine fehlgeschlagene Anfrage kostenlos ist oder dass eine Testversion dieselben Beschränkungen wie ein anderer Tarif hat. Halten Sie die relevanten Nutzungsregeln bei der Integration fest, damit geplante Aufgaben im vorgesehenen Rahmen bleiben.

Fazit

Ihr erster Meilenstein ist ein Datensatz, den Sie erklären können: Welche Operation hat ihn geliefert, was bedeutet jedes Feld, wann wurde er erfasst und warum hat er die Validierung bestanden? Das ist nützlicher als ein Skript, das einen unbekannten Body ausgibt und erfolgreich beendet wird.

Wiederholen Sie die fiktive Katalogübung für einen echten Anbieter anhand dessen Dokumentation. Notieren Sie die Anfrageparameter, bewahren Sie die ursprüngliche Bedeutung der Antwort bei und ermitteln Sie die genaue Bedingung, die die Datenerfassung beendet. Testen Sie dann einen fehlgeschlagenen Fall, bevor Sie weitere Seiten oder einen Zeitplan hinzufügen. So bleiben APIs für Anfänger auf ein Verhalten beschränkt, das Sie überprüfen können.

Falls die benötigten Informationen nur über Webseiten verfügbar sind, ziehen Sie die Scraper-API von WebScrapingAPI als Erfassungsoption in Betracht. Wenden Sie bei diesen Eingaben dieselben Vorgehensweisen an: Schützen Sie Zugangsdaten, überprüfen Sie die Antwort, validieren Sie den extrahierten Datensatz und bewahren Sie genügend Kontext auf, damit auch andere das Ergebnis nachvollziehen können.

Über den Autor

Robert Munceanu, Full-Stack-Entwickler @ WebScrapingAPI

Robert Munceanu

Full-Stack-Entwickler

Robert Munceanu ist Full-Stack-Entwickler bei WebScrapingAPI, wo er in allen Bereichen des Produkts mitwirkt und an der Entwicklung zuverlässiger Tools und Funktionen zur Unterstützung der Plattform mitwirkt.

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.