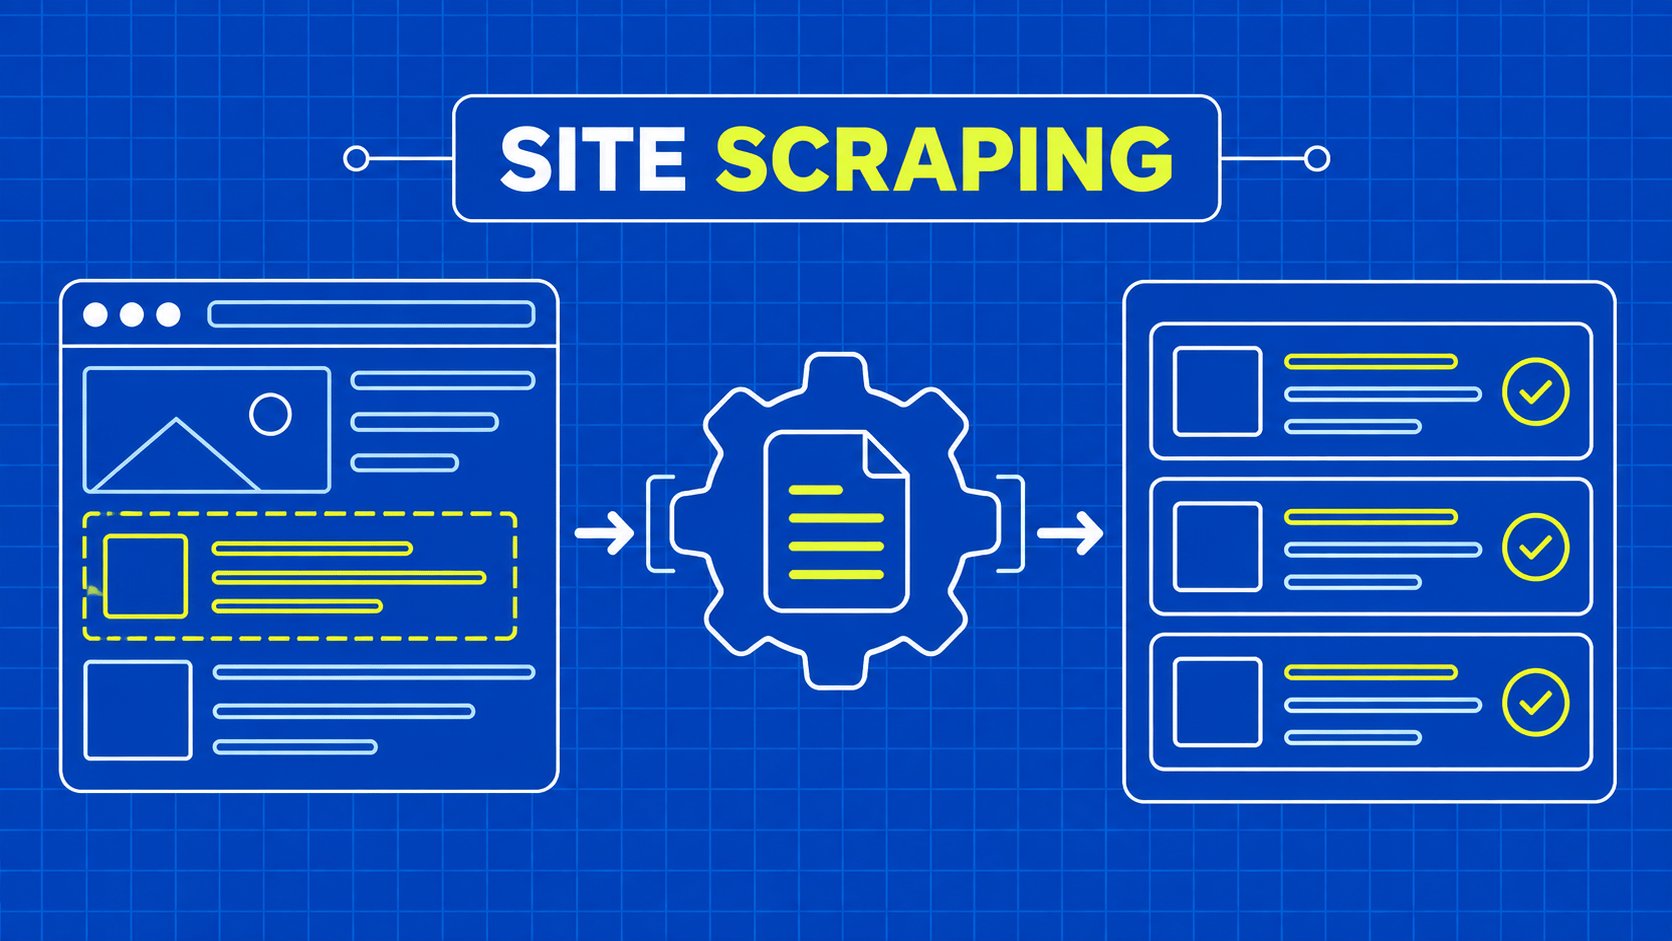
TL;DR: Ein nützlicher Website-Scraper wandelt eine genehmigte Auswahl von Seiten in Datensätze mit definierter Bedeutung um, überprüft diese Datensätze und liefert einen identifizierbaren Datensatz. Beginnen Sie mit dem Umfang der Datensätze und der Erfassung, wählen Sie ein Ausführungsmodell, das die Daten erreicht, und testen Sie Navigation, fehlende Werte und Wiederherstellung, bevor Sie den Vorgang planen.
Angenommen, Sie benötigen ein wöchentliches Verzeichnis von Organisationen von einer Website, für deren Datenerfassung Sie autorisiert sind. Jede Zeile sollte einen Namen, eine Adresse, eine Quell-URL und den Zeitpunkt der Erfassung enthalten. Ein Website-Scraper ist der Software-Workflow, der die relevanten Seiten aufruft und diese Felder extrahiert, doch ein zuverlässiger Datenerfasser prüft auch, ob die resultierenden Zeilen verwertbar sind.
Das Extrahieren von Text aus einer Seite ist nur das erste Problem. Sie müssen entscheiden, welche Seiten in den Umfang gehören, ob mehrere Einträge dieselbe Organisation beschreiben, wie eine fehlende Adresse dargestellt werden soll und was der Nutzer tun soll, wenn der nächste Durchlauf auf halbem Weg abbricht. Diese Entscheidungen bestimmen, ob die Ausgabe Berichts- oder Anwendungsfunktionen unterstützen kann.
Dieser Leitfaden verfolgt das Beispiel des Verzeichnisses vom Datensatzentwurf bis zur Bereitstellung. Es handelt sich um einen praktischen Leitfaden für Design und Auswahl und nicht um eine Rangliste austauschbarer Produkte. Sie können die Methode auf ein visuelles Tool, einen HTTP-basierten Collector oder eine Browser-Automatisierung anwenden, vorausgesetzt, die gewählte Implementierung stellt die Steuerelemente und Nachweise bereit, die Ihr Workflow benötigt.
Beginnen Sie mit einer kleinen, genehmigten Stichprobe, die jemand manuell überprüfen kann. Erweitern Sie den Umfang erst, wenn der Datenerfasser erklären kann, welche Seiten er besucht hat, welche Daten er akzeptiert hat und was noch unklar ist.