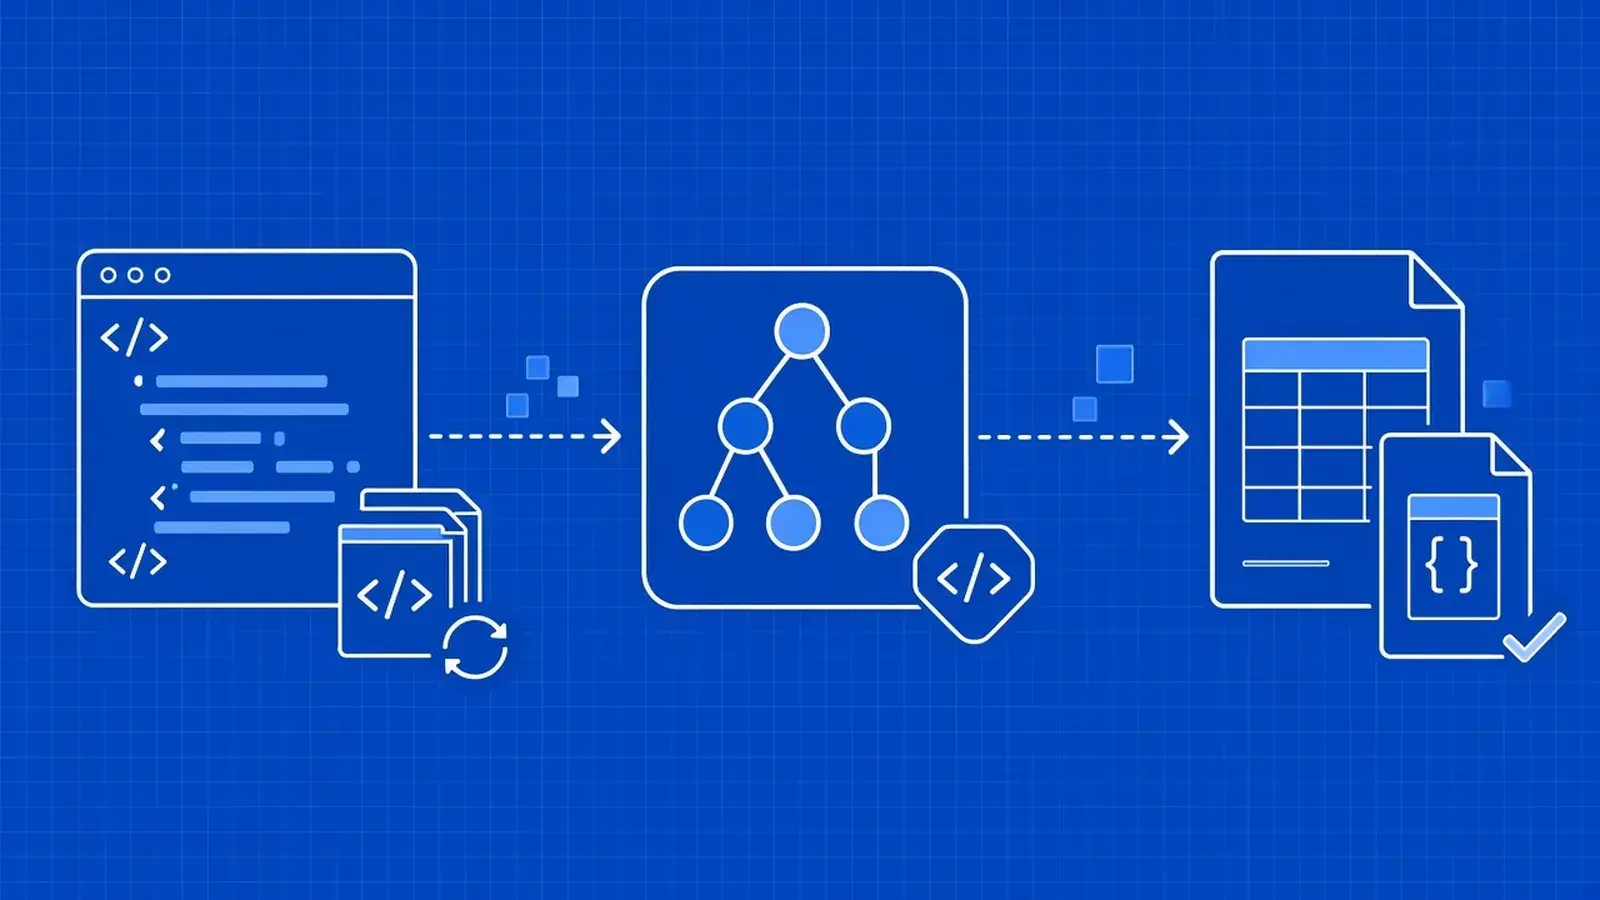
Kurzfassung: Cheerio ist ein schneller HTML-Parser für Node.js mit einer API im jQuery-Stil und eignet sich daher für Web-Scraping, wenn die Daten bereits im rohen HTML der Seite stehen. Nutzen Sie fetch plus Cheerio für statische Seiten, rufen Sie das JSON der Seite direkt ab, wenn sie ihre Daten so lädt, und rendern Sie nur dann mit einem Browser, wenn JavaScript den Inhalt aufbaut. Dieser Leitfaden baut einen getesteten Scraper mit Paginierung, Wiederholungen und JSON- oder CSV-Export.
Am Ende dieser Anleitung verfügen Sie über einen Cheerio-Scraper, der eine Seite lädt, Eingabefelder extrahiert, der Paginierung folgt, bei Serverfehlern höflich erneut versucht, die Ergebnisse als JSON und CSV speichert und einen Offline-Test besteht. Die Live-Beispiele verwenden books.toscrape.com und quotes.toscrape.com, zwei Übungsseiten, die speziell für das Scraping erstellt wurden, sodass du den Code unverändert ausführen kannst. Außerdem lernst du, welche Seiten Cheerio nicht lesen kann, und wie du die „cheerio.load“-Fehler behebst, an denen die meisten Nutzer scheitern. Bist du neu im Bereich Web-Scraping mit Node? Beginne mit unserem Leitfaden zum Web-Scraping mit JavaScript und Node.js.