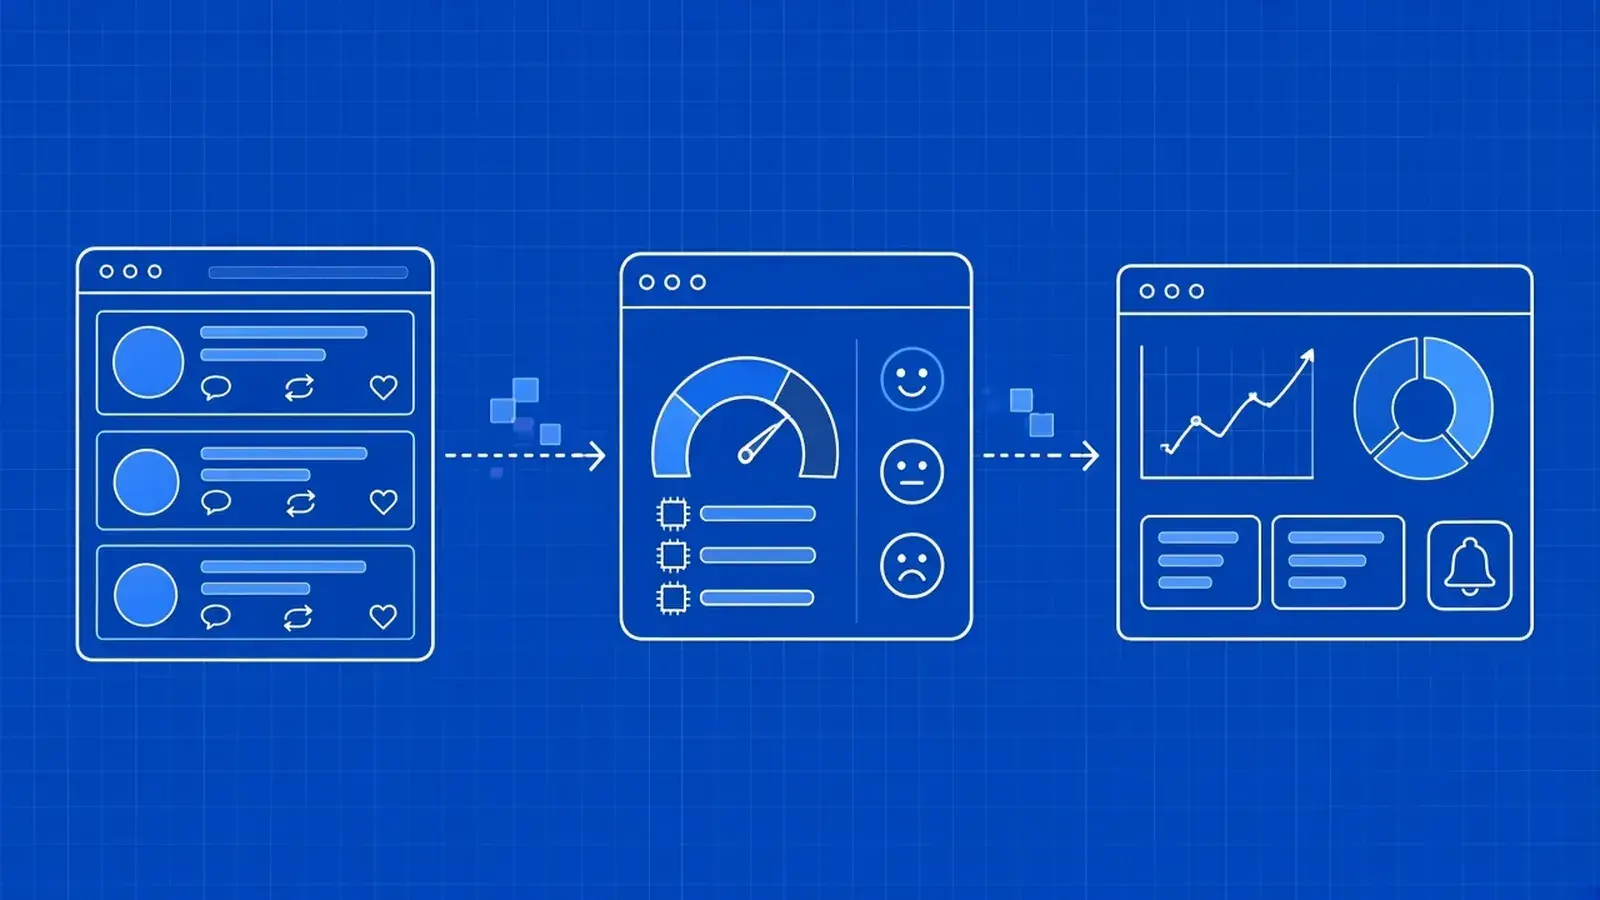
Ein Marketingteam möchte wissen, wie die Nutzer von X (Twitter) zu seiner Marke, einer Produkteinführung oder einem Wettbewerber stehen, und jemand muss die Beiträge sammeln und bewerten. Unter dem Datenscraping auf Twitter (X) versteht man das programmgesteuerte Sammeln öffentlicher Beiträge, Profile und Interaktionszahlen von X, um diese anschließend in großem Umfang analysieren zu können. Bevor Sie mit dem Scraping auf Twitter beginnen, sollten Sie wissen, dass X das Scraping in seinen Nutzungsbedingungen einschränkt. Dieser Leitfaden beginnt mit der Frage, was Sie erfassen dürfen und was die Regeln von X besagen, vergleicht die offizielle API, verwaltete Daten und gerenderte öffentliche Seiten und behandelt anschließend den Teil, den die meisten Leitfäden auslassen: die Bereinigung der Beiträge, die Bewertung der Stimmung in Python und die Umwandlung der Bewertungen in Kennzahlen, die ein Marketingteam nutzen kann.
Wichtige Erkenntnisse
- Die Nutzungsbedingungen von X verbieten das Crawlen oder Scrapen ohne vorherige schriftliche Zustimmung; wählen Sie daher Ihren Zugriffsweg, bevor Sie Code schreiben.
- Die offizielle X-API ist der dokumentierte Weg für die Stichwortsuche und die fortlaufende Überwachung.
- Auf Seiten, auf denen man nicht angemeldet ist, werden nur begrenzte Daten angezeigt. Die Suche, vollständige Timelines und Follower-Listen sind nur nach der Anmeldung zugänglich.
- Speichern Sie jeden Beitrag mit seiner ID und zwei Zeitstempeln: dem Zeitpunkt der Veröffentlichung und dem Zeitpunkt der Erfassung.
- Beginnen Sie mit einer VADER-Baseline, wechseln Sie zu einem auf Twitter abgestimmten Transformer und aggregieren Sie die Ergebnisse anschließend zu einer Netto-Stimmung und einem Share of Voice.