
Zum Inhalt springen
Zurück zum Blog

Die besten Web-Scraping-APIs im Jahr 2026: 12 im Vergleich nach Einsatzbereich und Kosten

Suciu DanZuletzt aktualisiert am 25 min read
Die besten Web-Scraping-APIs im Jahr 2026: 12 im Vergleich nach Einsatzbereich und Kosten
Kurzfassung: Die beste Web-Scraping-API hängt von der Aufgabe ab: Eine günstige Seiten-API gewinnt bei statischem HTML, ein Render-Flag oder gehosteter Browser bei JavaScript-lastigen Apps, ein SERP- oder E-Commerce-Endpunkt bei geparsten Datensätzen und eine Markdown-orientierte API bei LLM-Pipelines. Wählen Sie zwei oder drei Anbieter aus und vergleichen Sie die Kosten pro nutzbarer Seite auf Ihren eigenen URLs, denn Credit-Multiplikatoren und die Abrechnung fehlgeschlagener Anfragen bestimmen die echten Kosten.

Welche Web-Scraping-API die beste ist, hängt von der jeweiligen Aufgabe ab. Einfache HTML-Seiten, JavaScript-lastige Apps, geschützte Websites, Suchergebnisse, E-Commerce-Daten und LLM-fähige Texte erfordern jeweils unterschiedliche Tools. Dieser Leitfaden vergleicht 12 Anbieter nach Aufgabenbereichen, erläutert die tatsächlichen Kosten pro erfolgreicher Seite und zeigt, wie Sie sie an Ihren eigenen Zielen testen können.

Er richtet sich an Entwickler- und Datenteams, die eine Vorauswahl treffen möchten, wie sie Webdaten erfassen können. WebScrapingAPI ist einer der 12 Anbieter und unser Produkt. Im Gegensatz zu No-Code-Scrapern lässt sich eine API in HTTP-Pipelines integrieren, in denen der Anbieter Proxys, Wiederholungsversuche und Browser betreibt.

Wichtige Erkenntnisse

  • Passen Sie die API an die Arbeitseinheit (Seite, Suchergebnis, Produktdatensatz, Crawl oder Markdown) an, nicht an ein generisches „Best“-Label.
  • Der angegebene Preis pro 1.000 Anfragen ist irreführend; Kreditmultiplikatoren und die Abrechnung fehlgeschlagener Anfragen bestimmen Ihre tatsächlichen Kosten.
  • Testen Sie mit Ihren eigenen URLs, überprüfen Sie den Inhalt statt der Statuscodes und vergleichen Sie die Kosten pro nutzbarer Seite.
  • Proxys, gehostete Browser, Open-Source-Bibliotheken und gekaufte Datensätze lösen andere Aufgaben als eine Scraping-API.
  • WebScrapingAPI vereint Proxys, Seiten-, SERP-, Browser-, Crawl- und Daten-APIs unter einem Anbieter; es ist jedoch nicht die erste Wahl für Markdown „out of the box“ oder einen Community-Scraper-Marktplatz.
Welche Web-Scraping-API eignet sich am besten für Ihre Aufgabe?

Passen Sie die API an die jeweilige Aufgabe an. Eine kostengünstige Seiten-API eignet sich am besten für statisches HTML; ein Render-Flag oder ein gehosteter Browser für JavaScript; ein SERP- oder E-Commerce-Endpunkt, wenn Sie geparste Datensätze benötigen; eine auf Markdown ausgerichtete API für LLM-Pipelines. Wählen Sie zwei oder drei Anbieter in die engere Wahl und vergleichen Sie dann die Kosten pro nutzbarer Seite für Ihre Zielseiten.

Aufgabe

Was zählt

Gute Passungen

Achten Sie auf

Statisches HTML in großem Umfang

Niedrige Grundkosten, Parallelität, Geotargeting

WebScrapingAPI, Scrape.do, Scrapingdog

Kosten für die Standard-JavaScript-Rendering-Funktion, die Sie nicht benötigen

JavaScript-lastige Seiten

Rendering auf Abruf, Wartezeiten

ScrapingBee, WebScrapingAPI, ZenRows

Render-Multiplikatoren (oft 5× oder mehr)

Seiten, die Klicks oder Anmeldungen erfordern

Gehosteter Browser mit Aktionen

WebScrapingAPI-Browser-API, Bright Data, ZenRows-Browsersitzungen

Produkte, die jede Browseranfrage in Rechnung stellen, unabhängig vom Erfolg oder Misserfolg

Stark geschützte Websites

Privat- oder Premium-Proxys, Wiederholungsversuche, Blockierungserkennung

Bright Data, Oxylabs, Zyte, WebScrapingAPI

Domain-Zuschläge und falsche 200-Block-Seiten

Google und andere Suchergebnisse

Preise für dedizierte SERP-Endpunkte oder Domains

WebScrapingAPI SERP-API, Oxylabs, Scrapingdog

Allgemeine APIs, die Suchdomänen mit 25+ Credits abrechnen

E-Commerce und Amazon

Pflege von Produkt-Parsern

WebScrapingAPI Data API, Oxylabs, Scrapingdog, ScraperAPI

Erstellung eigener Amazon-Parser für sich ändernde Markups

LLM-kompatibles Markdown

Standardmäßig Markdown (oder reiner Text)

Firecrawl, Decodo, ZenRows

HTML selbst konvertieren, wenn man nur bestimmte Felder benötigt

Crawlen einer gesamten Website

Endpunkte crawlen/abbilden, robots.txt beachten

Firecrawl, Decodo, WebScrapingAPI Crawl-API

Crawling ohne Budget oder Sitemap-Strategie

Strukturierte Datensätze ohne Parser

Datensatz-APIs oder KI-Extraktion

WebScrapingAPI-Daten-API, Zyte, Oxylabs

Wer ist für die Wartung der Parser zuständig, wenn sich das Markup ändert?

Regelmäßige Datensätze nach Zeitplan

Feeds, Marktplatz oder verwaltete Bereitstellung

WebScrapingAPI Managed Data / Daten-Feeds, Bright Data-Datensätze

Kosten für das erneute Scraping stabiler Schemata, die man kaufen könnte

Was ist eine Web-Scraping-API?

Eine Web-Scraping-API ist ein gehosteter Endpunkt, der eine URL (oder eine Abfrage) entgegennimmt und die Seite oder die Daten zurückgibt, während der Anbieter sich um Proxys, Wiederholungsversuche, Browser und die Behandlung von Blockierungen kümmert. Sie zahlen pro Anfrage oder pro Guthabenpunkt; das Parsen und die Speicherung bleiben in Ihrer Verantwortung, es sei denn, die API gibt strukturierte Felder zurück.

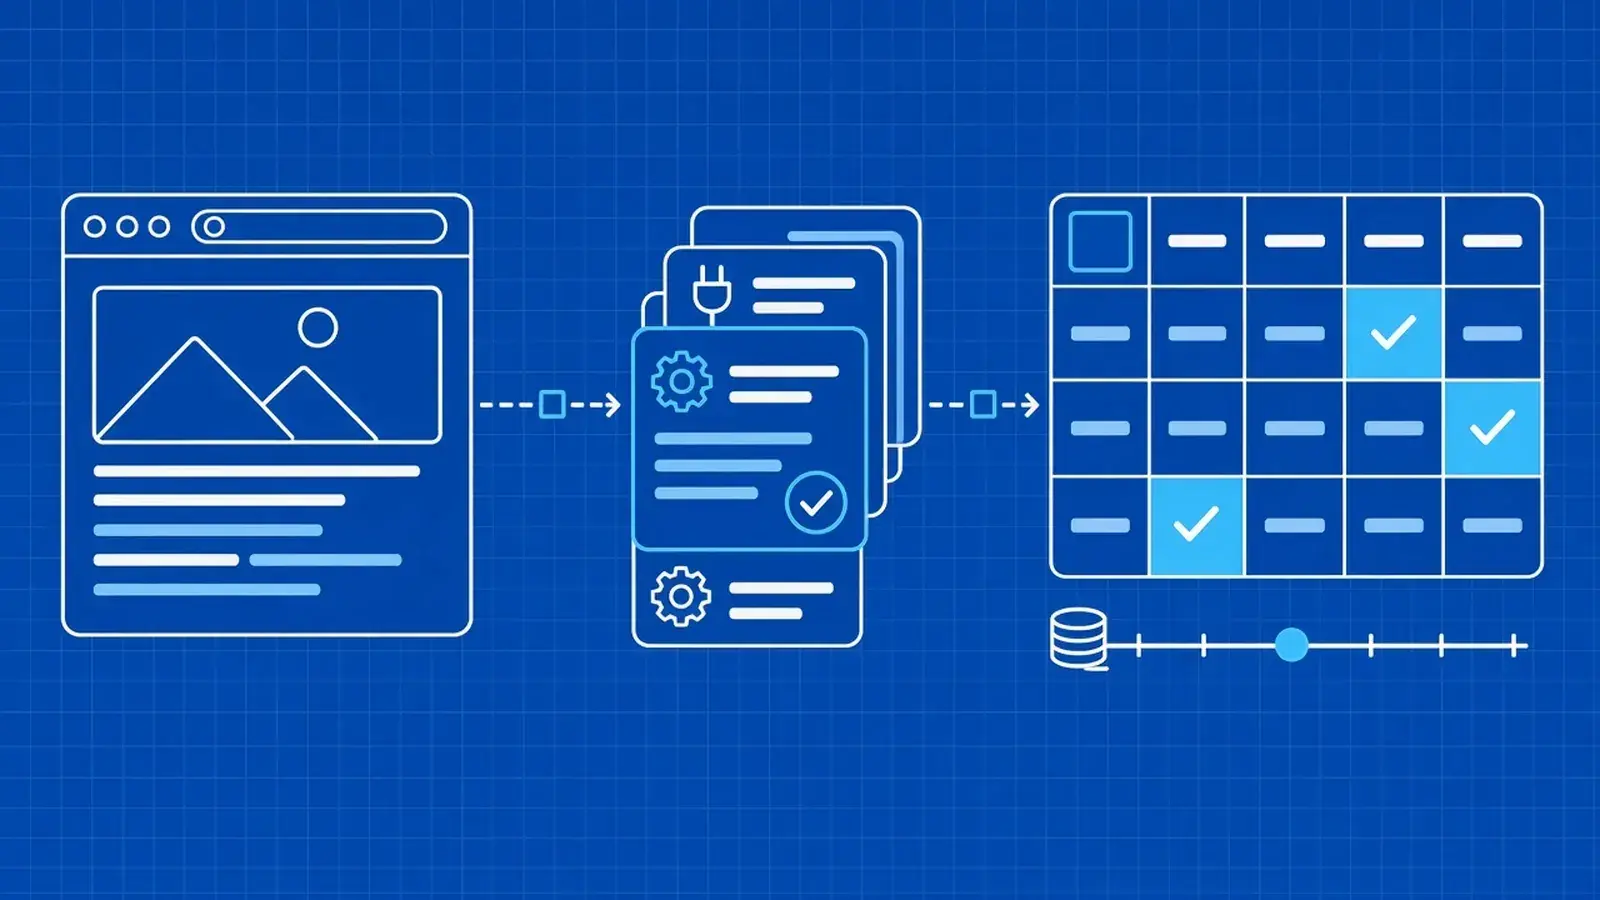
So verarbeitet eine Web-Scraping-API eine Anfrage

Ein typischer Anforderungsablauf:

  1. Ihr Client sendet eine URL, Authentifizierungsdaten sowie gegebenenfalls Geo- oder Render-Flags.
  2. Der Anbieter wählt einen Proxy-Typ und einen Standort für das Ziel aus.
  3. Wenn JavaScript ausgeführt werden muss, lädt ein Headless-Browser die Seite.
  4. CAPTCHAs, Herausforderungen und leere Body-Inhalte lösen Wiederholungsversuche oder alternative Routen aus.
  5. Sie erhalten HTML, JSON, ausgewählte Felder oder eine strukturierte Fehlermeldung.

HTTP-Status und nutzbarer Inhalt werden separat geprüft. Der HTTP-Semantik-Standard (RFC 9110) beschreibt, was Statuscodes für den Datenaustausch bedeuten; er gibt jedoch keinen Aufschluss darüber, ob der Body den von Ihnen benötigten Produktpreis enthält. Eine Blockierungsseite kann dennoch einen HTTP-Status 200 zurückgeben.

Web-Scraping-API vs. andere Web-Scraper: Was benötigen Sie?

Ansatz

Wer übernimmt Routing / Browser / Parsing

Erforderliche Kenntnisse

Am besten geeignet für

Scraping-API

Der Anbieter übernimmt das Routing und die Browser; Sie führen das Parsing durch (es sei denn, Felder werden zurückgegeben)

HTTP-Client

Die meisten Aufgaben im Bereich Produktionsseiten und SERPs

Proxy-Netzwerk

Sie führen den Client, Wiederholungsversuche und das Parsen aus

Scraping-Stack

Volle Kontrolle über Sitzungen und Fingerabdrücke

Gehosteter Browser

Der Anbieter betreibt den Browser; Sie steuern die Aktionen

Browser-Automatisierung

Anmeldungen, Klicks, Screenshots

Open-Source-Bibliothek (Scrapy, Playwright)

Sie führen alles aus

Entwicklungsaufwand

Stabile, schwach geschützte Ziele, die Sie von Anfang bis Ende selbst verwalten

No-Code-/Desktop-Scraper

Anbieter-Benutzeroberfläche; eingeschränkte Automatisierung

Low-Code

Einmalige Exporte und Teams ohne technische Kenntnisse

Gekaufte Datensätze / Feeds

Anbieter liefert Datensätze

Integration

Wiederkehrende Felder aus bekannten Quellen

Wenn Sie lieber eine Bibliothek oder ein Point-and-Click-Tool nutzen möchten, finden Sie in unserer Übersicht über die besten Web-Scraping-Tools sowohl Frameworks als auch No-Code-Optionen.

Wie wählt man eine Web-Scraping-API aus?

Gehen Sie von der Aufgabe und dem von Ihrer Pipeline benötigten Ergebnis aus, prüfen Sie dann, wie die einzelnen Anbieter diese Aufgabe abrechnen (Multiplikatoren, fehlgeschlagene Anfragen), und testen Sie anschließend anhand einer Stichprobe Ihrer echten URLs.

Statische HTML-Seiten in großem Umfang

Sie benötigen eine kostengünstige Basisabfrage, ausreichende Parallelität und Geotargeting, das zu Ihren Quellen passt. Das Rendern ist hier eine unnötige Kostenquelle. Einige APIs rendern standardmäßig: ScrapingBee dokumentiert JavaScript-Rendering als Standard mit 5 Credits pro Anfrage. Deaktivieren Sie das Rendern, wenn der HTML-Code bereits in der ersten Antwort enthalten ist.

JavaScript-intensive Seiten

Verwenden Sie ein Render-Flag, wenn Inhalte erst nach dem ersten Laden erscheinen (render_js=1 in der Scraper-API von WebScrapingAPI standardmäßig deaktiviert). Für Wartezeiten, Klicks oder Screenshots erspart dir ein gehosteter Browser, den du über eine REST-API steuerst, den Betrieb einer eigenen Browserflotte. Gehostete Browser werden in der Regel über das Chrome DevTools-Protokoll gesteuert.

Websites mit starkem Anti-Bot-Schutz

Websites wehren automatisierten Datenverkehr aus guten Gründen ab. Im OWASP-Katalog automatisierter Bedrohungen wird Scraping als OAT-011 aufgeführt. Eine Scraping-API verändert die Rahmenbedingungen, indem sie IP-Reputation, Browser-Fingerabdrücke und Wiederholungsversuche für Sie verwaltet. Definieren Sie Erfolg als validierten Inhalt: WebScrapingAPI dokumentiert, dass eine CAPTCHA-Seite, die als HTTP 200 zurückgegeben wird, möglicherweise als fehlgeschlagener Scrape (422) und nicht als gültiger Inhalt klassifiziert wird. Unser Leitfaden zum Web-Scraping ohne Blockierung führt Sie durch jede Verteidigungsschicht.

Suchergebnisse

Ein dedizierter SERP-Endpunkt liefert geparste Ergebnisse; eine allgemeine Seiten-API liefert HTML, das Sie selbst parsen. Domain-Aufschläge bei allgemeinen APIs summieren sich: In den FAQ zur Preisgestaltung von ScraperAPI werden Google und Bing mit 25 Credits pro Anfrage aufgeführt. Wir vergleichen die spezialisierten Optionen in unserem Testbericht über die besten SERP-APIs.

E-Commerce- und Amazon-Daten

Spezielle Datensatz-APIs (die Data-API von WebScrapingAPI mit veröffentlichten Amazon-Tarifen; Amazon-Ziele bei Oxylabs, Scrapingdog und ScraperAPI) sind in der Regel besser als das eigenständige Scraping von Produkt-HTML, da der Anbieter die Parser wartet. Für Long-Tail-Shops sollten Sie eine allgemeine Scraping-API mit Rendering und Geotargeting sowie Ihren eigenen Extraktionsregeln verwenden. Um zu sehen, was die eigene Umsetzung beinhaltet, folgen Sie unserer praktischen Anleitung zum Scraping von Amazon-Produktdaten mit Python.

LLM-fähiges Markdown für KI-Pipelines

Markdown reduziert den Programmcode für RAG und Agenten; HTML oder JSON sind besser geeignet, wenn Sie exakte Felder wie Preise benötigen. Firecrawl, Decodo und ZenRows dokumentieren die Markdown-Ausgabe. WebScrapingAPI gibt HTML, einen JSON-Umschlag oder ausgewählte Felder zurück, die Sie selbst konvertieren können, wenn Markdown lediglich der Einfachheit halber dient. Wir behandeln LLM-basierte Extraktoren separat in unserer Liste der KI-Web-Scraping-Tools.

Eine gesamte Website crawlen

Durch das Crawlen und Kartieren von Endpunkten (Firecrawl, Decodo und die Crawl-API von WebScrapingAPI, deren Umfang durch ein Zitat begrenzt ist) lassen sich viele URLs in einem einzigen Workflow ermitteln und abrufen. Die Alternative ist ein eigener Crawler, der pro URL eine Seiten-API aufruft. Beachten Sie in jedem Fall das Robots Exclusion Protocol (RFC 9309).

Strukturierte Datensätze ohne Programmierung von Parsern

Pflege von Datensatz-APIs (die Data API von WebScrapingAPI listet 116 unterstützte Quellen auf; Zyte und Oxylabs bieten KI-basiertes Parsing an) verlagert die Pflege der Parser auf den Anbieter. Mit Ihren eigenen Selektoren und Extraktionsregeln behalten Sie die volle Kontrolle, sind jedoch selbst für Fehler verantwortlich, wenn sich das Markup ändert. Die eigentliche Entscheidung ist, wer für diese Pflege zuständig ist.

Wie haben wir diese Web-Scraping-APIs verglichen?

Wir haben die öffentlichen Preisseiten und Dokumentationen der einzelnen Anbieter gelesen und die Abrechnungseinheit, Multiplikatorregeln, die Abrechnung fehlgeschlagener Anfragen, Ausgabeformate sowie spezielle Endpunkte verglichen. Wir veröffentlichen keine Ranglisten zur Erfolgsquote, da die Ergebnisse je nach Ziel und Woche schwanken; führen Sie stattdessen den untenstehenden Test mit Ihren eigenen URLs durch. WebScrapingAPI ist unser Produkt; alle anderen Anbieter werden anhand ihrer eigenen öffentlichen Seiten genannt.

Web-Scraping-APIs im Vergleich

Anbieter

Am besten geeignet für

Kostpflichtiger Einstiegstarif

Kostenlos / Testversion

Abrechnungseinheit

Multiplikatoren

Werden fehlgeschlagene Anfragen in Rechnung gestellt?

Ausgaben

Spezialisierte Endpunkte

Auch Proxys / Datensätze?

WebScrapingAPI (unser Produkt)

Seite + SERP + Amazon bei einem Anbieter

Scraper-API-Starter 19 $/Monat, 7.000 Anfragen

5.000 Scraper-API-Anfragen

Anfragen (Scraper API)

Keine bei der Scraper-API: JS-Rendering und Geotargeting kosten keine zusätzlichen Credits

Scraper-API: nein; Browser-API: ja (erfolgreich und fehlgeschlagen)

HTML, JSON-Envelope, ausgewählte Felder, Screenshots

SERP, Daten (Amazon), Browser, Crawling

Ja (Privathaushalte, Rechenzentren, Internetdienstanbieter; Datensätze und Managed Data)

Bright Data

Freischaltung nach Erfolg

Web Unlocker PAYG 1,50 $ / 1.000 Anfragen

5.000 Anfragen/Monat

Pro Anfrage

Produktbasiert (Unlocker)

Nein („nur bei Erfolg bezahlen“)

HTML / geparste Auslieferungsoptionen

Web Unlocker (andere Produkte separat)

Ja

Oxylabs

Preise für die Web-API pro Ziel

Starter 30 $/Monat (gemeinsames Abonnement)

5 $ Willkommensguthaben

Pro 1.000 Ergebnisse pro Ziel

/Scrape ab 0,50 $/1.000; Google JS 1,35 $; Google ohne JS 1,00 $; KI-Parsing 3,00 $/1.000 (Einstiegsstufe)

—

HTML, geparste Ergebnisse

Amazon, Google, ChatGPT, Scraping/Suche

Ja

Zyte

Gestaffelte Website-Schwierigkeitsgrade

Pay-as-you-go oder Verträge ab 100 $/Monat

5 $ Gratisguthaben (30 Tage)

Pro 1.000 erfolgreiche Antworten je nach Website-Stufe

HTTP PAYG 0,13–1,27 $ pro 1.000; browserbasiert 1,01–16,08 $ pro 1.000

Erfolgreiche Antworten

HTTP-Body, browsergerendert

KI-Extraktion / Zyte-API

Datensätze (Zyte-Daten)

ScrapingBee

Credit-API mit Standard-JS

Freelance 49 $/Monat, 250.000 Credits

1.000 Credits

Credits

Classic ohne JS: 1; JS-Standard: 5; Premium: 10/25; Stealth-JS: 75

Auto-Modus: 0 Credits, wenn alle Konfigurationen fehlschlagen

HTML, Screenshots, Extraktionsregeln

Spezielle Scraping-APIs in höheren Tarifen

Nein (API-fokussiert)

ScraperAPI

Zuschläge für Domain-Credits

Hobby 49 $/Monat, 100.000 Credits (Standorte in den USA und der EU)

Testversion mit 5.000 Credits; kostenloser Tarif mit 1.000 Credits

Credits

Standard 1; Amazon 5; Google/Bing 25; LinkedIn 30

—

HTML, Produkte mit strukturierten Daten

E-Commerce-/SERP-strukturierte APIs

Nein (API-fokussiert)

Firecrawl

Markdown und Crawling/Zuordnung für KI

Hobby 19 $/Monat, monatliche Abrechnung (16 $ jährlich), 5.000 Credits

1.000 Credits/Monat

Credits

1 pro Seite; Suche: 2/10 Ergebnisse; Interaktion: 2/Browser-Minute; JSON/Frage/Hervorhebung +4

Keine Ergebnisse werden nicht berechnet; 403/404 kosten 1 Credit

Markdown-, HTML- und JSON-Formate

Scrapen, Crawlen, Zuordnen, Suchen, Interagieren

Nein

Decodo

Markdown-Scraping/Crawling zum Einstiegspreis

19 $/Monat für bis zu 38.000 Seiten oder 19.000 Crawls

Kostenloser Tarif für bis zu 10.000 Seiten oder 5.000 Crawls

Seiten oder Crawls

JS und Premium-Proxys optional (bei Bedarf aktivieren)

—

HTML, Markdown, JSON, CSV, PNG

/scrape, /search, /map, /crawl

Proxys (derselbe Anbieter)

ZenRows

Günstiger Einstiegstarif + Rabatt

Build 16 $/Monat, 45.000 Credits (monatliche Abrechnung)

5.000 Credits/Monat

Credits

Standard 1; JS 5; Premium 10; JS+Premium 25

Nur erfolgreiche Zugriffe; 404/410 gelten als erfolgreich

HTML, Markdown, JSON, Screenshot

Abrufen, Extrahieren, Stapelverarbeitung, Browsersitzungen

Privathaushalts-Bandbreite wird in Credits abgerechnet

Scrapingdog

Einfache Credit-Stufen, Fehlversuche werden erstattet

Lite 40 $/Monat, 200.000 Credits

100 Credits

Credits

Standard 1; JS 5; Premium 10; JS+Premium 25

Nein („fehlgeschlagene Anfragen werden nie berechnet“)

HTML, JSON

SERP- und E-Commerce-APIs

Nein

Scrape.do

Erfolgreiche Credit-Pläne, freigeschaltete Funktionen

Hobby 29 $/Monat, 250.000 „Successful Credits“

1.000 erfolgreiche Credits

Erfolgreiche Credits

—

Nein (erfolgreiche Antworten mit gültigem Inhalt)

HTML-/Browser-Funktionen

Allgemeines Scraping mit Browser-Ausführung

Im Produkt enthaltene Proxys

Apify

Marktplatz für Akteure + Rechenleistung

Starter-Paket 19 $/Monat + PAYG

5 $ Plattformnutzung/Monat

Rechenleistungseinheiten (0,20 $ im Starter-Paket) + Preise für Actors

Aktorabhängig

Plattform-/Akteur-spezifisch

Vom Akteur definiert

Store-Actors, benutzerdefinierte Scraper

Proxys als Add-ons

Die Preise entsprechen den zum Zeitpunkt der Erstellung dieses Artikels angegebenen Werten. Da sich die Tarife häufig ändern, sollten Sie sich vor dem Kauf auf der Website des jeweiligen Anbieters vergewissern.

Die 12 besten Web-Scraping-APIs im Test

WebScrapingAPI

WebScrapingAPI ist unser Produkt: eine umfassende Palette, die von Residential-, Datacenter- und ISP-Proxys über Scraper-, Browser-, SERP-, Crawl- und Daten-APIs bis hin zu Datenfeeds, Datenmarktplatz, Webarchiv und verwalteten Daten reicht. Es eignet sich für Teams, die das Sammeln von Seiten, Suchergebnissen, Amazon-Datensätzen und Proxys bei einem einzigen Anbieter bündeln möchten, mit einer veröffentlichten Scraper-API-Testversion für 5.000 Anfragen – allerdings ohne sofort einsatzbereite Markdown-Funktionen oder einen Marktplatz für von der Community erstellte Scraper.

Der „Scraper API Starter“-Tarif kostet 19 $/Monat für 7.000 Anfragen (Basic 49 $/20.000; bis hin zu Pro 599 $/450.000). Jeder Scraper-API-Tarif umfasst JavaScript-Rendering, Geotargeting für alle Länder, Proxy-Rotation und Anti-Bot-Maßnahmen sowie automatisches Parsing; Rendering und Geotargeting verursachen keine zusätzlichen Credits, und fehlgeschlagene Scraper-API-Anfragen werden nicht in Rechnung gestellt. Die Google-Tarife für die SERP-API beginnen bei 28 $/Monat; Amazon-Data-API-Tarife beginnen bei 59 $/Monat; Managed-Data-Programme beginnen bei 299 $/Monat. Die Preise für Browser-, Crawl-, Datacenter- und ISP-Produkte werden auf Anfrage angeboten. Die Scraper-API gibt bei einer einzelnen Anfrage eine Seite, einen JSON-Envelope oder ausgewählte Felder zurück, und die Dokumentation enthält Angaben pro Anfrage cost sowie WSA-Call-Credit-Usage Header pro Anfrage. Vergleichen Sie statische mit render_js=1 an Ihren URLs und lesen Sie die Guthaben-Header.

Bright Data

Der Web Unlocker von Bright Data ist eine nach Anfragen abgerechnete Entsperr-API für gesperrte Ziele, die auf einer Proxy-Infrastruktur basiert. Am besten geeignet für die erfolgsabhängige Entsperrung mit unbegrenzter Parallelität bei den veröffentlichten Unlocker-Tarifen; nicht ideal für eine einfache, kreditbasierte Seiten-API ohne Unlocker-ähnliche Bündelung.

„Pay as you go“ kostet 1,50 US-Dollar pro 1.000 Anfragen; „Scale“ kostet 499 US-Dollar/Monat bei 383.000 Anfragen, danach 1,30 US-Dollar pro 1.000; kostenlose Stufe: 5.000 Anfragen/Monat. Auf der Preisseite wird angegeben, dass nur für erfolgreiche Anfragen bezahlt wird, und es wird darauf hingewiesen, dass die Preise in US-Dollar verbindlich sind, auch wenn Schätzungen in lokaler Währung angezeigt werden.

Oxylabs

Oxylabs bietet ein Web-API-Abonnement an, das Scraping- und Suchprodukte abdeckt, wobei die Preise pro Ziel und 1.000 Ergebnisse berechnet werden. Am besten geeignet für ein einziges Abonnement für Scraping- und Suchziele mit klaren Tarifen pro Website; nicht für ein einziges Pauschalguthaben für jede Domain.

Starter 30 $/Monat, Basic 100 $/Monat, Flexible 500 $/Monat, Enterprise ab 2.500 $/Monat, plus ein Willkommensguthaben von 5 $. Beispiele für Einstiegstarife auf der Preisseite sind /Scrape ab 0,50 $ pro 1.000 Ergebnisse, Google JS für 1,35 $, Google ohne JS für 1,00 $ und KI-Parsing für 3,00 $ pro 1.000 geparste Seiten. Vergleichen Sie Ihren tatsächlichen Zielmix mit den Preisen pro 1.000 Zeilen für diese Domains.

Zyte

Die Zyte-API stuft Websites in fünf Schwierigkeitsstufen für HTTP- und browsergerenderte Antworten ein, mit Pay-as-you-go- und monatlichen Verträgen. Am besten geeignet für Workloads, bei denen der Schwierigkeitsgrad der Websites variiert und Sie eine automatische Auswahl zwischen HTTP und Browser wünschen; nicht für einen festen Credit-Preis unabhängig von der Domain.

Testen Sie den Dienst mit 5 $ Gratisguthaben (30 Tage). PAYG-HTTP-Antworten kosten zwischen 0,13 $ und 1,27 $ pro 1.000; browsergerenderte Antworten zwischen 1,01 $ und 16,08 $ pro 1.000. Bei einer monatlichen Mindestabnahme von 100 $ liegen die Preise laut Preisseite für HTTP-Antworten zwischen 0,10 $ und 0,95 $ sowie für browsergerenderte Antworten zwischen 0,75 $ und 12,00 $ pro 1.000. Die Abrechnung erfolgt nach erfolgreichen Antworten; auf der Seite werden bei Vertragsabschluss zudem Preise ab 0,06 $ pro 1.000 erfolgreiche Antworten angegeben.

ScrapingBee

ScrapingBee ist eine kreditbasierte Scraping-API, die standardmäßig JavaScript rendert und eine übersichtliche Kredittabelle veröffentlicht. Am besten geeignet für Screenshots, Extraktionsregeln und eine dokumentierte Kreditstaffelung; nicht für statisches HTML mit hohem Datenaufkommen, falls Sie vergessen, das Rendern zu deaktivieren.

Freelance: 49 $/Monat für 250.000 Credits (50 gleichzeitige Verbindungen); Startup: 99 $/1 Mio.; Business: 249 $/3 Mio.; Business+: 599 $/8 Mio.; 1.000 kostenlose Credits. Ein klassischer Proxy ohne JS kostet 1 Credit; JS-Rendering (Standard) kostet 5; Premium-Proxy 10 ohne JS / 25 mit JS; Stealth mit JS kostet 75. Im Auto-Modus kostet die Anfrage 0 Credits, wenn alle Konfigurationen fehlschlagen. Preise zzgl. MwSt.

ScraperAPI

ScraperAPI ist eine kreditbasierte Scraping-API mit Domain-Zuschlägen und strukturierten Datenprodukten für beliebte Websites. Am besten geeignet für Teams, die Google, Amazon oder LinkedIn bereits als teure Domains im Budget einkalkulieren; nicht für globales Geotargeting im „Hobby“-Tarif (nur USA und EU).

Hobby 49 $/Monat für 100.000 Credits (20 Threads); Startup 149 $/1 Mio.; Business 299 $/3 Mio.; Scaling 475 $/5 Mio. Kostenloser Tarif mit 1.000 Credits; 7-tägige Testversion mit 5.000 Credits. Standardseiten kosten 1 Credit; Amazon 5; Google und Bing 25; LinkedIn 30. Credits werden bei Verlängerung zurückgesetzt.

Firecrawl

Firecrawl konzentriert sich auf Workflows zum Scrapen, Crawlen und Abbilden mit Markdown-orientierter Ausgabe für KI-Pipelines. Am besten geeignet für LLM- und RAG-Teams, die Markdown sowie Endpunkte zum Crawlen und Abbilden der gesamten Website benötigen; nicht für Teams, die hauptsächlich SERP- oder Amazon-Datensatz-APIs benötigen.

Hobby: 19 $/Monat bei monatlicher Abrechnung (16 $/Monat bei jährlicher Abrechnung) für 5.000 Credits; Standard: 83 $/Monat bei jährlicher Abrechnung für 100.000 Credits; Growth: 333 $; Scale: 599 $; 1.000 Credits/Monat kostenlos. Ein Credit pro Seite für Scrape/Crawl/Map; die Suche kostet 2 Credits pro 10 Ergebnisse; „Interact“ kostet 2 Credits pro Browserminute; die Formate JSON, „Question“ oder „Highlight“ kosten zusätzlich 4 Credits pro Seite. Ein Scrape, der kein Ergebnis liefert, wird nicht berechnet; 403- oder 404-Seiten kosten 1 Credit. Die Credit-Regeln gelten ab dem 4. September 2026. Vergleichen Sie Scrapes nur im Markdown-Format mit Scrapes im JSON-Format (+4 Credits) für dieselben URLs.

Decodo

Die Web-Scraping-API von Decodo verkauft Seiten- und Crawling-Kontingente mit Markdown-Unterstützung und optionalen JS- oder Premium-Proxys. Am besten geeignet für Markdown sowie Scraping/Suche/Kartierung/Crawling zu einem niedrigen Einstiegspreis; nicht geeignet für Käufer, die eine detaillierte öffentliche Kreditmatrix für jede Funktionskombination benötigen.

Kostenloser Tarif für bis zu 10.000 Seiten oder 5.000 Crawls; 19 $/Monat für bis zu 38.000 Seiten oder 19.000 Crawls; 49 $ für 122.000 Seiten; 99 $ für 330.000; 249 $ für 1,2 Mio. Auf der Preisseite heißt es, dass man nur für das bezahlt, was man nutzt, und dass JS-Rendering und Premium-Proxys bei Bedarf aktiviert werden können.

ZenRows

ZenRows ist eine kreditbasierte Plattform, bei der Abrufe, Extraktionen, Batch-Verarbeitungen und Browsersitzungen auf einem Guthabenkonto zusammengefasst sind, einschließlich Markdown-Ausgabe. Am besten geeignet für einen günstigen Einstiegstarif und Markdown, ohne zwischen verschiedenen Produkten hin- und herwechseln zu müssen; nicht für SERP-spezifische, von Google veröffentlichte Tarife.

Build: 16 $/Monat für 45.000 Credits (monatliche Preise auf der Preisseite); Launch: 58 $/250.000; Growth: 166 $/1,2 Mio.; Scale: 458 $/5 Mio.; 5.000 kostenlose Credits/Monat. Standard: 1 Credit pro Seite; JS: 5; Premium-Proxys: 10; JS + Premium: 25. Fehlgeschlagene Anfragen werden niemals berechnet; 404- und 410-Fehler gelten als erfolgreich. Aufladungen mit Übertrag sind in den kostenpflichtigen Tarifen aufgeführt.

Scrapingdog

Scrapingdog bietet Credit-Tarife für allgemeine, SERP- und E-Commerce-APIs an, wobei fehlgeschlagene Anfragen erstattet werden. Am besten geeignet für einfache Tarife und eine explizite Abrechnung nach dem Prinzip „fehlgeschlagene Anfragen werden niemals berechnet“; nicht geeignet für eine gehostete Browser-Action-API als primäre Schnittstelle.

Lite 40 $/Monat für 200.000 Credits; Standard 90 $/1 Mio.; Pro 200 $/3 Mio.; Premium 350 $/6 Mio.; kostenlos 100 Credits. Eine Standardanfrage kostet 1 Credit; JavaScript-Rendering 5; Premium-Proxy 10; JS + Premium 25.

Scrape.do

Scrape.do verkauft Tarife in Form von Credits für erfolgreiche API-Aufrufe und gibt an, dass Funktionen tarifenübergreifend freigeschaltet sind. Am besten geeignet für private und Browser-Funktionen, wobei nur für erfolgreiche, gültige Inhalte bezahlt wird; nicht geeignet für Käufer, die vor der Kostenkalkulation eine öffentliche Credit-Tabelle pro Funktion benötigen.

Hobby: 29 $/Monat für 250.000 erfolgreiche Credits; Pro: 99 $/1,25 Mio.; Business: 249 $/3,5 Mio.; Advanced: 699 $/10 Mio.; 1.000 kostenlose erfolgreiche Credits. Auf der Preisseite heißt es, dass Ihnen nur erfolgreiche Antworten mit gültigen Inhalten in Rechnung gestellt werden. Definieren Sie die Prüfkriterien für „gültige Inhalte“ auf Ihrer Seite und vergleichen Sie die in Rechnung gestellten Erfolge mit den rohen HTTP-200-Antworten.

Apify

Apify ist eine Plattform zum Ausführen von vorgefertigten oder benutzerdefinierten Scrapern („Actors“) mit Abrechnung nach Recheneinheiten anstelle eines einzelnen Scraping-Endpunkts. Am besten geeignet für einen Marktplatz für Scraper oder das Hosten Ihres eigenen Scraping-Codes; nicht für eine API mit einer einzigen Eingabe-URL und HTML-Ausgabe ohne Auswahl von Actors.

Starter 19 $/Monat plus nutzungsabhängige Abrechnung; Scale 199 $; Business 999 $; kostenlose Plattformnutzung im Umfang von 5 $ pro Monat. Recheneinheiten kosten je nach Tarif 0,20 $ / 0,16 $ / 0,13 $; bei „Store Actors“ legen die Anbieter ihre Preise selbst fest.

Wie viel kostet eine Web-Scraping-API wirklich?

Die tatsächlichen Kosten ergeben sich aus dem Preis pro Credit × die Anzahl der Credits, die eine Anfrage an Ihrem Ziel verbraucht ÷ dem Anteil der nutzbaren Daten, zuzüglich der in Rechnung gestellten Fehlversuche. Rendering, Premium-Proxys und „harte“ Domains multiplizieren den Grundpreis; bei kreditbasierten Tarifen kann eine Anfrage 1 bis 75 Credits verbrauchen.

Warum der Preis pro 1.000 Anfragen irreführend ist

Anbieter berechnen dieselbe „Anfrage“ unterschiedlich:

Anbieter

Wie Extras abgerechnet werden

ScrapingBee

1 / 5 (JS-Standard) / 10 / 25 / 75 Credits

ZenRows

1 / 5 / 10 / 25 Credits

Scrapingdog

JS 5, Premium 10, beide 25

ScraperAPI

Standard 1; Amazon 5; Google/Bing 25; LinkedIn 30

Zyte

Fünf Website-Stufen; getrennte Raten für HTTP und browserbasierte Darstellung

Oxylabs

Preis pro Zielgruppe pro 1.000 Ergebnisse

Firecrawl

1 Credit pro Seite; +4 für JSON-/Frage-/Highlight-Formate

Ein Tarif, der pro 1.000 Credits günstiger erscheint, kann pro nutzbarer Seite teurer werden, sobald Rendering- und Domain-Regeln zur Anwendung kommen.

So berechnen Sie die Kosten pro erfolgreicher Seite

cost per usable page = (plan price ÷ included credits) × credits per request × (billed attempts ÷ usable results)

Auf den öffentlichen Preisseiten werden drei Abrechnungsmodelle aufgeführt:

  1. Nur erfolgreiche Zugriffe werden abgerechnet: Bright Data Web Unlocker, Scrapingdog, ZenRows, Scrape.do und Zyte beschreiben eine erfolgsbasierte Abrechnung.
  2. Einige Fehlerseiten werden in Rechnung gestellt: Firecrawl berechnet 1 Credit für 403- oder 404-Seiten; ein Scrape ohne Ergebnis wird nicht berechnet.
  3. Jede Anfrage wird abgerechnet: In der Browser-API-Dokumentation von WebScrapingAPI heißt es, dass das Produkt 100 % der Anfragen in Rechnung stellt, unabhängig davon, ob sie erfolgreich waren oder fehlgeschlagen sind.

Achten Sie auf die „False-Success“-Falle: Eine Blockierungsseite mit HTTP-Status 200, die dennoch Credits verbraucht. Wiederholungsversuche vervielfachen diese Kosten; nutzen Sie Timeouts, Wiederholungsversuche und Backoff mit Jitter und betrachten Sie den HTTP-Status 429 „Too Many Requests“ als Signal, das Tempo zu drosseln, anstatt dieselbe URL zu überlasten.

Praxisbeispiel mit Listenpreisen: „ScrapingBee Freelance“ für 49 $ bei 250.000 Credits entspricht 0,196 $ pro 1.000 Credits. Gerenderte Anfragen zu 5 Credits kosten etwa 0,98 $ pro 1.000 Versuche; Premium-Proxy plus Rendering zu 25 Credits etwa 4,90 $ pro 1.000 Versuche, vor Anwendung der Nutzungsrate und der Regeln für fehlgeschlagene Anfragen.

def cost_per_1k_usable(
    plan_price: float,
    included_credits: int,
    credits_per_request: float,
    usable_rate: float,
    billed_rate: float,
) -> float:
    """Dollars per 1,000 usable pages for a credit-based plan."""
    price_per_credit = plan_price / included_credits
    cost_per_attempt = price_per_credit * credits_per_request * billed_rate
    return (cost_per_attempt / usable_rate) * 1000


# Example plan: replace with your own plan's price and included credits
plan_price, included = 100.0, 1_000_000
scenarios = [
    ("Static (1 credit)", 1, 0.95, 1.0),
    ("Rendered (5 credits)", 5, 0.90, 1.0),
    ("Rendered + premium (25 credits)", 25, 0.80, 1.0),
]
for name, credits, usable, billed in scenarios:
    cost = cost_per_1k_usable(plan_price, included, credits, usable, billed)
    print(f"{name}: ${cost:.2f} per 1,000 usable pages")

Kosten, die auf der Preisseite nicht aufgeführt sind

Die Obergrenzen für die gleichzeitige Nutzung steigen mit der Tarifstufe. Credits können monatlich zurückgesetzt werden (ScraperAPI) oder Aufladungen mit Übertrag auf den nächsten Monat ermöglichen (ZenRows listet Aufladungen auf; Firecrawl listet die Übertragung auf). Geotargeting kann je nach Tarif eingeschränkt sein (ScraperAPI Hobby und Startup listen nur die USA und die EU auf). Der Entwicklungsaufwand für das Parsen, die Überwachung und die Datenvalidierung übersteigt bei festen Zielen oft die API-Rechnungssumme.

Wie testet man eine Web-Scraping-API vor dem Kauf?

Wählen Sie 50–200 echte URLs pro Zieltyp aus, lassen Sie diese mit identischen Einstellungen durch jede API laufen, validieren Sie den Inhalt (nicht nur den Statuscode) und erfassen Sie die Erfolgsquote bei nutzbaren Seiten, Latenz-Perzentile, verbrauchte Credits und die Kosten pro nutzbarer Seite. Wiederholen Sie den Vorgang an einem zweiten Tag, bevor Sie eine Entscheidung treffen.

  1. Erstellen Sie eine Zielliste. CSV-Spalten: url, target_type, must_contain (ein Textmarker oder eine CSS-Klasse, geschrieben als .price, die eine nutzbare Seite enthalten muss).
  2. Speichere die Schlüssel in der Umgebung. Lies WSA_API_KEY (sowie die Schlüssel anderer Anbieter) aus Umgebungsvariablen aus. Falls WebScrapingAPI auf Ihrer Auswahlliste steht, hilft Ihnen unser Leitfaden zur Erstellung Ihrer ersten Anfrage mit WebScrapingAPI bei der Einrichtung.
  3. Begrenzen Sie die Parallelität auf das Limit des jeweiligen Tarifs.
  4. Überprüfen Sie den Inhalt. Verlangen Sie einen HTTP-Status 200, das Vorhandensein des Markers und das Fehlen der gängigen Block-Strings (captcha, access denied, verify you are human).
  5. Erfassen Sie Credits. Bevorzugen Sie Header des Anbieters oder Envelope-Felder, sofern verfügbar (WebScrapingAPI gibt WSA-Call-Credit-Usage und cost im JSON-Envelope zurück).
  6. Fassen Sie die nutzbare Rate, die p50/p95-Latenz, die verbrauchten Credits und die Kosten pro 1.000 nutzbare Seiten zusammen.
  7. Wiederholen Sie den Vorgang an einem anderen Tag, bevor Sie eine Entscheidung treffen.
import csv
import os
import time
from concurrent.futures import ThreadPoolExecutor, as_completed
from html.parser import HTMLParser
from urllib.parse import urlencode

import requests

BLOCK_MARKERS = ("captcha", "access denied", "verify you are human")
MAX_WORKERS = 4


def adapter_wsa(url: str, render_js: int = 0) -> requests.Response:
    api_key = os.environ["WSA_API_KEY"]
    params = {"api_key": api_key, "url": url, "render_js": render_js}
    return requests.get(
        "https://api.webscrapingapi.com/v2?" + urlencode(params),
        timeout=30,
    )


def adapter_plain(url: str, **_kwargs) -> requests.Response:
    """Local stand-in so you can verify the harness without a provider key."""
    return requests.get(url, timeout=30, headers={"User-Agent": "wsa-harness/1.0"})


class ClassCollector(HTMLParser):
    """Collects every class name used on any element of the page."""

    def __init__(self) -> None:
        super().__init__()
        self.classes: set[str] = set()

    def handle_starttag(self, tag, attrs) -> None:
        for name, value in attrs:
            if name == "class" and value:
                self.classes.update(value.split())


def has_css_class(body: str, css_class: str) -> bool:
    collector = ClassCollector()
    collector.feed(body)
    return css_class in collector.classes


def is_usable(status: int, body: str, must_contain: str) -> bool:
    if status != 200:
        return False
    lower = body.lower()
    if any(marker in lower for marker in BLOCK_MARKERS):
        return False
    if must_contain.startswith("."):
        return has_css_class(body, must_contain[1:])
    return must_contain.lower() in lower


def run_row(row: dict, adapter) -> dict:
    started = time.perf_counter()
    response = adapter(row["url"])
    body = response.text or ""
    return {
        "url": row["url"],
        "status": response.status_code,
        "latency_s": time.perf_counter() - started,
        "credits": response.headers.get("WSA-Call-Credit-Usage"),
        "usable": is_usable(response.status_code, body, row["must_contain"]),
    }


def main(path: str = "targets.csv") -> None:
    with open(path, newline="", encoding="utf-8") as handle:
        rows = list(csv.DictReader(handle))
    adapter = adapter_wsa if os.environ.get("WSA_API_KEY") else adapter_plain
    results = []
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = [pool.submit(run_row, row, adapter) for row in rows]
        for future in as_completed(futures):
            results.append(future.result())
    usable = sum(1 for item in results if item["usable"])
    print(f"usable={usable}/{len(results)}")
    for item in results:
        print(item)


if __name__ == "__main__":
    main()

Fügen Sie weitere Anbieter auf dieselbe Weise hinzu: jeweils eine Adapterfunktion, die anhand der Dokumentation des jeweiligen Anbieters erstellt wird. Zu den kostenlosen Kontingenten für einen ersten Durchlauf gehören 5.000 Scraper-API-Anfragen bei WebScrapingAPI, 1.000 Credits/Monat bei Firecrawl, 5.000 Credits/Monat bei ZenRows, 1.000 Credits bei ScrapingBee, 1.000 erfolgreiche Credits bei Scrape.do sowie 5.000 Unlocker-Anfragen pro Monat bei Bright Data.

Sollten Sie Ihren eigenen Scraper entwickeln oder eine Web-Scraping-API nutzen?

Entwickeln Sie selbst, wenn die Ziele wenige, offen und stabil sind und Sie Mitarbeiter haben, die Proxys, Browser und Parser warten können. Kaufen Sie eine Lösung, wenn die Ziele geschützt, vielfältig oder geschäftskritisch sind oder wenn die Entwicklungszeit mehr kostet als die API. Viele Teams kombinieren beides: einen eigenen Crawler und eine API für die schwierigen Seiten.

Faktor

Selbst entwickeln

API kaufen

Hybrid

Volumen

Gering bis mittel bei einfachen Websites

Mittel bis hoch

Hoch, gemischter Schwierigkeitsgrad

Angestrebter Schwierigkeitsgrad

Niedrig

Hoch

API für feste URLs

Teamfähigkeiten

Starke Scraping-Kompetenz

HTTP-Integration

Crawler + API-Adapter

Zeit bis zur ersten Datenerfassung

Wochen

Stunden bis Tage

Tage

Wartungsaufwand

Sie besitzen eigene Proxys und Parser

Der Anbieter ist für das Routing zuständig

Sie sind für die Orchestrierung zuständig

Compliance-Anforderungen

Sie implementieren Kontrollmaßnahmen

Geteilte Verantwortung

Geteilt, dokumentiert

Wir schlüsseln die Vorteile und Kompromisse einer Web-Scraping-API nach Zuständigkeiten auf.

Benötigen Sie Proxys oder eine Web-Scraping-API?

Verwenden Sie Proxys, wenn Ihr eigener Client oder Browser Anfragen, Sitzungen, Wiederholungsversuche und das Parsen steuern soll. Verwenden Sie eine API, wenn Sie möchten, dass der Anbieter das Routing, das Rendering und die Blockbehandlung übernimmt und eine Antwort zurückgibt. Proxys werden nach Datenvolumen (GB) abgerechnet; APIs nach Anfragen.

Der Unterschied in der Abrechnungseinheit wird auf den veröffentlichten Seiten von WebScrapingAPI konkret dargestellt: Bei Residential-Proxys zahlen Sie nach Verbrauch ab 8,50 $/GB, während Scraper-API-Tarife nach API-Aufrufen abgerechnet werden und bei 19 $/Monat für 7.000 Anfragen beginnen. Wenn Sie sich für Proxys entscheiden, erläutert unser Leitfaden zur Auswahl zwischen Rechenzentrums-, Residential- und ISP-Proxys die jeweiligen Vor- und Nachteile.

Wann sollten Sie Webdaten kaufen, anstatt sie selbst zu scrapen?

Kaufen Sie Daten, wenn Sie regelmäßig dieselben Felder aus denselben Quellen benötigen, wenn die Pflege von Parsern nicht zu Ihren Kernaufgaben gehört oder wenn Sie historische Daten benötigen. Die Optionen reichen von vorgefertigten Datensätzen über geplante Feeds bis hin zu einem vollständig verwalteten Scraping-Service mit vereinbarten Schemata und Lieferbedingungen.

WebScrapingAPI bietet „Data Marketplace“, „Data Feeds“, „Web Archive“ und „Managed Data“ an (Programme beginnen bei 299 US-Dollar pro Monat). Auch Bright Data und Oxylabs verkaufen neben ihren APIs Datensätze. Der Kauf von Daten ist oft die richtige Lösung, wenn Ihnen die Bereitstellung wichtiger ist als der Betrieb von Scrapern.

Die Nutzung einer API ändert nichts an der rechtlichen Situation. Entscheidend ist, welche Daten Sie erfassen und wie Sie diese nutzen. Beschränken Sie sich auf öffentlich zugängliche Daten, beachten Sie die Nutzungsbedingungen der Websites und die robots.txt-Datei, vermeiden Sie personenbezogene Daten, sofern Sie keine rechtmäßige Grundlage dafür haben, und holen Sie Rechtsberatung für Ihre Rechtsordnung ein. Die API ist ein Werkzeug; die Verantwortung liegt bei Ihnen.

Einen praktischen Überblick über „robots.txt“ finden Sie in der Einführung von Google zu „robots.txt“. Dieser Abschnitt stellt keine Rechtsberatung dar.

Häufig gestellte Fragen

Was ist die beste Web-Scraping-API?

Es gibt nicht die eine beste Web-Scraping-API. Die richtige Wahl hängt von der jeweiligen Aufgabe ab: statische Seiten, JavaScript-intensive Apps, geschützte Websites, Suchergebnisse, E-Commerce-Datensätze oder Markdown für LLMs. Wählen Sie zwei oder drei Kandidaten aus, vergleichen Sie die Kosten pro erfolgreicher Seite und testen Sie diese an Ihren eigenen URLs.

Was ist eine Web-Scraping-API?

Ein gehosteter Dienst, der eine Seite oder ein Suchergebnis über eine einzige HTTP-Anfrage abruft. Der Anbieter betreibt Proxys, führt Wiederholungsversuche durch, steuert Browser und kümmert sich um die Behandlung von Blockierungen, um anschließend HTML, JSON oder ausgewählte Felder zurückzugeben. Sie zahlen pro Anfrage oder mit Credits, anstatt selbst eine Infrastruktur zu betreiben.

Wie viel kostet eine Web-Scraping-API?

Die meisten Einstiegstarife in diesem Leitfaden kosten etwa 16 bis 49 US-Dollar pro Monat; einige bieten eine nutzungsabhängige Abrechnung an, und die meisten beinhalten ein kostenloses Kontingent. Die Credits pro Anfrage steigen bei Rendering, Premium-Proxys und schwierigen Domains, und die Abrechnung fehlgeschlagener Anfragen bestimmt die tatsächlichen Kosten. Vergleichen Sie die Kosten pro nutzbarer Seite, nicht den Tarifpreis.

Warum verlangen Web-Scraping-APIs für manche Websites höhere Gebühren?

Schwierige Ziele erfordern Residential- oder Premium-Proxys, einen echten Browser, mehr Wiederholungsversuche und die CAPTCHA-Bearbeitung. Anbieter geben diese Kosten in Form von Credit-Multiplikatoren oder site-spezifischen Tarifen weiter; eine Anfrage kann das Mehrfache bis zu einem Vielfachen einer Basis-Anfrage kosten.

Berechnen Web-Scraping-APIs fehlgeschlagene Anfragen?

Das hängt vom Anbieter und Produkt ab. Viele berechnen nur erfolgreiche Anfragen, manche berechnen bestimmte Fehlerseiten, und manche (insbesondere Produkte mit gehostetem Browser) berechnen jede Anfrage. Eine mit HTTP 200 zurückgegebene Blockierungsseite kann ebenfalls als Erfolg abgerechnet werden, sofern der Anbieter dies nicht erkennt.

Ist eine Web-Scraping-API besser als die Verwendung von Proxys?

Generell ist keines von beiden besser. Proxys eignen sich für Teams, die die Kontrolle über ihren eigenen Client behalten möchten und nach Datenverkehr abgerechnet werden; eine API übernimmt für Sie das Routing, das Rendering und die Behandlung von Blockierungen und rechnet pro Anfrage ab. Viele Teams nutzen beides.

Sollte ich meinen eigenen Scraper entwickeln oder eine Web-Scraping-API nutzen?

Entwickeln Sie einen eigenen Scraper, wenn es nur wenige, ungeschützte und stabile Ziele gibt und Sie über Entwickler verfügen, die Proxys, Browser und Parser warten können. Nutzen Sie eine API, wenn die Ziele geschützt oder vielfältig sind, wenn Sie Daten schnell benötigen oder wenn die Wartungskosten höher sind als die Kosten für die API-Nutzung. Hybride Lösungen sind üblich.

Welche Web-Scraping-API eignet sich am besten für JavaScript-intensive Websites?

Wähle eine API, die JavaScript auf Anfrage rendert, und – falls Inhalte erst nach Klicks oder Scrollen erscheinen – eine mit einem gehosteten Browser, der Wartezeiten und Aktionen akzeptiert. Das Rendern kostet oft ein Vielfaches einer einfachen Anfrage, deaktiviere es daher für Seiten, die es nicht benötigen.

Welche Web-Scraping-API eignet sich am besten für E-Commerce-Daten?

Bei großen Marktplätzen wie Amazon ist eine spezielle Record-API, die geparste Produkt-, Preis- und Bewertungsfelder zurückgibt, in der Regel besser geeignet als das Scraping von rohem HTML. Für Nischen-Shops sollten Sie eine allgemeine Scraping-API mit Rendering und Geotargeting sowie Ihren eigenen Extraktionsregeln verwenden.

Welche Web-Scraping-APIs geben Markdown für LLMs zurück?

Firecrawl, Decodo und ZenRows dokumentieren die Markdown-Ausgabe. Andere, darunter WebScrapingAPI, geben HTML, JSON oder ausgewählte Felder zurück, die Sie selbst konvertieren können. Wählen Sie strukturiertes JSON, wenn Sie exakte Felder wie Preise benötigen.

Ist die Nutzung einer Web-Scraping-API rechtmäßig?

Die Nutzung einer API ändert nichts an der rechtlichen Situation. Sammeln Sie nur öffentlich zugängliche Daten, halten Sie sich an die Nutzungsbedingungen der Website und die „robots.txt“, vermeiden Sie die Erfassung personenbezogener Daten ohne rechtmäßige Grundlage und holen Sie rechtlichen Rat für Ihre Rechtsordnung ein.

Wie teste ich eine Web-Scraping-API vor dem Kauf?

Nutzen Sie das kostenlose Kontingent von 50 bis 200 Ihrer eigenen URLs pro Zieltyp mit identischen Einstellungen. Überprüfen Sie, ob die benötigten Inhalte vorhanden sind, erfassen Sie die Erfolgsquote, die Latenz und den Verbrauch an Credits, dividieren Sie die Kosten durch die Anzahl der nutzbaren Seiten und wiederholen Sie den Test an einem anderen Tag, bevor Sie sich entscheiden.

Beginnen Sie mit einem echten Ziel

Wählen Sie Ihre schwierigste URL aus, führen Sie den Test mit zwei oder drei in die engere Wahl gekommenen APIs durch (einschließlich unserer Scraper-API-Testversion mit 5.000 Anfragen) und vergleichen Sie noch am selben Tag die Kosten pro nutzbarer Seite. Der Anbieter, der bei Ihren Zielen am besten abschneidet, ist der richtige für Sie.

Über den Autor

Suciu Dan, Mitbegründer @ WebScrapingAPI

Suciu Dan

Mitbegründer

Suciu Dan ist Mitbegründer von WebScrapingAPI und verfasst praxisorientierte, auf Entwickler zugeschnittene Anleitungen zu den Themen Web-Scraping mit Python, Web-Scraping mit Ruby und Proxy-Infrastruktur.

Web-Scraping mit AWS Lambda: Leitfaden für Python und Java 2026
Anleitungen

Web-Scraping mit AWS Lambda: Leitfaden für Python und Java 2026

TL;DR: Kurz gesagt: Web-Scraping mit AWS Lambda funktioniert am besten, wenn jeder Aufruf kurz, begrenzt und unabhängig wiederholbar ist. Beginnen Sie mit direktem HTTP, AWS SAM und S3 und fügen Sie erst dann SQS, Container, Browser-Rendering, Proxys oder eine verwaltete Abrufebene hinzu, wenn sich im Rahmen der Arbeitslast herausstellt, dass diese erforderlich sind.

Suciu Dan26 min read
Artikel lesen
So verwenden Sie GoSpider: Crawlen, URLs bereinigen und Daten extrahieren
Anleitungen

So verwenden Sie GoSpider: Crawlen, URLs bereinigen und Daten extrahieren

TL;DR: GoSpider ist ein Befehlszeilen-Crawler zum Auffinden von URLs, kein vollständiger Scraper für strukturierte Daten. Diese Anleitung zur Verwendung von GoSpider zeigt einen begrenzten Crawl, die saubere Verarbeitung der Ausgabe, die Übergabe von Colly an CSV sowie einen Diagnosepfad für 403-Antworten oder Seiten, die eine JavaScript-Darstellung erfordern.

Suciu Dan20 min read
Artikel lesen
Wie man Redfin scrappt: Python-Leitfaden für Immobiliendaten
Anleitungen

Wie man Redfin scrappt: Python-Leitfaden für Immobiliendaten

TL;DR: Redfin stellt versteckte API-Endpunkte zur Verfügung, die strukturiertes JSON für Immobilienangebote zurückgeben, wodurch das fragile HTML-Parsing vollständig übersprungen werden kann. Diese Anleitung führt Sie durch den Aufbau eines Python-Scrapers, der Miet- und Verkaufsdaten extrahiert, nach Standort sucht, neue Angebote über XML-Sitemaps überwacht und saubere Ergebnisse in CSV oder JSON exportiert.

Suciu Dan11 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.