Zum Inhalt springen

Autorprofil

Suciu Dan

Mitbegründer25 Artikel

Suciu Dan ist Mitbegründer von WebScrapingAPI und verfasst praxisorientierte, auf Entwickler zugeschnittene Anleitungen zu den Themen Web-Scraping mit Python, Web-Scraping mit Ruby und Proxy-Infrastruktur.

Suciu Dan, Mitbegründer @ WebScrapingAPI

Veröffentlichte Artikel

25 Artikel

Python web scrapingRuby web scrapingproxy infrastructureanti-bot resilienceGuidesScience of Web ScrapingUse Cases

Veröffentlichte Artikel

Web-Scraping mit AWS Lambda: Leitfaden für Python und Java 2026
Anleitungen

Web-Scraping mit AWS Lambda: Leitfaden für Python und Java 2026

TL;DR: Kurz gesagt: Web-Scraping mit AWS Lambda funktioniert am besten, wenn jeder Aufruf kurz, begrenzt und unabhängig wiederholbar ist. Beginnen Sie mit direktem HTTP, AWS SAM und S3 und fügen Sie erst dann SQS, Container, Browser-Rendering, Proxys oder eine verwaltete Abrufebene hinzu, wenn sich im Rahmen der Arbeitslast herausstellt, dass diese erforderlich sind.

Suciu Dan26 min read
Artikel lesen
So verwenden Sie GoSpider: Crawlen, URLs bereinigen und Daten extrahieren
Anleitungen

So verwenden Sie GoSpider: Crawlen, URLs bereinigen und Daten extrahieren

TL;DR: GoSpider ist ein Befehlszeilen-Crawler zum Auffinden von URLs, kein vollständiger Scraper für strukturierte Daten. Diese Anleitung zur Verwendung von GoSpider zeigt einen begrenzten Crawl, die saubere Verarbeitung der Ausgabe, die Übergabe von Colly an CSV sowie einen Diagnosepfad für 403-Antworten oder Seiten, die eine JavaScript-Darstellung erfordern.

Suciu Dan20 min read
Artikel lesen
Wie man Redfin scrappt: Python-Leitfaden für Immobiliendaten
Anleitungen

Wie man Redfin scrappt: Python-Leitfaden für Immobiliendaten

TL;DR: Redfin stellt versteckte API-Endpunkte zur Verfügung, die strukturiertes JSON für Immobilienangebote zurückgeben, wodurch das fragile HTML-Parsing vollständig übersprungen werden kann. Diese Anleitung führt Sie durch den Aufbau eines Python-Scrapers, der Miet- und Verkaufsdaten extrahiert, nach Standort sucht, neue Angebote über XML-Sitemaps überwacht und saubere Ergebnisse in CSV oder JSON exportiert.

Suciu Dan11 min read
Artikel lesen
So analysieren Sie JSON in Python: Von API-Antworten bis hin zu in Webseiten verstecktem JSON
Anleitungen

So analysieren Sie JSON in Python: Von API-Antworten bis hin zu in Webseiten verstecktem JSON

TL;DR: JSON in Python mit `json.loads` und `json.load` analysieren, Dekodierungsfehler beheben, verschachtelte Daten validieren, große Dateien streamen und in Webseiten versteckte JSON-LD- oder `__NEXT_DATA__`-Daten extrahieren – sowie WebScrapingAPI-Envelopes.

Suciu Dan12 min read
Artikel lesen
Nodriver-Python-Tutorial: Unauffälliges Web-Scraping – vom ersten Skript bis zur Produktion
Die Wissenschaft des Web-Scrapings

Nodriver-Python-Tutorial: Unauffälliges Web-Scraping – vom ersten Skript bis zur Produktion

TL;DR: Kurzfassung: Nodriver ist eine asynchrone Python-Bibliothek, die Chromium über das Chrome DevTools Protocol steuert, ohne Selenium oder chromedriver-Binary. Nutzen Sie sie, wenn ein selbst gehosteter Stealth-Browser, der einer echten Chrome-Sitzung näherkommt, besser passt als ein WebDriver-Stack – aber sie beseitigt IP-, TLS- oder Verhaltensrisiken nicht von allein. Dieses Tutorial führt vom ersten Skript bis zur containerisierten Produktion und einer gehosteten Browser API.

Suciu Dan12 min read
Artikel lesen
Umgang mit Google-/goto-Weiterleitungs-URLs und CAES-Token in einem SERP-Scraper
Die Wissenschaft des Web-Scrapings

Umgang mit Google-/goto-Weiterleitungs-URLs und CAES-Token in einem SERP-Scraper

TL;DR: Kurzfassung: Google-/goto-URLs mit CAES-Token und ältere /url-Wrapper sind Weiterleitungsschichten, keine Ziele; ein SERP-Scraper, der jede href als endgültig behandelt, verfälscht Rank-Tracking und Link-Datenbanken. Bevorzugen Sie eine strukturierte SERP-API, wenn sie Ziel-Links liefert. Wenn Sie HTML parsen müssen, klassifizieren Sie jede href, deduplizieren Sie Weiterleitungen und lösen Sie sie mit einem einfachen GET auf. Entschlüsseln Sie CAES nicht.

Suciu Dan11 min read
Artikel lesen
Die 10 besten KI-Web-Scraping-Tools für 2026
Anleitungen

Die 10 besten KI-Web-Scraping-Tools für 2026

TL;DR: Kein einzelner KI-Scraper eignet sich für jede Aufgabe. Vergleichen Sie 11 Tools hinsichtlich Extraktionsmethode, Nutzertyp, Funktionen und Kosten und wählen Sie anhand eines praktischen Testplans das für Sie passende Tool aus.

Suciu Dan20 min read
Artikel lesen
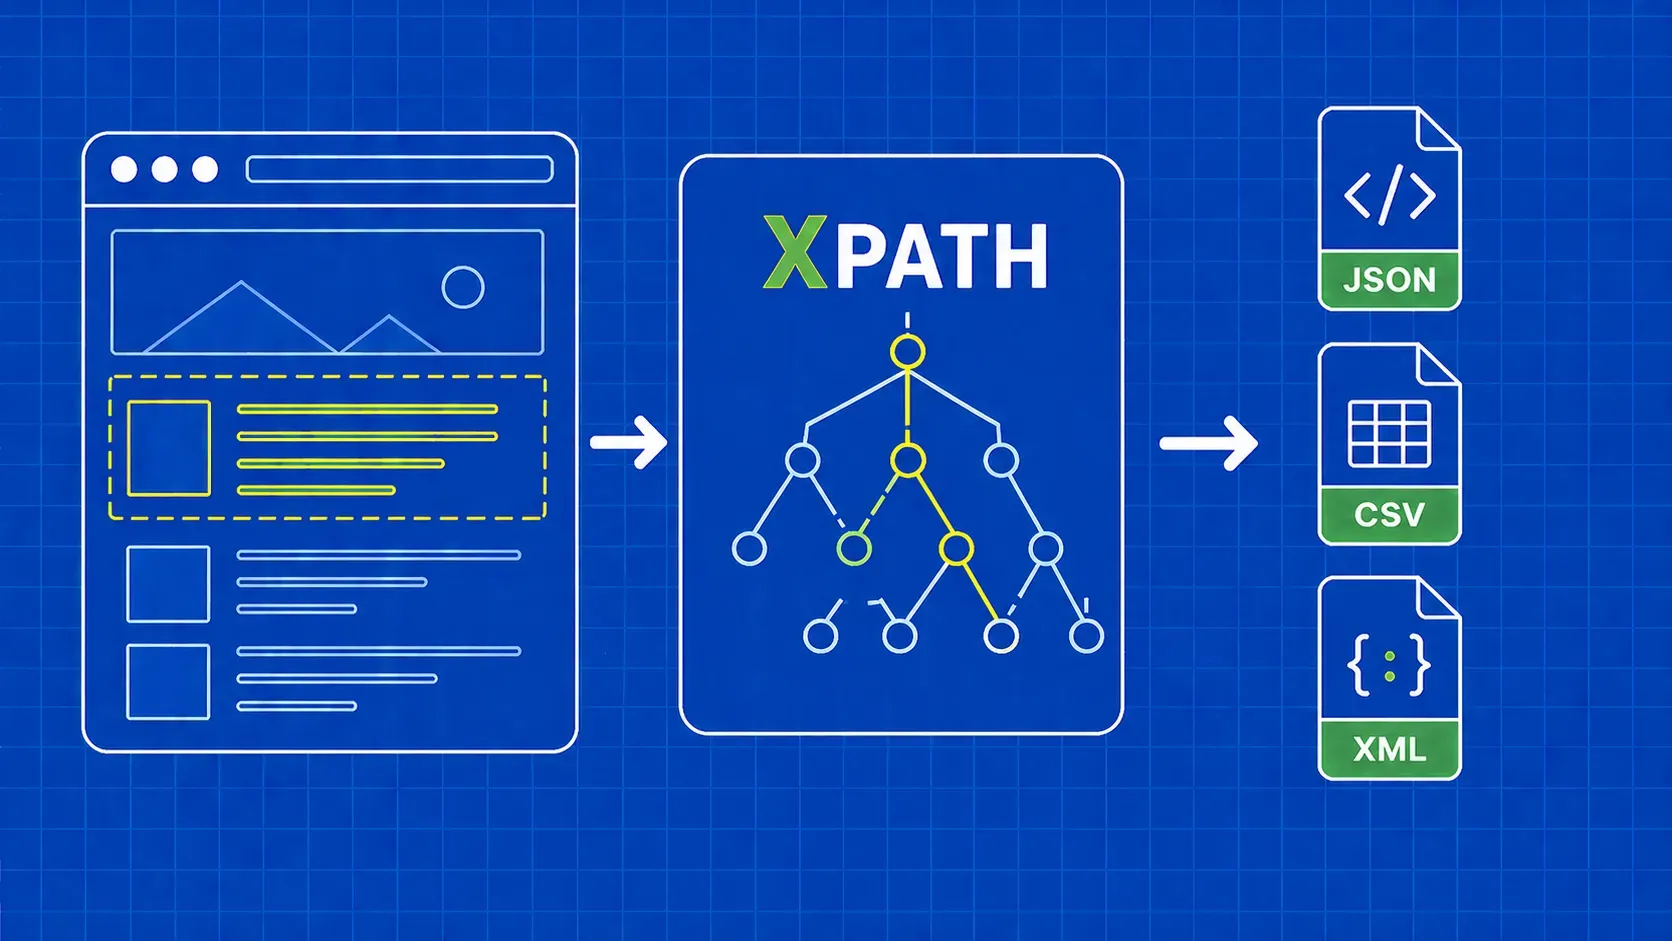
XPath Web Scraping: Ein praktischer Leitfaden mit Python-Beispielen
Anleitungen

XPath Web Scraping: Ein praktischer Leitfaden mit Python-Beispielen

TL;DR: XPath ist eine Abfragesprache zum Navigieren in HTML/XML-Bäumen nach Pfad, Attribut oder Textinhalt. Dieser Leitfaden behandelt XPath-Syntax, Achsen und Funktionen und zeigt dann funktionierende Python-Scraper mit lxml und Selenium. Sie erhalten auch einen konsolidierten Spickzettel und einen Abschnitt zur Fehlerbehebung für die häufigsten XPath-Fehler.

Suciu Dan9 min read
Artikel lesen
HTTP-Antwort-Header in cURL: Jedes Flag, jede Technik und jedes Skripting-Rezept
Die Wissenschaft des Web-Scrapings

HTTP-Antwort-Header in cURL: Jedes Flag, jede Technik und jedes Skripting-Rezept

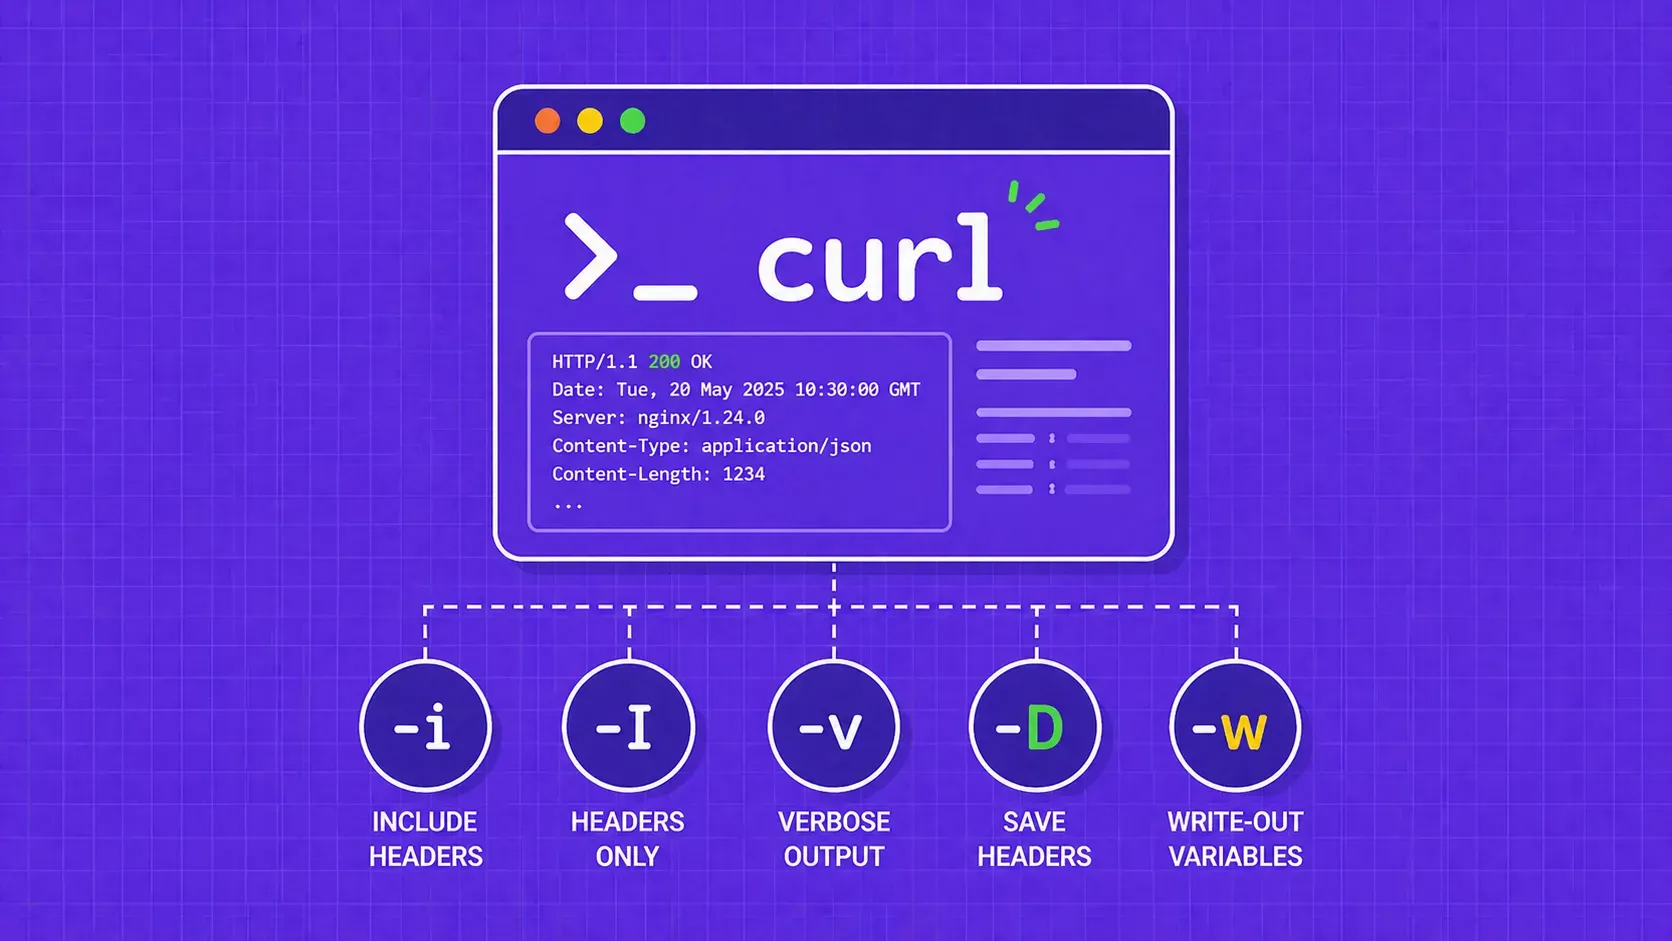
TL;DR: cURL verbirgt standardmäßig Antwort-Header. Verwenden Sie -i, um Header neben dem Body zu sehen, -I für eine HEAD-Anfrage, die nur Header zurückgibt, -v für vollständiges Debugging von Anfrage und Antwort und -D, um Header in einer Datei zu speichern. Für modernes Scripting können Sie mit cURL 7.83+ einzelne Header extrahieren oder mit der Option -w write-out alle Header als JSON ausgeben.

Suciu Dan11 min read
Artikel lesen
Was ist ein Headless Browser? Architektur, Anwendungsfälle und Top-Tools
Die Wissenschaft des Web-Scrapings

Was ist ein Headless Browser? Architektur, Anwendungsfälle und Top-Tools

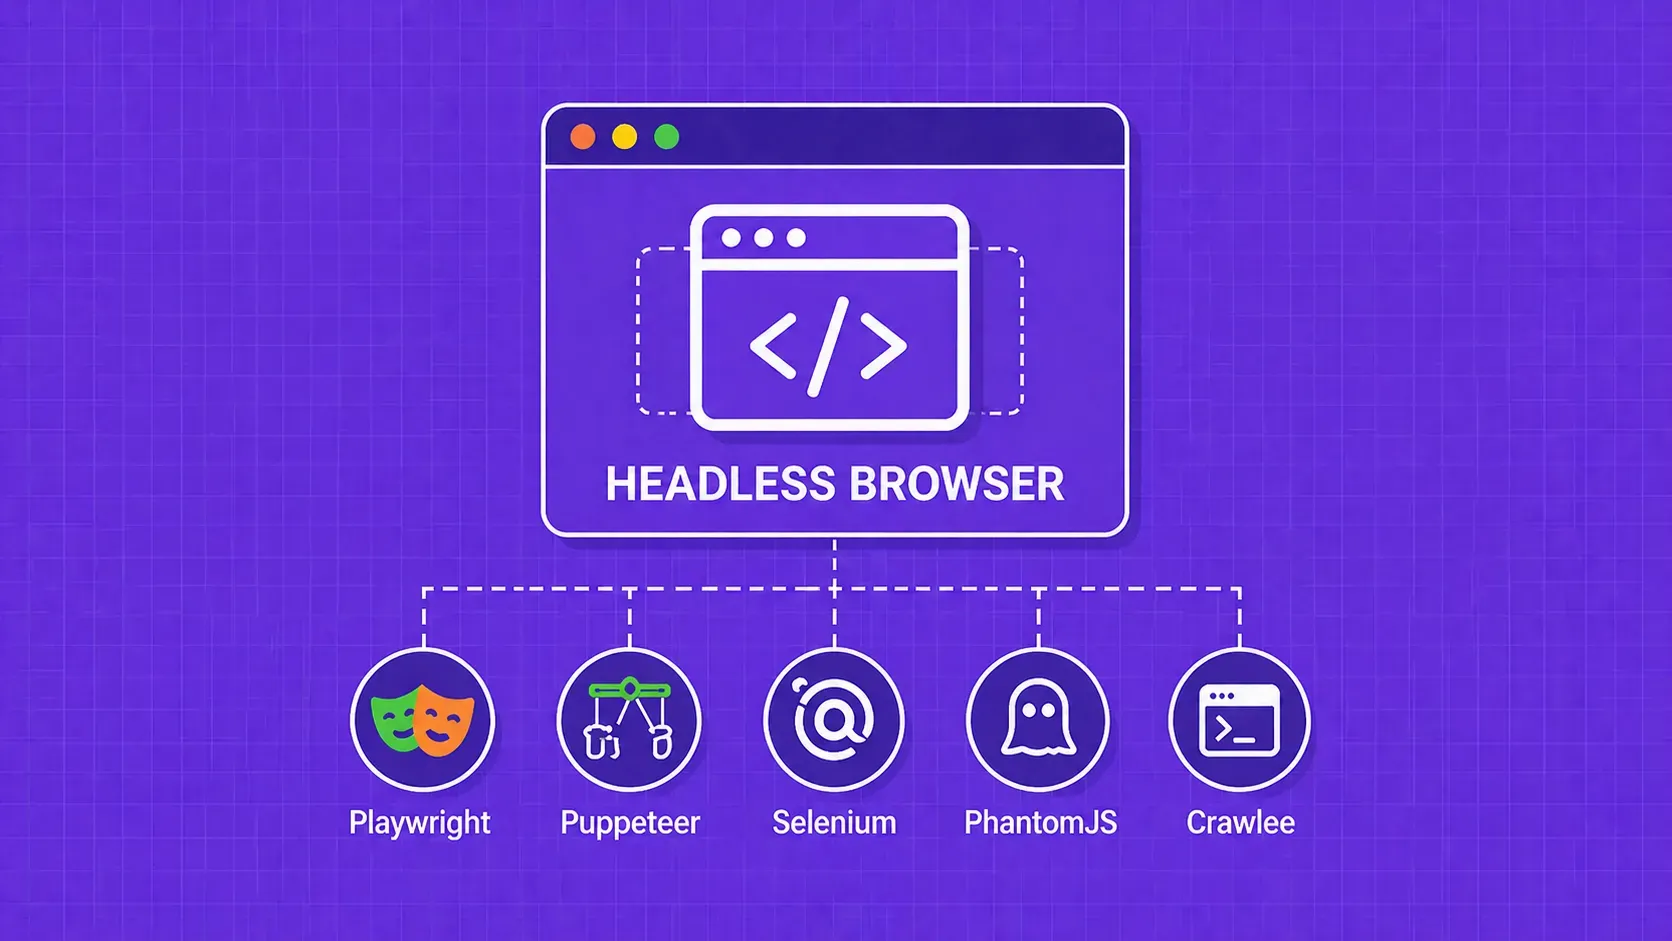
TL;DR: Ein Headless Browser ist ein Webbrowser, der ohne sichtbare grafische Oberfläche läuft und ausschließlich über Code oder Befehlszeilenanweisungen gesteuert wird. Entwickler verwenden Headless-Browser für automatisierte Tests, Web-Scraping, Leistungsüberwachung und zunehmend auch für den Einsatz von KI-Agenten. In diesem Leitfaden erfahren Sie, wie sie intern funktionieren, wann Sie einen solchen Browser einem normalen Browser vorziehen sollten und welche Frameworks Ihre Zeit wert sind.

Suciu Dan12 min read
Artikel lesen
Leitfaden zur SERP-Scraping-API: Google, Bing, DuckDuckGo, Yandex
Anleitungen

Leitfaden zur SERP-Scraping-API: Google, Bing, DuckDuckGo, Yandex

TL;DR: Senden Sie Ihre erste WebScrapingAPI-SERP-API-Anfrage mit dem Schlüssel in einer Umgebungsvariablen, lokalisieren Sie anschließend die Google-Ergebnisse nach Land, Sprache und Gerät, lesen Sie die JSON-Daten von Google und Bing auf sichere Weise aus, extrahieren Sie die HTML-Daten von DuckDuckGo und Yandex selbst, führen Sie asynchrone Google-Jobs aus, versuchen Sie es anhand der dokumentierten Fehlercodes erneut und wählen Sie einen Tarif anhand der Google-Preise vom Oktober 2026 aus.

Suciu Dan21 min read
Artikel lesen
Was sind Finanzdaten? Arten, Erhebungsmethoden und Analysewerkzeuge
Anwendungsfälle

Was sind Finanzdaten? Arten, Erhebungsmethoden und Analysewerkzeuge

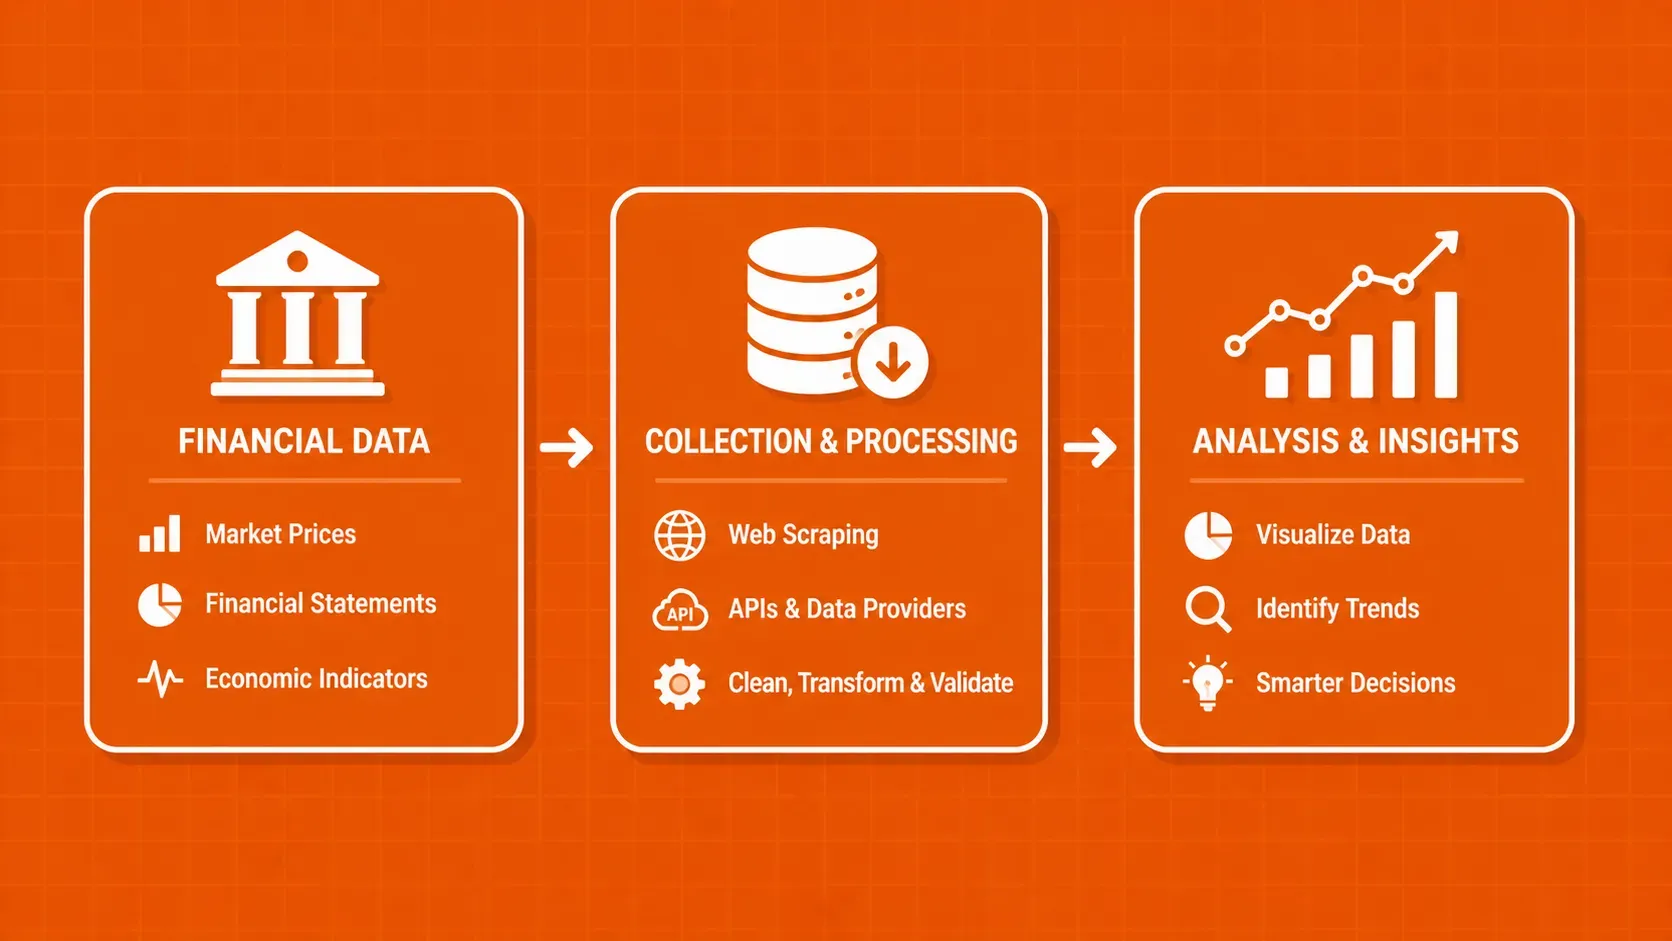
TL;DR: Finanzdaten sind die Sammlung von quantitativen Aufzeichnungen (Einnahmen, Ausgaben, Vermögenswerte, Verbindlichkeiten, Cashflow), die Organisationen und Einzelpersonen nutzen, um fundierte wirtschaftliche Entscheidungen zu treffen. Dieser Leitfaden schlüsselt die vier wichtigsten Finanzdaten auf, vergleicht traditionelle und alternative Datenquellen, geht auf moderne Erhebungsmethoden ein und behandelt die Instrumente, die Fachleute für die Analyse verwenden.

Suciu Dan12 min read
Artikel lesen
Data Parsing erklärt: Werkzeuge, Techniken & Code (2026)
Die Wissenschaft des Web-Scrapings

Data Parsing erklärt: Werkzeuge, Techniken & Code (2026)

TL;DR: Data Parsing konvertiert rohe Inhalte (HTML, JSON, XML, PDFs) in strukturierte Felder, die Ihr Code tatsächlich nutzen kann. Dieser Leitfaden erläutert Schritt für Schritt, wie Data Parsing funktioniert, vergleicht die wichtigsten Techniken und Bibliotheken und gibt Ihnen einen praktischen Rahmen für die Entscheidung, ob Sie Ihre Parsing-Schicht selbst erstellen oder kaufen sollen.

Suciu Dan14 min read
Artikel lesen
Wie man den Axios Proxy in Node.js einrichtet: Auth, Rotation, SOCKS5
Anleitungen

Wie man den Axios Proxy in Node.js einrichtet: Auth, Rotation, SOCKS5

TL;DR: Axios leitet Anfragen durch einen Proxy, indem es ein Proxy-Objekt mit Host, Port und optionalen Auth-Feldern akzeptiert. Diese Anleitung behandelt die Einrichtung der Axios-Proxy-Konfiguration von Grund auf: grundlegende Verkabelung, authentifizierte Proxys, HTTPS-Tunneling, ein Rotationssystem mit Interceptoren, SOCKS5 über socks-proxy-agent und die Diagnose von häufigen Fehlern. Jedes Snippet ist kopierbarer Node.js-Code.

Suciu Dan10 min read
Artikel lesen
Wie man einen Proxy mit HttpClient in C# verwendet
Anleitungen

Wie man einen Proxy mit HttpClient in C# verwendet

TL;DR: Um einen Proxy mit HttpClient in C# zu verwenden, erstellen Sie einen WebProxy, fügen Sie es zu einem HttpClientHandler (oder SocketsHttpHandler), und übergeben Sie diesen Handler an den HttpClient-Konstruktor. Für die Produktion, tauschen Sie manuelle Schleifen für IHttpClientFactory, fügen Sie NetworkCredential für authentifizierte Proxys, und wickeln Anrufe in Wiederholungen mit Polly, so dass tote IPs nicht nehmen Sie Ihre Arbeiter nach unten.

Suciu Dan16 min read
Artikel lesen
Wie man einen Python Web Crawler erstellt: Vom Start bis zur Skalierung
Die Wissenschaft des Web-Scrapings

Wie man einen Python Web Crawler erstellt: Vom Start bis zur Skalierung

TL;DR: Ein Python-Web-Crawler automatisiert die mühsame Arbeit der Verfolgung von Links auf einer Website, um Inhalte zu entdecken und zu sammeln. Dieser Leitfaden zeigt Ihnen, wie Sie einen solchen Crawler von Grund auf mit Requests und BeautifulSoup erstellen und dann zu Scrapy für gleichzeitiges Crawling, Element-Pipelines und strukturierte Datenexporte übergehen. Sie werden auch lernen, wie Sie verantwortungsvoll crawlen, Proxies rotieren, um Blockaden zu vermeiden, und mit JavaScript-gerenderten Seiten umgehen.

Suciu Dan27 min read
Artikel lesen
Wie man LinkedIn im Jahr 2026 scrapen kann: Eine Python-Anleitung
Anleitungen

Wie man LinkedIn im Jahr 2026 scrapen kann: Eine Python-Anleitung

TL;DR: Scraping LinkedIn bedeutet, um eine aggressive Auth Wall, Behavioral Tracking und TLS Fingerprinting zu arbeiten. Dieser Leitfaden enthält einen Entscheidungsbaum für jede einzelne Seite, Python-Muster für Jobs, Profile und Unternehmen (versteckte API, JSON-LD, Selenium, wenn nötig) und eine konsolidierte Anti-Block-Checkliste für 2026.

Suciu Dan12 min read
Artikel lesen
die 12 besten kostenlosen Web Scraping Tools im Jahr 2026: Vergleich
Anleitungen

die 12 besten kostenlosen Web Scraping Tools im Jahr 2026: Vergleich

TL;DR: Die 12 besten kostenlosen Web-Scraping-Tools im Jahr 2026 sind in vier Kategorien unterteilt: verwaltete APIs mit kostenlosen Credits, Open-Source-Frameworks, Browser-Erweiterungen ohne Code und KI-Extraktoren. Wählen Sie zuerst nach Anwendungsfall (einmaliges Scrapen vs. geplante Pipeline) und dann nach Qualifikationsniveau. Die meisten kostenlosen Stufen decken die Evaluierung ab, nicht die Produktion. Sobald Ihre Erfolgsquote unter ~90 % fällt oder Sie mehr Stunden für Blöcke als für Daten aufwenden, ist es an der Zeit, auf eine kostenpflichtige API umzusteigen.

Suciu Dan24 min read
Artikel lesen
Ist Web Scraping im Jahr 2026 noch legal? Rahmen für die Einhaltung der Vorschriften
Anleitungen

Ist Web Scraping im Jahr 2026 noch legal? Rahmen für die Einhaltung der Vorschriften

TL;DR: Ist Web Scraping legal? In der Regel ja, aber mit Einschränkungen. Die Rechtmäßigkeit hängt von der Art der Daten, dem Zugriffspfad, den beteiligten Gerichtsbarkeiten und dem Umgang mit dem Output ab. In diesem Leitfaden finden Sie ein direktes Urteil, ein Fünf-Minuten-Framework vor dem Scraping, die wichtigsten Fälle und eine Checkliste, die Sie vor dem Versand abarbeiten können.

Suciu Dan13 min read
Artikel lesen
Die besten Web-Scraping-APIs im Jahr 2026: 12 im Vergleich nach Einsatzbereich und Kosten
Anleitungen

Die besten Web-Scraping-APIs im Jahr 2026: 12 im Vergleich nach Einsatzbereich und Kosten

TL;DR: Kurzfassung: Die beste Web-Scraping-API hängt von der Aufgabe ab: Eine günstige Seiten-API gewinnt bei statischem HTML, ein Render-Flag oder gehosteter Browser bei JavaScript-lastigen Apps, ein SERP- oder E-Commerce-Endpunkt bei geparsten Datensätzen und eine Markdown-orientierte API bei LLM-Pipelines.

Suciu Dan25 min read
Artikel lesen
webscraper.io im Test: Preise, Limits und wann ein Wechsel sinnvoll ist
Anleitungen

webscraper.io im Test: Preise, Limits und wann ein Wechsel sinnvoll ist

TL;DR: Kurzfassung: Web Scraper von webscraper. io ist eine kostenlose Chrome- und Firefox-Erweiterung plus die kostenpflichtige Web Scraper Cloud und eine solide Wahl für kleine und mittlere wiederkehrende Aufgaben auf gewöhnlichen öffentlichen Websites. Bleiben Sie dabei, wenn wenige Personen eine Handvoll Websites täglich oder wöchentlich aktualisieren und jemand die Selektoren pflegt.

Suciu Dan17 min read
Artikel lesen
Puppeteer-Alternativen: Top-Tools für Scraping & Testing 2026
Anleitungen

Puppeteer-Alternativen: Top-Tools für Scraping & Testing 2026

TL;DR: Puppeteer ist großartig für die schnelle Chromium-Automatisierung, aber seine Single-Browser-Bindung, ressourcenintensive Skalierung und die fehlende eingebaute Anti-Bot-Unterstützung zwingen viele Teams zu Alternativen. Dieser Leitfaden schlüsselt die stärksten Puppeteer-Alternativen nach Anwendungsfällen auf (Scraping, E2E-Tests, browserübergreifende QA, mobile Anwendungen), gibt Ihnen eine Vergleichstabelle an die Hand und endet mit einem Entscheidungsrahmen, damit Sie das richtige Tool ohne Versuch und Irrtum auswählen können.

Suciu Dan14 min read
Artikel lesen
Alternative zum Web-Scraper: Passen Sie zunächst den Arbeitsablauf an
Anleitungen

Alternative zum Web-Scraper: Passen Sie zunächst den Arbeitsablauf an

TL;DR: Vergleichen Sie Octoparse, Browse AI, Apify und Playwright anhand ihres Erstellungsmodells. Behalten Sie die Navigation, die Identitätserfassung und das Ausführungsverhalten bei, wenn Sie den Web-Scraper ersetzen.

Suciu Dan14 min read
Artikel lesen
Alternative zu WebHarvy: Produktdaten-Workflows vergleichen
Anleitungen

Alternative zu WebHarvy: Produktdaten-Workflows vergleichen

TL;DR: Vergleichen Sie Octoparse, ParseHub, Web Scraper und Apify hinsichtlich der Produkt-Extraktion. Überprüfen Sie Varianten, Angebote, fehlende Artikel und Exporte, bevor Sie WebHarvy ersetzen.

Suciu Dan14 min read
Artikel lesen
Beste Node.js Web Scraper im Jahr 2026: 6 Bibliotheken im Vergleich
Anleitungen

Beste Node.js Web Scraper im Jahr 2026: 6 Bibliotheken im Vergleich

TL;DR: Die besten Node.js Web Scraper im Jahr 2026 teilen sich in zwei Lager: HTTP-Clients wie Axios und Superagent für statische Seiten und Headless-Browser wie Puppeteer und Playwright für JavaScript-lastige Websites. Wählen Sie nach Arbeitsabläufen aus, nicht nach Beliebtheit, und verlagern Sie das Rendering auf eine verwaltete Scraping-API, sobald die Anti-Bot-Abwehr oder die Skalierung Ihre Entwicklungszeit in Anspruch nehmen.

Suciu Dan10 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.