
Zum Inhalt springen
Zurück zum Blog

So nutzen Sie die Amazon Scraper API: Schnellstartanleitung

Robert SfichiZuletzt aktualisiert am 21 min read
So nutzen Sie die Amazon Scraper API: Schnellstartanleitung
Kurzfassung: Um die Amazon Scraper API zu nutzen, senden Sie eine GET-Anfrage an https://ecom.webscrapingapi.com/v1 mit api_key, engine=amazon, einem Anfragetyp und dessen Eingabe, etwa einer ASIN in product_id oder einem Suchbegriff in q. Verwenden Sie product für eine ASIN, search für einen Suchbegriff, bestsellers oder todays-deals für eine Kategorie-ID und seller_products oder seller_feedback für eine Verkäufer-ID. Dieser Leitfaden behandelt alle neun Anfragetypen, 20 Marktplätze, Fehler und Tarife.

Sie benötigen Amazon-Daten zu Produkten, Suchergebnissen, Rankings, Bewertungen oder Verkäufern, die Ihr Code marktübergreifend speichern und vergleichen kann, ohne dass Sie für jedes Seitenlayout einen eigenen Scraper pflegen müssen. In dieser Anleitung wird die Amazon-API von WebScrapingAPI verwendet. Am Ende werden Sie eine erste Anfrage mit Ihrem Schlüssel in einer Umgebungsvariablen senden, den richtigen Anfragetyp auswählen, die richtige Amazon-Domain und den richtigen Lieferort angeben, jedes Antwortformat mit einem Parser auswerten, gemäß der dokumentierten Fehlerbehandlung Wiederholungsversuche durchführen und einen Tarif auswählen.

Schnellstart

  • Endpunkt: https://ecom.webscrapingapi.com/v1 (GET)
  • Erforderlich: api_key, engine=amazon, type, sowie die typ-spezifischen Eingaben (q, product_id, category_idoder seller_id)
  • Anfragetypen: neun, von einem einzelnen Produkt bis hin zu Verkäuferbewertungen
  • Kostenlose Testversion: 100 Amazon-Anfragen
Was ist die Amazon-Scraper-API und was gibt sie zurück?

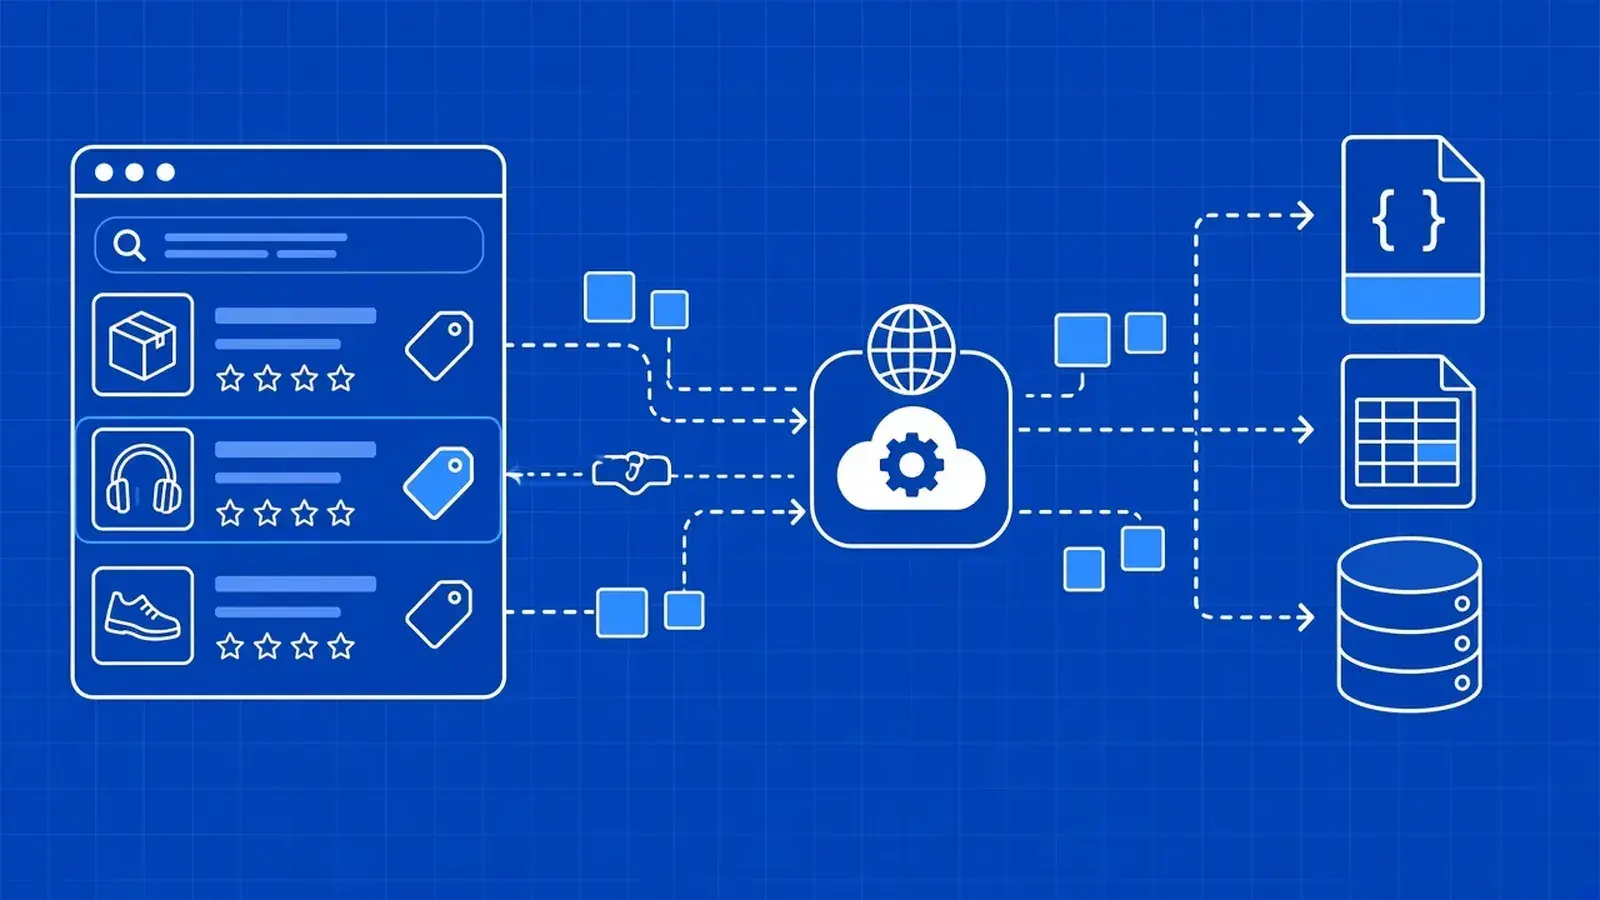
Die Amazon-API von WebScrapingAPI ist ein GET-Endpunkt, der einen Anfragetyp – wie z. B. „Produkt“, „Suche“ oder „Bestseller“ – sowie eine ASIN, ein Stichwort, eine Kategorie oder eine Verkäufer-ID entgegennimmt und die passende Amazon-Seite als strukturiertes JSON zurückgibt. WebScrapingAPI übernimmt den Zugriff, die Extraktion und die Pflege des Parsers. Ihr Code wählt die Seiten, Märkte und Felder aus und speichert die Ergebnisse.

Sie benennen die Seite über type und deren Eingabe, und jede Antwort wird mit demselben Layout auf oberster Ebene zurückgegeben: das, was Sie angefordert haben, das, was Amazon angezeigt hat, und die Datensätze auf dieser Seite. Sie müssen keine Selektoren schreiben und diese auch nicht neu schreiben, wenn Amazon sein Markup ändert.

Hier ist die Aufgabenteilung:

  • WebScrapingAPI übernimmt: den Zugriff auf die Quelle, die Datenextraktion, die Aktualisierung der Parser und die Qualitätsüberwachung.
  • Ihr Team ist verantwortlich für: die Auswahl der zu erfassenden Seiten und Märkte, die zu behaltenden Felder, Aktualisierungszeitpläne und die Bereitstellung sowie die darauf aufbauende Analyse.

Die API deckt Such- und Kategoriergebnisse, Produkt- und Variationsseiten sowie Angebotslisten der Händler ab. Teams nutzen sie für „Buy Box“- und Angebotsanalysen, Such- und Kategorieanteile sowie die Analyse von Variationen und Bewertungssignalen. Amazon ist eine Quelle im umfassenderen Data-API-Katalog.

Jede Antwort ist eine Beobachtung einer einzelnen Seite in einem Markt zu einem bestimmten Zeitpunkt. Ein Preis, ein Rang oder eine Anzahl von Bewertungen sind nur im Zusammenhang mit den Einstellungen und dem Zeitpunkt aussagekräftig, zu denen sie ermittelt wurden.

Wie erhält man einen API-Schlüssel und sendet seine erste Amazon-Anfrage?

Erstellen Sie ein WebScrapingAPI-Konto, abonnieren Sie die Amazon-API im Dashboard und speichern Sie Ihren Schlüssel in einer Umgebungsvariablen. Senden Sie anschließend eine GET-Anfrage an https://ecom.webscrapingapi.com/v1 mit den Parametern `api_key`, `engine=amazon`, `type=search` und `q` gesetzt auf Ihr Suchwort. Lassen Sie Ihren HTTP-Client die Parameter kodieren und bewahren Sie den Schlüssel auf Ihrem Server auf.

  1. Erstellen Sie ein Konto mit E-Mail-Adresse und Passwort, über GitHub oder Google.
  2. Abonnieren Sie die Amazon-API im Dashboard. Die Testversion umfasst 100 Amazon-Anfragen zum Preis von 0 $.
  3. Speichern Sie den Schlüssel in einer Umgebungsvariablen, z. B. WSA_API_KEYoder in einem Secrets-Manager.
  4. Senden Sie die Anfrage über ein Terminal, Python oder Node.js.

Bewahren Sie den Schlüssel in serverseitigen Geheimnissen auf, niemals im Frontend-Code, in einem öffentlichen Repository, in einer Log-Zeile oder auf einem Screenshot. Er ist an Ihr Konto und Ihr Kontingent gebunden, sodass jeder, der ihn besitzt, Ihre Anfragen verbraucht.

# Paste your key from the dashboard, or load it from your secrets manager. Never commit it.
export WSA_API_KEY="..."

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=search" \
  --data-urlencode "q=memory card"

Der Rest dieser Anleitung baut auf dem unten stehenden Python-Client auf. Er liest den Schlüssel aus der Umgebung aus, führt gemäß den später behandelten Fehlerregeln Wiederholungsversuche durch und gibt das geparste JSON sowie den Credit-Header des Aufrufs zurück. Installieren Sie Requests mit pip install requests.

# amazon_client.py
import os
import random
import time
from urllib.parse import urlencode

import requests

SCRAPER_URL = "https://ecom.webscrapingapi.com/v1"
RETRYABLE = {429, 500, 502, 503}


def redacted_url(params):
    """The request URL with the key hidden. Log this, never the real URL."""
    return f"{SCRAPER_URL}?{urlencode({'engine': 'amazon', 'api_key': '***', **params}, safe='*')}"


def amazon_get(params, retries=3, timeout=130):
    query = {"engine": "amazon", "api_key": os.environ["WSA_API_KEY"], **params}
    for attempt in range(retries + 1):
        resp = requests.get(SCRAPER_URL, params=query, timeout=timeout)
        if resp.status_code == 200:
            return resp.json(), resp.headers.get("Searchdata-Call-Credit-Usage")
        retry_422 = resp.status_code == 422 and attempt == 0  # retry a website error once
        if (resp.status_code not in RETRYABLE and not retry_422) or attempt == retries:
            raise RuntimeError(f"{resp.status_code} on {redacted_url(params)}: {resp.text[:200]}")
        wait = resp.headers.get("Retry-After", "")
        delay = int(wait) if wait.isdigit() else 2 ** attempt
        time.sleep(delay + random.random())  # exponential backoff with jitter
# first_request.py
from amazon_client import amazon_get

data, credits = amazon_get({"type": "search", "q": "memory card"})
results = data.get("search_results", {}).get("product_results", [])
print(len(results), "products; credits for this call:", credits)

Die gleiche Anfrage in Node.js 18 oder höher benötigt keine Abhängigkeiten:

// amazon_request.mjs — run with: node amazon_request.mjs
const params = new URLSearchParams({
  engine: "amazon",
  api_key: process.env.WSA_API_KEY,
  type: "search",
  q: "memory card",
});

const res = await fetch(`https://ecom.webscrapingapi.com/v1?${params}`, {
  signal: AbortSignal.timeout(130_000),
});
if (!res.ok) throw new Error(`${res.status}: ${await res.text()}`);

const data = await res.json();
console.log("credits for this call:", res.headers.get("searchdata-call-credit-usage"));
console.log(data.search_results?.product_results?.length, "products");

Ein Schlüsselwort mit einem Leerzeichen, &oder + muss den Regeln der Prozent-Kodierung entsprechen. Ein unkodiertes & leitet stillschweigend einen neuen Parameter ein, den die API mit „Parameter ‚<name>‘ nicht zulässig“ ablehnt. Die Optionen `--data-urlencode` und `URLSearchParams` von `curl` sowie das Argument `params` von `Requests` übernehmen die Kodierung für Sie. Jedes Beispiel legt außerdem ein Timeout von 130 Sekunden fest, damit eine langsame Seite einen Worker nicht zum Hängen bringt.

Beispielantwort (aus der API-Dokumentation kopiert, gekürzt):

{
  "search_parameters": {
    "amazon_url": "https://www.amazon.com/s?k=memory+card",
    "engine": "amazon",
    "amazon_domain": "amazon.com",
    "type": "search",
    "q": "memory card"
  },
  "search_information": {
    "organic_results_state": "Results for exact spelling",
    "total_results": "5,000",
    "query_displayed": "memory card"
  },
  "search_results": {
    "product_results": [
      {
        "position": 1,
        "product_id": "B08TJRVWV1",
        "title": "Amazon Basics microSDXC Memory Card with Full Size Adapter",
        "link": "https://www.amazon.com/dp/B08TJRVWV1",
        "price": "$12.42",
        "rating": { "rating": "4.7 out of 5 stars", "total_ratings": 33500 }
      }
    ]
  }
}

Dokumentation: Zugriff auf die API

Welche Amazon-Anfragetypen können Sie verwenden?

Setzen Sie den Typ auf einen von neun Werten: „product“ für eine ASIN, „search“ für ein Stichwort, „category“, „bestsellers“, „new-releases“ oder „todays-deals“ für eine Kategorie-ID sowie „seller_products“, „seller_profile“ oder „seller_feedback“ für eine Verkäufer-ID. „seller_feedback“ ist die Anfrage für Bewertungen. Jeder Typ benötigt eigene Eingaben und gibt Zeilen an einer eigenen Stelle zurück.

Ziel

type

Erforderliche Eingabe

Optionale Eingaben für den Typ

Zeilen befinden sich in

Abschnitt

Ein Produkt pro ASIN (inkl. Bewertung und Anzahl der Bewertungen)

product

product_id

—

product_results (Objekt)

Produkt nach ASIN

Suchergebnisse

search

q

page, sort_by, filter_by

search_results.product_results

Suchergebnisse

Bestseller-Ranking

bestsellers

category_id

parent_alias

category_results.product_results

Bestseller

Neuerscheinungen

new-releases

category_id

parent_alias

category_results.product_results

Neuerscheinungen

Eine Kategorie durchsuchen

category

category_id

page, sort_by

category_results.product_results

Kategorie

Angebote des Tages

todays-deals

category_id

—

category_results.product_results (ergänzt price_raw)

Angebote des Tages

Katalog eines Verkäufers

seller_products

seller_id

page

search_results.product_results

Produkte des Verkäufers

Verkäuferprofil

seller_profile

seller_id

—

seller_profile (keine Produktliste)

Verkäuferprofil

Bewertungen (Kundenbewertungen eines Verkäufers)

seller_feedback

seller_id

page (5 pro Seite)

seller_feedback (keine Produktliste)

Bewertungen

Die Antwortorte entsprechen den Beispielen in der Dokumentation. Lesen Sie diese sorgfältig durch. Der folgende Parser zeigt, wie es geht.

Drei Details bereiten den Nutzern Schwierigkeiten. Der Wert des Angebots lautet todays-deals, mit dem Bindestrich und dem „s“. Die API akzeptiert seller als Alias für seller_products, aber geben Sie den vollständigen Wert an, damit Ihre Protokolle lesbar bleiben. Und parent_alias gilt nur für Bestseller und Neuerscheinungen, wo es auf eine Unterkategorie verweist.

Für Rezensionen verwenden Sie seller_feedback , um Bewertungszeilen zu erfassen, und product für die Bewertung und die Anzahl der Bewertungen einer ASIN.

Dokumentation: Amazon-Suchtypen

Wie kann man ein Amazon-Produkt anhand der ASIN auslesen?

Senden Sie „type=product“, wobei „product_id“ auf die ASIN gesetzt ist – die zehnstellige ID nach „/dp/“ in jeder Amazon-Produkt-URL. Das „product_results“-Objekt der Antwort enthält den Titel, den Preis, die Bewertung, die Gesamtzahl der Bewertungen, Kategorien, Bilder und Attribute sowie Produkt-Highlights, sofern Amazon diese anzeigt. Fügen Sie „amazon_domain“ hinzu, um dieselbe ASIN auf einem anderen Amazon-Marktplatz abzurufen.

In https://www.amazon.com/dp/B098RNZGNWist die ASIN B098RNZGNW. Da dieselbe ASIN in der Regel auf mehreren Marktplätzen existiert, ermöglicht eine ID in Verbindung mit amazon_domain können Sie ein Produkt länderübergreifend vergleichen.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=product" \
  --data-urlencode "product_id=B098RNZGNW" \
  --data-urlencode "amazon_domain=amazon.co.uk"
import re
from amazon_client import amazon_get

url = "https://www.amazon.com/dp/B098RNZGNW"
asin = re.search(r"/dp/([A-Z0-9]{10})", url).group(1)

data, _ = amazon_get({"type": "product", "product_id": asin})
item = data.get("product_results", {})
rating = item.get("rating", {})
print(item.get("title"), item.get("price"), rating.get("rating"), rating.get("total_ratings"))

Beispielantwort (aus der API-Dokumentation kopiert, gekürzt):

{
  "product_results": {
    "product_id": "B098RNZGNW",
    "title": "Example Amazon Product",
    "item_highlights": "Foldable card table for board games, dining, and extra seating",
    "price": "$59.99",
    "rating": { "rating": "4.6 out of 5 stars", "total_ratings": 12438 },
    "categories": ["Electronics", "Headphones"],
    "images": ["https://m.media-amazon.com/images/I/example-1.jpg"],
    "attributes": { "Brand": "Example", "Color": "Black" }
  }
}

price ist eine Anzeigezeichenfolge wie beispielsweise "$59.99"; lassen Sie sie daher unverändert mit ihrer Domain und analysieren Sie die Zahl in einem separaten Schritt. rating.rating ist Text, während rating.total_ratings eine Ganzzahl ist, die Sie im Zeitverlauf vergleichen können. Es handelt sich um das Bewertungssignal auf Produktebene, das mit den Käuferbewertungen des Verkäufers abgeglichen wird. item_highlights wird weggelassen, wenn Amazon keine anzeigt. Setze wait_for_offers=true , wenn die Angebotsmodule relevant sind, und wait_for_video=true für Videomodule.

Die Feldabdeckung variiert je nach Seite. Angaben zu Buy Box, Händler, Varianten und Verfügbarkeit hängen davon ab, was auf den einzelnen Produktseiten angezeigt wird. Überprüfen Sie daher eine repräsentative Stichprobe Ihrer eigenen ASINs, bevor Sie ein Schema entwerfen. An dieser Stichprobe setzt auch die Überwachung von Preis und Buy Box an.

Dokumentation: Amazon-Produkt

Wie lassen sich Amazon-Suchergebnisse auslesen und paginieren?

Senden Sie „type=search“ mit „q“ auf das Suchwort gesetzt. Die Produkte werden in „search_results.product_results“ zurückgegeben, jeweils mit Position, ASIN, Titel, Link, Preis und Bewertung, und „related_searches“ listet die Vorschläge von Amazon auf. Fordere „page=2“, „3“ und so weiter an, um weitere Ergebnisse zu erhalten, und verwende „sort_by“ oder „filter_by=prime“, wenn du Amazons eigene Sortierung oder den Prime-Filter benötigst.

Die Amazon-Suchergebnisse (die Amazon-SERP) zeigen, wer bei einer Suchanfrage angezeigt wird und in welcher Reihenfolge. position ist der Rang in der zurückgegebenen Liste für dieses Schlüsselwort, diese Domain, diese Seite und diesen Zeitpunkt. Speichern Sie ihn zusammen mit q, amazon_domain, page, sort_byund dem Erfassungszeitpunkt zusammen, da Rank-Vergleiche sonst ihre Aussagekraft verlieren.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=search" \
  --data-urlencode "q=memory card" \
  --data-urlencode "page=2" \
  --data-urlencode "filter_by=prime"

Um die Ergebnisse zu paginieren, halten Sie q, die Domain und die Sortiereinstellungen gleich und erhöhen Sie page. Da jede Seite eine eigene Anfrage darstellt, sollten Sie die Anzahl der Seiten pro Suchbegriff begrenzen:

from datetime import datetime, timezone
from amazon_client import amazon_get

rows = []
for page in range(1, 4):  # page cap: three pages per keyword
    params = {"type": "search", "q": "memory card", "page": page, "amazon_domain": "amazon.com"}
    data, _ = amazon_get(params)
    found = data.get("search_results", {}).get("product_results", [])
    if not found:
        break
    captured_at = datetime.now(timezone.utc).isoformat()
    rows += [{**params, "captured_at": captured_at, "position": r.get("position"),
              "product_id": r.get("product_id"), "price_text": r.get("price")} for r in found]
print(len(rows), "rows")

Beispielantwort (aus der API-Dokumentation kopiert, gekürzt):

{
  "related_searches": [
    { "query": "micro sd card", "link": "https://www.amazon.com/s?k=micro+sd+card" }
  ]
}

sort_by akzeptiert featured, price-asc-rank, price-desc-rank, review-rank, date-desc-rankund relevancerank. filter_by akzeptiert prime und climate-friendly. Behalten Sie beide Werte über alle Durchläufe hinweg bei, wenn Sie Positionen verfolgen. Suchseiten können außerdem top_sponsored, video_sponsored, paginationund amazon_pagination. Lesen Sie diese aus, sofern vorhanden, und gehen Sie niemals davon aus, dass sie vorhanden sind.

Wenn Sie die Suchposition im Zeitverlauf verfolgen, vergleichen Sie diese Zeilen mit den Google-Ergebnissen für dasselbe Keyword.

Dokumentation: Amazon-Suche

Wie kann man die Amazon-Bestseller-Rankings auslesen?

Sende „type=bestsellers“ zusammen mit einer „category_id“, die ein Alias wie „Elektronik“ oder eine numerische Knoten-ID sein kann, und füge „parent_alias“ hinzu, um eine Unterkategorie zu erreichen. Der „keyless categories“-Helper ermittelt beide Werte anhand eines Suchbegriffs. Die rangierten Produkte werden in „category_results.product_results“ ausgegeben, jeweils mit der von Amazon angezeigten Position, der ASIN, dem Titel, dem Link und dem Preis.

In drei Schritten erhalten Sie eine Rangliste:

  1. Suchen Sie die Kategorie mit dem „Categories“-Helper, für den kein API-Schlüssel erforderlich ist.
  2. Übergeben Sie dessen category_idsowie parent_alias für eine Unterkategorie.
  3. Lesen Sie category_results.product_results.
curl "https://amazon-helpers.webscrapingapi.com/categories?q=electronics&limit=3"

Antwort des Helpers (gekürzt):

[
  { "title": "Amazon Launchpad Top Electronics", "href": "/gp/new-releases/boost/23602499011", "parent_alias": "boost", "category_id": "23602499011" },
  { "title": "Electronics", "href": "/gp/new-releases/boost/21179674011", "parent_alias": "boost", "category_id": "21179674011" },
  { "title": "Electronics", "href": "/gp/new-releases/automotive/3248690011", "parent_alias": "automotive", "category_id": "3248690011" }
]

Lies die Felder des Helpers anhand des Schlüssels aus, da die Namen von der Tabelle in der Dokumentation abweichen können. Aliase auf oberster Ebene wie electronics funktionieren ohne Nachschlagen:

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=bestsellers" \
  --data-urlencode "category_id=electronics"

Beispielantwort (aus der API-Dokumentation kopiert, gekürzt):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B08C1W5N87", "title": "Fire TV Stick with Alexa Voice Remote",
        "link": "/fire-tv-stick-with-3rd-gen-alexa-voice-remote/dp/B08C1W5N87", "price": "$19.99",
        "rating": { "rating": "4.7 out of 5 stars", "total_ratings": 141438 } }
    ]
  }
}

position ist Amazons aktuell angezeigter Rang für diese Kategorie zu diesem Zeitpunkt; speichern Sie daher den Erfassungszeitpunkt und vergleichen Sie Läufe, die nach demselben Zeitplan durchgeführt wurden. Beachten Sie das relative link: Fügen Sie solchen Pfaden vor dem Speichern die Domain voran, was absolute_link() im Abschnitt „Parser“ erfolgt.

Dokumentation: Amazon-Bestseller

Wie erhält man die Amazon-Neuerscheinungen für eine Kategorie?

Senden Sie „type=new-releases“ zusammen mit einer „category_id“, z. B. „fashion“, und fügen Sie „parent_alias“ für eine Unterkategorie hinzu, genau wie bei den Bestsellern. Die Antwort listet Amazons angesagte Neuerscheinungen für diese Kategorie in „category_results.product_results“ auf, mit Position, ASIN, Titel, Link und Preis. Führen Sie den Aufruf regelmäßig aus, um zu sehen, welche Neuerscheinungen in die Liste aufgenommen werden und welche sie verlassen.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=new-releases" \
  --data-urlencode "category_id=fashion"

Beispielantwort (aus der API-Dokumentation kopiert; die ASIN ist der Platzhalter aus der Dokumentation):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B09EXAMPLE", "title": "New release product",
        "link": "https://www.amazon.com/dp/B09EXAMPLE", "price": "$29.99" }
    ]
  }
}

Ermitteln Sie die Unterkategorie-IDs und deren parent_alias mit dem Kategorien-Helper aus dem Abschnitt „Bestseller“. Verwenden Sie diese Anfrage zur Verfolgungsaufzeichnung: eine Kategorie und ein Markt pro Ausführung, jedes Mal nach demselben Zeitplan.

Dokumentation: Amazon-Neuerscheinungen

Wie kann man eine Amazon-Kategorieauflistung auslesen?

Sende „type=category“ zusammen mit einer „category_id“, entweder einem Alias wie „amazon-devices“ oder einer numerischen Knoten-ID. Füge „page“ hinzu, um weitere Ergebnisse zu erhalten, und „sort_by“, um die Reihenfolge zu ändern. Die Produkte werden in „category_results.product_results“ mit Position, ASIN, Titel, Link, Preis und Bewertung zurückgegeben, sodass Sie einen gesamten Browse-Knoten statt nur eines Stichworts nachverfolgen können.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=category" \
  --data-urlencode "category_id=amazon-devices" \
  --data-urlencode "page=2"

Beispielantwort (aus der API-Dokumentation kopiert, gekürzt):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B08C1W5N87", "title": "Fire TV Stick with Alexa Voice Remote",
        "link": "/fire-tv-stick-with-3rd-gen-alexa-voice-remote/dp/B08C1W5N87", "price": "$19.99",
        "rating": { "rating": "4.7 out of 5 stars", "total_ratings": 141438 } }
    ]
  }
}

Eine Kategorieabfrage liefert die Browse-Liste in der von Amazon gewählten Sortierreihenfolge, während „bestsellers“ die Rangliste der Bestseller zurückgibt. page und sort_by gilt hier, parent_alias gilt dies nicht. Links können relativ sein, wie bei den Bestsellern.

Dokumentation: Amazon-Kategorie

Wie kann man Amazons „Angebote des Tages“ auslesen?

Senden Sie „type=todays-deals“ statt „deals“ zusammen mit einer „category_id“ wie beispielsweise 15684181. Die Aktionsprodukte werden in „category_results.product_results“ zurückgegeben, und jede Zeile enthält „price“ (den aktuellen Aktionspreis) sowie „price_raw“ (den Preis vor der Aktion). Speichern Sie beide Werte zusammen mit dem Erfassungszeitpunkt, da sich die Angebote im Laufe des Tages ändern und eine spätere Anfrage eine andere Liste zurückgeben kann.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=todays-deals" \
  --data-urlencode "category_id=15684181"

Beispielantwort (aus der API-Dokumentation kopiert, gekürzt):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B081T7N948", "title": "Cleaning Gel for Car",
        "link": "/Cleaning-Universal-Detailing-Automotive-Interior/dp/B081T7N948",
        "price": "$5.94", "currency": "$", "price_raw": "$9.99" }
    ]
  }
}

Berechnen Sie den Rabatt nur auf die geparsten Zahlen, nachdem Sie das Währungssymbol der jeweiligen Domain entfernt haben, und behalten Sie auch die Rohzeichenfolgen bei:

deal, before = float(row["price"].lstrip("$")), float(row["price_raw"].lstrip("$"))
discount_pct = round((before - deal) / before * 100, 1)  # 40.5 for the sample row

Angebotslinks können relativ sein, führen Sie sie daher über absolute_link().

Dokumentation: Amazon-Angebote

Wie listet man die Produkte auf, die ein Verkäufer auf Amazon anbietet?

Senden Sie „type=seller_products“ mit der Verkäufer-ID in „seller_id“. Die Antwort listet die Produkte dieses Verkäufers in „search_results.product_results“ auf, mit Position, ASIN, Titel, Link und Preis, im gleichen Format wie bei der Suche. Füge „page“ hinzu, um weitere Ergebnisse zu erhalten. Der kürzere Alias „seller“ funktioniert ebenfalls, aber verwende „seller_products“, damit dein Code lesbar bleibt.

Verwende die Verkäufer-ID, die in der URL des Verkäufers in der Shop-Oberfläche angegeben ist.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=seller_products" \
  --data-urlencode "seller_id=AAZRLVTNON75Z"

Beispielantwort (aus der API-Dokumentation kopiert, gekürzt):

{
  "search_results": {
    "product_results": [
      { "position": 1, "product_id": "B01NGTV4J5", "title": "Cascade Platinum Dishwasher Pods",
        "link": "https://www.amazon.com/dp/B01NGTV4J5", "price": "$38.88", "currency": "$" }
    ]
  }
}

Da die Zeilen mit den Suchergebnissen übereinstimmen, funktionieren hier derselbe Parser und derselbe Speichercode. Speichere sie pro Durchlauf, um zu sehen, welche ASINs ein Händler anbietet und zu welchen Preisen sie angezeigt werden.

Dokumentation: Amazon-Verkäuferprodukte

Wie erhält man das Profil und die Bewertung eines Amazon-Verkäufers?

Senden Sie „type=seller_profile“ zusammen mit der „seller_id“. Das „seller_profile“-Objekt gibt „seller_details“ mit dem Shop-Namen, dem Shop-Link, der Sternebewertung, der Gesamtzahl der Bewertungen und dem Prozentsatz positiver Bewertungen zurück, sowie eine kurze Liste der jüngsten Rückmeldungen und eine Rückmeldungszusammenfassung mit den Prozentsätzen für positive, neutrale und negative Rückmeldungen. Es handelt sich um eine Anfrage pro Verkäufer, ohne Produktliste und ohne Paginierung.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=seller_profile" \
  --data-urlencode "seller_id=AAZRLVTNON75Z"

Beispielantwort (aus der API-Dokumentation kopiert, gekürzt):

{
  "seller_profile": {
    "seller_details": { "name": "Triplenet Pricing INC", "store_link": "https://www.amazon.com/s?me=AAZRLVTNON75Z",
      "rating": 4, "ratings_total": 4078, "ratings_positive_percentage": 74 },
    "feedback": [ { "rating": 5, "body": "Great service", "rater": "By Sarah M. on July 24, 2023." } ],
    "feedback_summary": [ { "positive_percent": 75, "neutral_percent": 1, "negative_percent": 24, "count": 366 } ]
  }
}

Verwenden Sie ein Profil, um Drittanbieter zu überprüfen, die um eine „Buy Box“ konkurrieren, oder um den Shop ratings_total und ratings_positive_percentage pro Durchlauf, um die Entwicklung der Position eines Verkäufers zu verfolgen. Die feedback Liste hier ist ein kurzes aktuelles Beispiel. Blättern Sie für jede Bewertungszeile durch die unten stehende Anfrage zum Verkäufer-Feedback.

Dokumentation: Amazon-Verkäuferprofil

Wie kann man Amazon-Bewertungen mithilfe der Verkäufer-Feedback-Abfrage auslesen?

Senden Sie „type=seller_feedback“ zusammen mit einer „seller_id“. Dies ist die Bewertungsabfrage der Amazon-API: Jede Zeile enthält eine Käuferbewertung dieses Verkäufers mit dem Bewerter, der Sternebewertung, dem Bewertungstext, dem Datum und der Angabe, ob der Verkäufer geantwortet hat. Die Ergebnisse werden in Gruppen von fünf pro Seite ausgegeben. Folgen Sie daher „pagination.has_next_page“ und „next_page“, bis Sie die von Ihnen festgelegte Seitenobergrenze erreichen.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=seller_feedback" \
  --data-urlencode "seller_id=AAZRLVTNON75Z" \
  --data-urlencode "page=2"

Beispielantwort (aus der API-Dokumentation kopiert, gekürzt):

{
  "seller_feedback": [
    { "rater": "Sarah M.", "rating": 5, "has_response": false, "body": "Great service",
      "date": { "raw": "July 24, 2023", "utc": "2023-07-24T04:00:00.000Z" }, "position": 1 }
  ],
  "pagination": { "current_page": 1, "has_next_page": true, "next_page": 2 }
}

Jede Seite ist eine eigene Anfrage, daher summieren sich bei einem langen Bewertungsverlauf die Anfragen. Dieser Pager stoppt, wenn keine nächste Seite mehr vorhanden ist oder wenn er auf max_pages:

# seller_feedback_pages.py
from amazon_client import amazon_get


def all_feedback(seller_id, max_pages=3):
    page, rows = 1, []
    while page and page <= max_pages:
        data, _ = amazon_get({"type": "seller_feedback", "seller_id": seller_id, "page": page})
        rows += data.get("seller_feedback", [])
        pagination = data.get("pagination", {})
        page = pagination.get("next_page") if pagination.get("has_next_page") else None
    return rows


reviews = all_feedback("AAZRLVTNON75Z")
print(len(reviews), "reviews")

Store seller_id und date.utc bei jeder Bewertung und entfernt Duplikate zwischen den Durchläufen. date.raw entspricht dem Anzeigeformat von Amazon. Kombinieren Sie dies mit Produktdaten: type=product liefert die Bewertung und die Gesamtzahl der Bewertungen für jede ASIN, sodass die beiden Anfragen zusammen das Bewertungsvolumen, die Sternebewertungen und den Text der Verkäuferbewertungen abdecken.

Dokumentation: Amazon-Verkäufer-Feedback

Wie kann man eine andere Amazon-Domain, ein anderes Land oder eine andere Postleitzahl angeben?

Setzen Sie „amazon_domain“ auf einen der zwanzig unterstützten Marktplätze, wie z. B. „amazon.de“ oder „amazon.co.jp“. Die Standardeinstellung ist „amazon.com“. Fügen Sie „delivery_location“ mit einem Ländercode wie „de“ oder „gb“ hinzu, um das Standardlieferland festzulegen, oder „zip_code“ für eine lokale US-Adresse. Verwenden Sie „hl“ und „gl“ für Sprache und Land und protokollieren Sie jede Einstellung mit den Ergebnissen.

Preis, Verfügbarkeit und Lieferversprechen auf Amazon hängen vom Marktplatz und der Lieferadresse ab, sodass zwei Aufrufe mit unterschiedlichen Einstellungen nicht vergleichbar sind. Definieren Sie ein kleines Marktraster (jede ASIN oder jedes Keyword × jede Domain × jeden Lieferort) und behalten Sie dieses zwischen den Durchläufen bei.

Region

Domains

Amerika

amazon.com, amazon.ca, amazon.com.mx, amazon.com.br

Europa

amazon.co.uk, amazon.de, amazon.fr, amazon.it, amazon.es, amazon.nl, amazon.pl, amazon.se, amazon.com.tr

Naher Osten und Afrika

amazon.ae, amazon.sa, amazon.eg

Asien-Pazifik

amazon.co.jp, amazon.in, amazon.sg, amazon.com.au

Alle diese allgemeinen Parameter sind optional:

Parameter

Funktion

Werte

amazon_domain

Welcher Amazon-Marktplatz soll gelesen werden?

Eine der oben genannten 20 Domains; Standard: amazon.com

delivery_location

Standard-Lieferland

us, de, gb, ca, fr, jp, cn, au, es, br, in, mx

zip_code

Lokaler Kontext der Lieferadresse

Eine Postleitzahl

hl / gl

Sprache / Land

Sprach- und Ländercodes

page

Ergebnisseite

Ganzzahl

sort_by

Sortierung der Such- oder Kategorieergebnisse

Empfohlen, Preis aufsteigend, Preis absteigend, Bewertung, Datum absteigend, Relevanz

filter_by

Ergebnisse filtern

Prime, klimafreundlich

scroll_to_bottom

Vollbild-Scroll vor der Extraktion

true / false (false ist schneller)

wait_bottom_carousel

Auf das unterste Karussell warten

wahr / falsch (falsch ist schneller)

lazy_loading

Zusätzliche Wartezeit nach dem Laden der Seite

Millisekunden

wait_for_offers / wait_for_video

Auf Angebots- oder Videomodule auf Produktseiten warten

true / false

delivery_location akzeptiert nur die zwölf aufgeführten Codes, daher hat nicht jede Domain einen passenden Wert. Es gibt keine it oder nl, zum Beispiel. Wenn Sie keine Module im unteren Bereich der Seite benötigen, setzen Sie scroll_to_bottom=false und wait_bottom_carousel=false ein, um schnellere Antworten zu erhalten. Verwenden Sie lazy_loading , wenn eine Seite nach dem Laden mehr Zeit benötigt.

In Node.js sind die Markteinstellungen weitere Schlüssel in URLSearchParams:

const params = new URLSearchParams({
  engine: "amazon",
  api_key: process.env.WSA_API_KEY,
  type: "search",
  q: "memory card",
  amazon_domain: "amazon.de",
  delivery_location: "de",
});

Dokumentation: Unterstützte Domänen

Wie liest und speichert man die JSON-Antwort?

Beginnen Sie mit `search_parameters`, das Ihre Anfrage und die abgerufene Amazon-URL wiedergibt, sowie mit `search_information`. Lesen Sie anschließend die Zeilen aus `search_results`, `category_results`, dem einzelnen `product_results`-Objekt, `seller_profile` oder `seller_feedback`, je nach Typ. Behandeln Sie alle anderen Module als optional, behalten Sie die rohen Preiszeichenfolgen mit ihrer Domain bei und speichern Sie jede Zeile mit ihren Anfrageeinstellungen.

In den Beschreibungen und Beispielen der Dokumentation werden Produkte manchmal unter anderen Schlüsseln aufgeführt. Im Text auf der Kategorieseite heißt es product_results, während das dazugehörige Beispiel dies unter category_results, und der Text auf der Verkäufer-Produktseite nennt seller_results, während das Beispiel search_results. Daher überprüft der Parser jeden dokumentierten Speicherort und gibt eine leere Liste zurück, anstatt abzustürzen. Fügen Sie dies zu amazon_client.py:

def product_rows(data):
    """Return the product list wherever this request type puts it."""
    for container in ("search_results", "category_results"):
        rows = (data.get(container) or {}).get("product_results")
        if isinstance(rows, list):
            return rows
    single = data.get("product_results")
    return [single] if isinstance(single, dict) else []


def absolute_link(link, amazon_domain="amazon.com"):
    """Category-style responses can return relative links such as /Item/dp/ASIN."""
    if not link or link.startswith("http"):
        return link
    return f"https://www.{amazon_domain}{link}"

product_rows() gibt Zeilen für alle sieben Produkttypen zurück. Lesen Sie seller_profile und seller_feedback nach ihren eigenen Schlüsseln, wie in den jeweiligen Abschnitten beschrieben. Flach dann jedes Produkt in eine Speicherzeile um:

# store.py
from datetime import datetime, timezone
from amazon_client import absolute_link, product_rows


def to_records(data, request):
    """One flat row per product, with the request settings that produced it."""
    captured_at = datetime.now(timezone.utc).isoformat()
    domain = request.get("amazon_domain", "amazon.com")
    amazon_url = (data.get("search_parameters") or {}).get("amazon_url")
    for row in product_rows(data):
        rating = row.get("rating") or {}
        yield {
            "captured_at": captured_at,
            "type": request["type"],
            "input": request.get("q") or request.get("category_id")
                     or request.get("seller_id") or request.get("product_id"),
            "amazon_domain": domain,
            "delivery_location": request.get("delivery_location"),
            "page": request.get("page", 1),
            "position": row.get("position"),
            "product_id": row.get("product_id"),
            "title": row.get("title"),
            "price_text": row.get("price"),
            "rating_text": rating.get("rating"),
            "total_ratings": rating.get("total_ratings"),
            "link": absolute_link(row.get("link"), domain),
            "amazon_url": amazon_url,
        }

Behalten Sie auch die Rohantwort bei, damit Sie sie erneut verarbeiten können, wenn Sie Felder hinzufügen. Unterscheiden Sie eine fehlgeschlagene Anfrage (ein HTTP-Fehler) von einer erfolgreichen Anfrage mit einem fehlenden Modul (eine leere Liste). Letzteres ist eine Beobachtung, kein Fehler. Weitere Muster finden Sie unter „Parsen von JSON-Antworten in Python“.

Auf der Preisseite sind für jeden Tarif JSON-, CSV- und HTML-Ausgaben aufgeführt. Die Amazon-Dokumentation beschreibt JSON-Antworten, daher wird in dieser Anleitung durchgehend JSON verwendet.

Wie sollte Ihr Code mit Fehlern, Wiederholungsversuchen und der Nutzung von Credits umgehen?

Versuchen Sie es bei 401- oder Validierungsfehlern nicht erneut. Korrigieren Sie den Schlüssel, das Abonnement oder die Parameter. Versuchen Sie es bei den Fehlern 429, 500, 502 und 503 einige Male mit exponentiellem Backoff und Jitter erneut und reduzieren Sie bei 429 die Parallelität. Ein 422 bedeutet, dass Amazon einen Fehler, eine Herausforderung oder ein Timeout zurückgegeben hat; versuchen Sie es daher nur einmal erneut, wenn der Fehler vorübergehend zu sein scheint.

Status

Body oder Form

Bedeutung

Maßnahme

401

Access denied. No key api_key provided.

Kein Schlüssel gesendet

Konfiguration korrigieren; keinen erneuten Versuch unternehmen

401

Access denied. Invalid api_key provided. oder Authentication failure: …

Falscher Schlüssel oder der Schlüssel ist nicht für die Amazon-API berechtigt

Überprüfen Sie den Schlüssel und das Abonnement; keinen erneuten Versuch

Validierungsfehler

Parameter '<name>' not allowed. und Ähnliches

Falscher oder fehlender Parameter für engine=amazon

Korrigieren Sie die Anfrage; versuchen Sie es nicht erneut

422

error_type: "website"

Amazon hat einen Fehler, eine Challenge, einen ungültigen Body oder ein Timeout zurückgegeben

Einmal wiederholen, falls vorübergehend

429

{"error":"max_concurrent_connections"}

Parallelitätsgrenze erreicht

Parallelitätsgrenze senken, Wartezeit einlegen, erneut versuchen

500 / 503

Internal Server Error / other_failure

Vorübergehender API-Fehler

Mehrmals mit zeitlich gestaffeltem Backoff wiederholen

Eine Anfrage ohne Schlüssel gibt diesen Body mit HTTP-Status 401 zurück:

{ "error": "Access denied. No key `api_key` provided." }

Weitere Validierungsmeldungen sind unter anderem Parameter '<name>' is required., must be a boolean, must be in range, sowie cannot be used with. Sie bedeuten, dass die Anfrage selbst fehlerhaft ist, sodass ein erneuter Versuch nichts ändert. Wenn eine /v1 Anfrage die Antwort „Dieser Endpunkt ist veraltet. Bitte verwende /v2.“ liefert, ist dein Schlüssel nicht für die Amazon-API registriert. Registriere ihn im Dashboard, anstatt den Endpunkt zu wechseln.

amazon_get() setzt diese Richtlinie um. Es versucht es bei HTTP-429- und 5xx-Antworten mit exponentiellem Backoff und zufälligem Jitter erneut, berücksichtigt einen numerischen „Retry-After“-Header, sofern vorhanden, versucht es bei einem 422-Fehler einmal erneut und löst bei allen anderen Fällen eine Ausnahme aus, wobei der Schlüssel unkenntlich gemacht wird. Bei wiederholten 429-Fehlern sollten zudem weniger parallele Worker ausgeführt werden.

Pro Aufruf zwei Header protokollieren: Searchdata-Call-Credit-Usage (für diesen Aufruf belastete Credits) und Searchdata-Current-Credit-Usage (der aktuelle Verbrauch Ihres Kontos). Ein Protokoll dieser Art über eine Woche zeigt, welche Typen und Märkte Ihr Kontingent beanspruchen.

Dokumentation: Fehler und Header

Wie viel kostet die Amazon Scraper API?

Stand Oktober 2026 kostet die Testversion 0 $ für 100 Amazon-Anfragen. Die kostenpflichtigen Tarife sind monatlich: „Starter“ kostet 59 $ für 10.000 Anfragen, „Grow“ 375 $ für 250.000, „Business“ 1.000 $ für 1.000.000 und „Pro“ 2.200 $ für 2.500.000. Jeder Tarif umfasst alle Amazon-Domains, Produkt- und Bewertungs-APIs, Such- und Kategoriergebnisse sowie Bestseller.

Tarif

Preis

Amazon-Anfragen

Preis pro 1.000

Testversion

0

100

—

Starter

59 $/Monat

10.000

5,90 $

Grow

375 $/Monat

250.000

1,50

Business

1.000 $/Monat

1.000.000

1,00

Pro

2.200 $/Monat

2.500.000

0,88

Jeder Tarif umfasst alle Amazon-Domains, Produkt- und Bewertungs-APIs, Such- und Kategoriergebnisse, die Bestseller-API, JSON-, CSV- und HTML-Ausgabe sowie die Massenverarbeitung. Die Preise sind in US-Dollar angegeben. In diesem Leitfaden sind die Produkt- und Bewertungs-APIs die product und seller_feedback Anfragen.

Wählen Sie einen Tarif anhand Ihrer Eingaben aus, nicht nach Schätzung:

Anfragen pro Monat = Eingaben (ASINs, Schlüsselwörter, Kategorien, Verkäufer) × Domains × Lieferorte × Seiten pro Eingabe × Durchläufe pro Monat, zuzüglich Spielraum für Tests und Wiederholungsversuche

Beispiel: 400 ASINs × 2 Domains × 1 Seite × 4 wöchentliche Durchläufe ergeben 3.200 Anfragen, was in den „Starter“-Tarif passt. Fügen Sie 50 Keywords × 2 Domains × 3 Seiten × 30 tägliche Durchläufe hinzu, also weitere 9.000, und die Gesamtzahl von 12.200 übersteigt das „Starter“-Kontingent, sodass „Grow“ die nächste Stufe ist. Preise und Kontingente ändern sich, daher ist die Preisseite die maßgebliche Quelle. Sie sind noch auf der Suche nach einem Anbieter? Lesen Sie unseren Leitfaden zum Vergleich von Amazon-Scraping-APIs.

Was kann die Amazon-API nicht, und wann ist eine andere Option besser?

Die Amazon-API deckt die neun in ihrer Referenz aufgeführten Seitentypen ab – und nur diese. Es gibt keinen asynchronen Amazon-Job, die Feldabdeckung variiert je nach Seite, und jedes Ergebnis beschreibt eine Domain, einen Standort und einen Zeitpunkt. Für andere Seiten, andere Marktplätze oder vorgefertigte Datensätze nutzen Sie die Scraper-API, eine andere Data-API-Quelle oder einen verwalteten Feed.

  • Seiten außerhalb der neun Typen. Fordern Sie dafür ein Beispiel an oder rufen Sie die Seiten als HTML ab. Erfahren Sie, wie Sie die Scraper-API nutzen.
  • Sie möchten lieber Ihren eigenen Scraper erstellen. Um den Scraper selbst auszuführen und zu warten, folgen Sie einer praktischen Anleitung für einen Python-Amazon-Scraper.
  • Sie möchten Datensätze statt Abfragen. Für vorbereitete, regelmäßig aktualisierte Amazon-Daten sehen Sie sich den Amazon-Produktdatensatz an.
  • Sie benötigen einen anderen Marktplatz. Die Data API deckt auch andere Einzelhändler ab, beispielsweise Produktdaten von Walmart.
  • Keine asynchronen Jobs für Amazon. Jeder Aufruf ist synchron; führen Sie daher Ihre eigene Job-Warteschlange mit der oben genannten Wiederholungsrichtlinie aus.
  • Die Felder variieren je nach Seite. Prüfen Sie ein repräsentatives Beispiel, bevor Sie sich auf ein Schema festlegen.
  • Die Nutzung unterliegt bestimmten Regeln. Erfassen Sie ausschließlich öffentlich zugängliche Seiten gemäß der Nutzungsvereinbarung der WebScrapingAPI und den für Sie geltenden Anforderungen.

Häufig gestellte Fragen

Gibt es eine kostenlose Testversion der Amazon-Scraper-API?

Ja. Ab Oktober 2026 kostet der Amazon-API-Testplan von WebScrapingAPI 0 US-Dollar und umfasst 100 Amazon-Anfragen – genug, um Produkt-, Such-, Bestseller- und Verkäuferanfragen anhand Ihrer eigenen Eingaben zu testen. Erstellen Sie ein Konto, abonnieren Sie die Amazon-API im Dashboard und speichern Sie den Schlüssel während der Testphase in einer Umgebungsvariablen.

Was ist eine ASIN und wo finde ich sie?

Eine ASIN ist Amazons zehnstellige Produktkennung, und die Amazon-API verwendet sie als „product_id“. Sie finden sie in einer Produkt-URL hinter „/dp/“ oder im Abschnitt „Produktinformationen“ bzw. „Zusätzliche Informationen“ auf der Produktseite. Dieselbe ASIN kann auf verschiedenen Amazon-Domains unterschiedliche Preise und Verfügbarkeiten anzeigen.

Wie kann ich die Amazon-Bestseller-Rankings auslesen?

Senden Sie „type=bestsellers“ zusammen mit einer „category_id“, z. B. „electronics“, und fügen Sie „parent_alias“ hinzu, wenn Sie eine Unterkategorie abrufen möchten. Der „keyless categories“-Helper ermittelt beide Werte anhand eines Schlüsselworts. Die Ergebnisse werden in „category_results.product_results“ mit der von Amazon angezeigten Position, der ASIN, dem Titel, dem Link, dem Preis und der Bewertung ausgegeben; speichern Sie daher den Erfassungszeitpunkt mit jeder Zeile.

Welche Amazon-Marktplätze unterstützt die API?

Sie unterstützt zwanzig Amazon-Domains: die Vereinigten Staaten, Kanada, Mexiko, Brasilien, das Vereinigte Königreich, Deutschland, Frankreich, Italien, Spanien, die Niederlande, Polen, Schweden, die Türkei, die Vereinigten Arabischen Emirate, Saudi-Arabien, Ägypten, Japan, Indien, Singapur und Australien. Legen Sie „amazon_domain“ fest, um eine davon auszuwählen, und verwenden Sie „delivery_location“ oder „zip_code“, wenn sich die von Amazon angezeigten Informationen aufgrund des Lieferkontexts ändern.

Kann ich die Amazon-API über JavaScript im Browser aufrufen?

Tun Sie das nicht. Eine Browseranfrage würde Ihren API-Schlüssel jedem offenlegen, der die Entwicklertools öffnet, und der Schlüssel steuert Ihr Kontingent im Rahmen Ihres Tarifs. Rufen Sie die API von einem Server, einer serverlosen Funktion oder einem geplanten Job aus auf, lesen Sie den Schlüssel aus einer Umgebungsvariablen oder einem Secrets-Manager aus und senden Sie nur die geparsten Ergebnisse an das Frontend.

Wie blättere ich durch die Amazon-Suchergebnisse?

Füge „page=2“, „page=3“ und so weiter zu einer „type=search“-Anfrage mit denselben „q“--, „domain“- und „sort“-Einstellungen hinzu. Jede Seite ist eine separate Anfrage, die auf dein Kontingent angerechnet wird; lege daher eine Seitenobergrenze pro Suchbegriff fest. Speichere die Seitenzahl bei jeder Zeile, damit du später das vollständige Ranking für diesen Suchbegriff wiederherstellen kannst.

Kann die Amazon-API Bewertungen auslesen?

Ja. Senden Sie „type=seller_feedback“ zusammen mit einer „seller_id“, um Kundenbewertungen eines Verkäufers zu erfassen – fünf pro Seite, jeweils mit dem Bewerter, der Sternebewertung, dem Bewertungstext, dem Datum und der Angabe, ob der Verkäufer geantwortet hat. Für Bewertungssignale auf Produktebene liefert „type=product“ die Bewertung und die Gesamtzahl der Bewertungen für jede ASIN. Verfolgen Sie „pagination.has_next_page“, um jede Seite auszulesen.

Warum gibt meine Anfrage die Fehlermeldung „Parameter nicht zulässig“ zurück?

Die API überprüft jeden Parameter anhand der Amazon-Engine und lehnt Namen ab, die sie nicht akzeptiert. Häufige Ursachen sind ein falsch geschriebener oder falsch großgeschriebener Parametername, ein Parameter aus einer anderen Engine oder ein nicht kodiertes „&“-Zeichen in Ihrem Suchbegriff, das diesen in einen neuen Parameter aufteilt. Korrigieren Sie die Anfrage, anstatt sie erneut zu versuchen.

Wie erfahre ich, wie viele Credits eine Anfrage verbraucht hat?

Lesen Sie den Antwort-Header „Searchdata-Call-Credit-Usage“, der die für diesen Aufruf belasteten Credits angibt, sowie den Header „Searchdata-Current-Credit-Usage“, der den aktuellen Verbrauch Ihres Kontos angibt. Protokollieren Sie beides zusammen mit dem Anfragetyp, der Eingabe und der Domain. Über eine Woche hinweg zeigt dieses Protokoll, welche Anfragetypen und Märkte Ihr Kontingent verbrauchen und ob Ihr Tarif noch passt.

Kann ich Amazon-Daten abrufen, ohne Code zu schreiben?

Ja, wenn ein vorgefertigter Feed Ihren Anforderungen entspricht. WebScrapingAPI kann Amazon-Datensätze als Datensatz oder als verwaltete Sammlung nach einem Zeitplan bereitstellen, nachdem Sie Beispieldaten für Ihre Seiten, Felder und Märkte geprüft haben. Die API eignet sich für Teams, die Eingaben und Zeitpunkte selbst festlegen möchten, während ein verwalteter Feed für Analysten geeignet ist, die lediglich regelmäßig wiederkehrende Dateien benötigen.

Starten Sie mit 100 kostenlosen Amazon-Anfragen

Die Amazon Scraper API liefert Produkt-, Such-, Kategorie-, Bestseller-, Angebot-, Verkäufer- und Verkäuferbewertungsseiten aus 20 Amazon-Marktplätzen als strukturiertes JSON, wobei die Parser-Pflege für Sie übernommen wird. Wenn Sie Ihre ASINs, Schlüsselwörter, Märkte und den Aktualisierungszeitplan kennen, vergleichen Sie die Amazon-API-Tarife und wählen Sie das für Sie passende Kontingent aus.

Über den Autor

Robert Sfichi, Full-Stack-Entwickler @ WebScrapingAPI

Robert Sfichi

Full-Stack-Entwickler

Robert Sfichi ist Teammitglied bei WebScrapingAPI, wo er an der Produktentwicklung mitwirkt und dabei hilft, zuverlässige Lösungen zu entwickeln, die die Plattform und ihre Nutzer unterstützen.

Web-Scraping mit AWS Lambda: Leitfaden für Python und Java 2026
Anleitungen

Web-Scraping mit AWS Lambda: Leitfaden für Python und Java 2026

TL;DR: Kurz gesagt: Web-Scraping mit AWS Lambda funktioniert am besten, wenn jeder Aufruf kurz, begrenzt und unabhängig wiederholbar ist. Beginnen Sie mit direktem HTTP, AWS SAM und S3 und fügen Sie erst dann SQS, Container, Browser-Rendering, Proxys oder eine verwaltete Abrufebene hinzu, wenn sich im Rahmen der Arbeitslast herausstellt, dass diese erforderlich sind.

Suciu Dan26 min read
Artikel lesen
So verwenden Sie GoSpider: Crawlen, URLs bereinigen und Daten extrahieren
Anleitungen

So verwenden Sie GoSpider: Crawlen, URLs bereinigen und Daten extrahieren

TL;DR: GoSpider ist ein Befehlszeilen-Crawler zum Auffinden von URLs, kein vollständiger Scraper für strukturierte Daten. Diese Anleitung zur Verwendung von GoSpider zeigt einen begrenzten Crawl, die saubere Verarbeitung der Ausgabe, die Übergabe von Colly an CSV sowie einen Diagnosepfad für 403-Antworten oder Seiten, die eine JavaScript-Darstellung erfordern.

Suciu Dan20 min read
Artikel lesen
Wie man Redfin scrappt: Python-Leitfaden für Immobiliendaten
Anleitungen

Wie man Redfin scrappt: Python-Leitfaden für Immobiliendaten

TL;DR: Redfin stellt versteckte API-Endpunkte zur Verfügung, die strukturiertes JSON für Immobilienangebote zurückgeben, wodurch das fragile HTML-Parsing vollständig übersprungen werden kann. Diese Anleitung führt Sie durch den Aufbau eines Python-Scrapers, der Miet- und Verkaufsdaten extrahiert, nach Standort sucht, neue Angebote über XML-Sitemaps überwacht und saubere Ergebnisse in CSV oder JSON exportiert.

Suciu Dan11 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.