
Zum Inhalt springen
Zurück zum Blog

Alternativen zu Scrapebox: Fünf Tools für unterschiedliche Aufgaben

Raluca PenciucZuletzt aktualisiert am 13 min read
Alternativen zu Scrapebox: Fünf Tools für unterschiedliche Aufgaben
TL;DR: Wählen Sie Screaming Frog für die Extraktion bei Website-Audits, Scrapy für einen benutzerdefinierten, wiederkehrenden Crawler, Playwright für Browser-Interaktionen, Web Scraper für die visuelle Extraktion und OpenRefine für die Bereinigung der gesammelten Daten. Diese Tools ersetzen verschiedene Teile eines Arbeitsablaufs; prüfen Sie, welche Ergebnisse Sie benötigen, anstatt zu erwarten, dass eine einzige Anwendung alle Funktionen abdeckt.

Eine Alternative zu Scrapebox ist ein Ersatz für die jeweilige Aufgabe im Bereich Crawling, Extraktion, Audit oder Listenverarbeitung, die Sie derzeit ausführen. Die entscheidende Frage lautet: Welche Funktion muss ersetzt werden und wer wird sie nach Abschluss der Umstellung bedienen?

Stellen Sie sich vor, Ihr bestehender Workflow beginnt mit einer URL-Liste, extrahiert Seitentitel und Produktattribute, entfernt doppelte Einträge und exportiert einen Bericht. Der Datensammler, die Bereinigungsregeln und der Bericht sind getrennte Aufgabenbereiche, auch wenn sie derzeit von einer einzigen Desktop-Anwendung abgewickelt werden. Alle drei gleichzeitig zu verlagern, kann einen einfachen Werkzeugwechsel unerwartet schwierig machen.

Dieser Leitfaden vergleicht fünf dokumentierte Optionen für die seriöse Datenerfassung und -analyse. Er bewertet sie nicht anhand nicht messbarer Geschwindigkeit und ermittelt keinen universellen Sieger. Ein technisches SEO-Audit und ein browserbasierter Produkt-Workflow stellen unterschiedliche Anforderungen, sodass ihre besten Ausgangspunkte voneinander abweichen können.

Sie werden die aktuelle Aufgabe abbilden, einen geeigneten Ersatz in die engere Wahl nehmen und die resultierenden Datensätze validieren, bevor Sie den alten Prozess außer Betrieb nehmen. Der Fokus liegt auf nützlichen Daten mit wiederholbarer Verarbeitung, nicht auf der bloßen Ausweitung des Erfassungsvolumens um ihrer selbst willen.
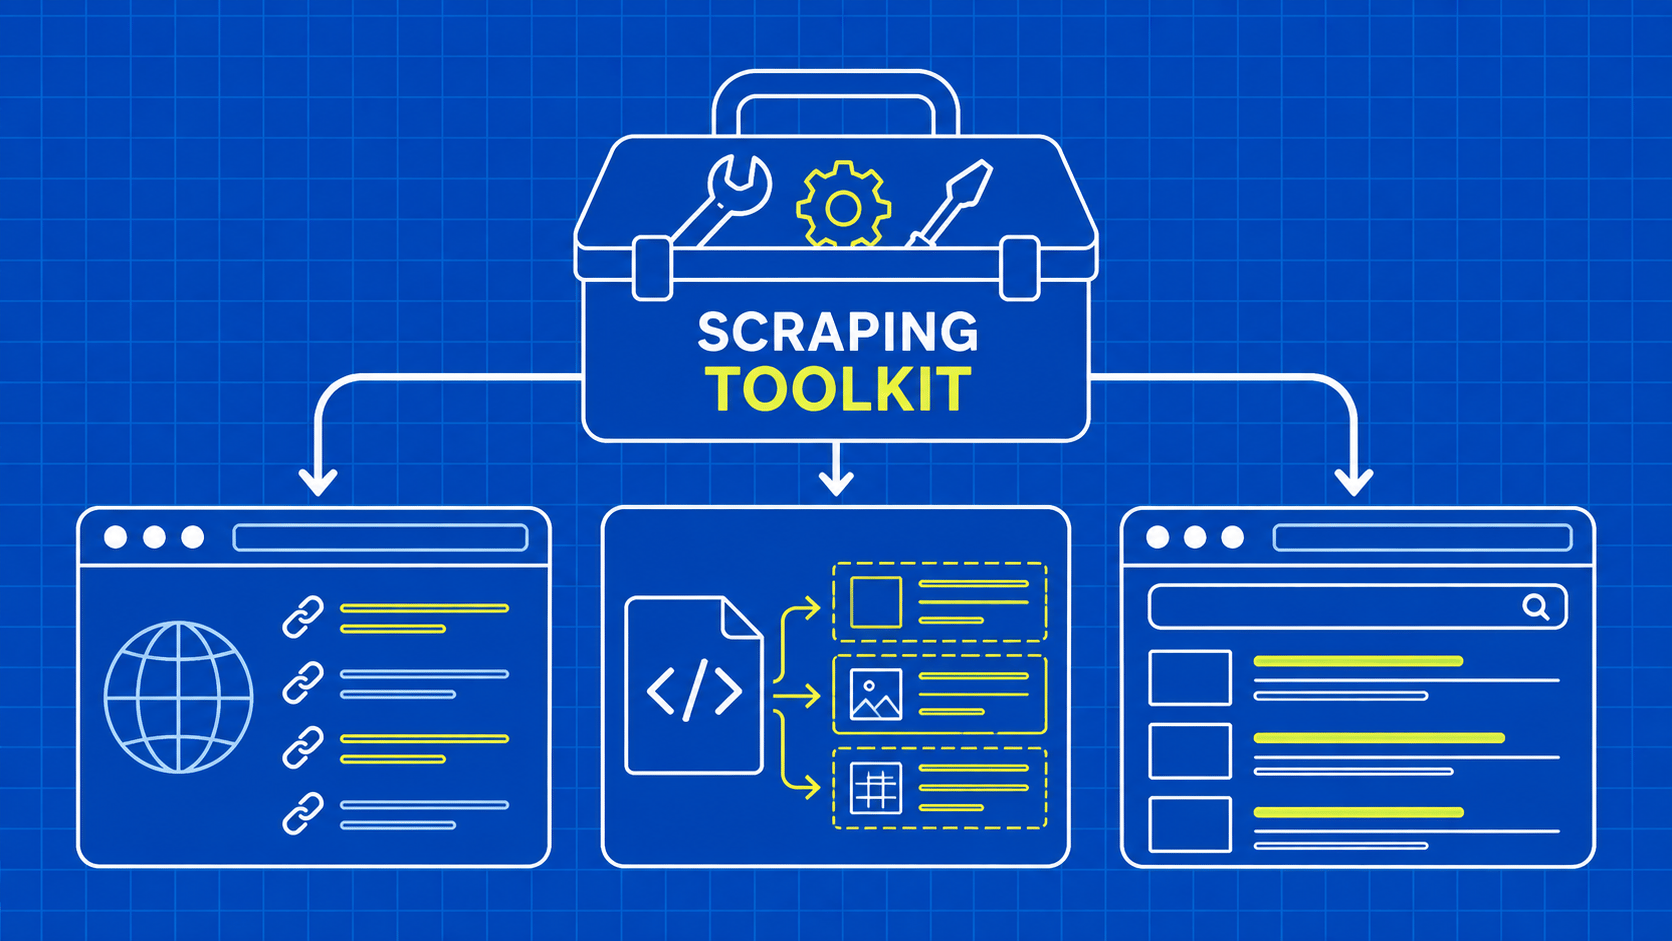
Wählen Sie eine Scrapebox-Alternative anhand der Aufgabe, die sie ersetzt

Die Funktionsübersicht von Scrapebox beschreibt eine breite Palette an Funktionen zur URL-Ermittlung, Metadaten-Extraktion, Audits und Listenverarbeitung. Diese Bandbreite erklärt, warum eine Auswahlliste für Ersatzlösungen sehr unterschiedliche Arten von Software enthalten kann. Ein für eine bestimmte Funktion geeignetes Tool ist nicht automatisch ein Ersatz für die anderen.

Beginnen Sie mit einer kleinen Bestandsaufnahme der Schritte, die Sie tatsächlich nutzen. Ermitteln Sie die Eingaben, die erwarteten Ergebnisse, die erforderliche Interaktion, die Anforderungen an die Zeitplanung und die für Fehler verantwortliche Person. Ignorieren Sie bei der ersten Bewertung ungenutzte Funktionen; andernfalls könnten Sie eine gut geeignete Lösung ablehnen, nur weil sie Funktionen nicht bietet, die Sie nie benötigt haben.

Ihre Hauptaufgabe

Zu bewertender Kandidat

Was es nicht automatisch löst

Webseiten untersuchen und Audit-Felder extrahieren

Screaming Frog SEO Spider

Beliebige Geschäftsabläufe oder die Datenqualität in nachgelagerten Prozessen

Erstellen eines wiederkehrenden Crawlers mit benutzerdefinierter Logik

Scrapy

Betrieb der Bereitstellung und Pflege der Quellregeln

Klicken, auswählen, scrollen und gerenderte Seiten untersuchen

Playwright

Eine vollständige Crawling-Warteschlange und Datensatz-Pipeline

Extraktion visuell konfigurieren

Web-Scraper

Überprüfen, ob ausgewählte Felder korrekte Datensätze bilden

Überprüfung und Normalisierung eines bestehenden Datensatzes

OpenRefine

Ein vollständiger Ersatz für die Erkennung und Erfassung von Websites

Dies sind aufgabenbezogene Empfehlungen, kein getestetes Ranking. Prüfen Sie die aktuelle Version, die unterstützte Umgebung und die Lizenz für die von Ihnen benötigte Funktion, bevor Sie sich für ein Tool entscheiden. Eine ansprechende Benutzeroberfläche garantiert noch keine Kompatibilität mit Ihren Bereitstellungs- oder Exportanforderungen.

Wenn das Auffinden von Suchergebnissen die fehlende Komponente ist, bewerten Sie dies getrennt vom Crawlen der Zielseiten. Eine aus einem Suchergebnis gewonnene URL und eine von einem Crawler untersuchte Seite sind unterschiedliche Beobachtungen. Unser Einstiegsleitfaden zur SERP-API erläutert diesen Teil einer Erfassungsarchitektur.

Screaming Frog für Audits und die Extraktion auf Seitenebene

Das Tutorial zur benutzerdefinierten Extraktion von Screaming Frog dokumentiert die Extraktion von Website-Daten mithilfe von CSS-Selektoren, XPath oder regulären Ausdrücken. Es ist ein sinnvoller Ausgangspunkt, wenn es darum geht, eine Reihe von Webseiten zu untersuchen und im Rahmen eines Audit-Workflows Felder auf Seitenebene zurückzugeben.

Beispielsweise benötigen Sie möglicherweise Titel, kanonische Referenzen und ein bestimmtes Produktattribut von genehmigten Seiten. Erstellen Sie einen Beispielexport und überprüfen Sie, welche Werte zu den einzelnen URLs gehören, bevor Sie weitere Felder hinzufügen. Dies ist besonders wichtig, wenn eine Seite mehrere Produktkarten oder sich wiederholende Elemente enthält.

Bevorzugen Sie ein auditorientiertes Tool, wenn eine Person die Crawling-Ergebnisse überprüft und die Extraktionslogik relativ einfach ist. Wenn sich die Aufgabe auf komplexe Anwendungszustände, mehrstufige Navigation oder eine lang andauernde Verbraucher-Pipeline ausweitet, sollten Sie neu bewerten, ob eine Audit-Oberfläche weiterhin der richtige Mittelpunkt des Workflows ist.

Behandeln Sie den Export als vorläufige Daten und nicht als automatische Wahrheit. Ein Selektor kann Text erfolgreich abgleichen, dabei aber den falschen Abschnitt einer Seite auswählen. Bewahren Sie einige geprüfte Beispiele auf und überprüfen Sie diese nach Konfigurationsänderungen. Die Entscheidung für das Tool sollte sich nach der Eignung der resultierenden Datensätze richten, nicht nach der Anzahl der Spalten, die es erzeugen kann.

Scrapy für eine benutzerdefinierte, wiederkehrende Erfassungspipeline

Die Übersicht zu Scrapy beschreibt ein Framework zum Crawlen von Websites und zum Extrahieren strukturierter Daten. Es eignet sich besser, wenn Entwickler Extraktionsregeln versionieren, die Durchquerung steuern und die Datenerfassung in eine Anwendung integrieren möchten, anstatt in erster Linie ein interaktives Audit durchzuführen.

Dies ist sowohl eine Entscheidung zur Projektumsetzung als auch eine Wahl des Tools. Sie erhalten die Möglichkeit, quellspezifische Logik zu definieren, aber Ihr Team ist für das Projekt, die Bereitstellung und die Fehlerbehebung verantwortlich. Ein Framework stellt keinen Verantwortlichen für die Wartung bereit und legt auch nicht fest, was ein akzeptierter Datensatz bedeutet.

Verwenden Sie separate Spider oder Adapter für Quellenmuster, die sich wesentlich unterscheiden. Halten Sie das Ausgabeschema konsistent, damit nachgelagerte Verbraucher nicht wissen müssen, welcher Parser eine Seite verarbeitet hat. Definieren Sie Versionsselektoren und Transformationen und testen Sie diese anschließend anhand gespeicherter Beispiele, die die Annahmen Ihres Codes widerspiegeln.

Scrapy-Item-Pipelines bieten explizite Phasen zur Verarbeitung extrahierter Items, einschließlich Validierung und Duplikatsbehandlung. Diese Trennung ist nützlich beim Übergang von einem Desktop-Export zu einem wiederkehrenden Datensatz: Die Pipeline kann einen fehlerhaften Datensatz zurückweisen, bevor er den Verbraucher erreicht.

Das Scrapy-Tutorial ist ein praktischer nächster Schritt, wenn dieses Verantwortungsmodell passt. Wählen Sie ein Framework nicht allein deshalb aus, weil es flexibel ist. Wählen Sie es, wenn das erforderliche benutzerdefinierte Verhalten den Entwicklungsaufwand rechtfertigt und das Team es nach der ersten Implementierung bedienen kann.

Playwright für Browser-Interaktionen, die sich nicht allein durch die Extraktion abbilden lassen

Die Bibliotheksdokumentation von Playwright zeigt die programmgesteuerte Browser-Automatisierung. Ziehen Sie es in Betracht, wenn die benötigten Daten von Aktionen wie der Auswahl einer Variante, dem Öffnen eines Fensters oder dem Durchlaufen eines Seiten-Workflows abhängen. Es handelt sich um eine Browser-Komponente, nicht um eine vollständige Datenplattform.

Beschreiben Sie den Zustand, den Sie beobachten müssen, bevor Sie Aktionen schreiben. Der angezeigte Preis eines Produkts kann von einer ausgewählten Größe, Region oder Lieferoption abhängen. Zeichnen Sie diesen Kontext zusammen mit dem extrahierten Wert auf, damit die Ausgabe später interpretiert werden kann. Ein Screenshot einer Seite ohne ihren Auswahlkontext erklärt möglicherweise nicht, warum ein Wert von einem anderen Durchlauf abweicht.

Playwright führt vor den relevanten Aktionen dokumentierte Überprüfungen der Ausführbarkeit durch, doch diese Überprüfungen stellen keine Validierung von Geschäftsdaten dar. Eine anklickbare Schaltfläche beweist nicht, dass die resultierenden Produktdaten bereitstehen oder korrekt sind. Verwenden Sie explizite Assertions für die Felder und den Zustand, die der Workflow erfordert. Siehe die Dokumentation zum automatischen Warten.

Beschränken Sie die Browserausführung. Legen Sie fest, welche Fehler den Workflow stoppen, wie lange ein Schritt warten darf und welche Nachweise bei einer fehlgeschlagenen Beobachtung aufbewahrt werden. Wenn dieselben Seiten die erforderlichen Felder ohne Interaktion bereitstellen können, prüfen Sie einen einfacheren Abrufweg, bevor Sie die Browserkomplexität erhöhen.

Für Workflows, die Crawling- und Browserschritte kombinieren, erläutert der Leitfaden zu Scrapy und Playwright einen Integrationsansatz. Die Kombination erfordert weiterhin Ihre Quellrichtlinie, Ihr Schema, Ihre Validierung und Ihre Auslieferungsregeln.

Web Scraper für visuelle Auswahl und wiederholbare Seitenmuster

Die Dokumentation zu den Selektoren von Web Scraper unterscheidet zwischen Selektoren für Datenextraktion, Navigation und Interaktion. Es lohnt sich zu prüfen, ob ein visuell konfigurierbarer Workflow für das Team geeignet ist und ob sich die Zielseiten durch wiederholbare Selektorbeziehungen ausdrücken lassen.

Der wichtigste Test ist die Datensatzgruppierung. In der Dokumentation wird erläutert, dass wiederholte Felder, die zum selben Element gehören, unter einem Selektor für wiederholte Elemente verschachtelt werden sollten; unabhängige, wiederholte Selektoren auf gleicher Ebene werden nicht automatisch anhand ihrer Position gepaart. Das ist von Bedeutung, wenn eine Seite viele Karten mit Titel, Preis und Link enthält.

Überprüfen Sie exportierte Zeilen aus verschiedenen Seitenvorlagen. Fügen Sie eine Karte mit einem fehlenden optionalen Feld ein, damit Sie erkennen können, ob nachfolgende Werte in den falschen Datensatz verschoben werden. Ein Export mit der erwarteten Anzahl an Zeilen kann dennoch falsch gepaarte Felder enthalten.

Ein visuelles Tool kann den Codeaufwand für die Umsetzung einer Extraktion reduzieren. Es erspart jedoch nicht die Notwendigkeit, Felder zu definieren, Werte zu validieren oder die Konfiguration bei Änderungen an der Website anzupassen. Setzen Sie es ein, wenn der Arbeitsablauf für die Person, die ihn später reparieren muss, nachvollziehbar bleibt, und prüfen Sie, wie Konfiguration und Exporte für eine zukünftige Migration erhalten bleiben können.

OpenRefine für die Bereinigungsphase, nicht für den Crawler

OpenRefine gehört nur dann auf diese Liste, wenn die Bereinigung von Listen Teil der Aufgabe ist, die Sie ersetzen möchten. Die Dokumentation zur Zellbearbeitung beschreibt Facetten, Transformationen und Clustering-Vorschläge, die ein Benutzer überprüfen kann. Es ist ein nützliches Werkzeug, um gesammelte Werte in einen konsistenteren Datensatz umzuwandeln.

Halten Sie die Abgrenzung klar: Das Bereinigen einer Tabelle ist nicht gleichbedeutend mit dem Sammeln der Quellseiten. Sie können einen Crawler oder ein visuelles Extraktionswerkzeug mit einem Überprüfungsschritt kombinieren, sollten jedoch jede Komponente anhand ihrer jeweiligen Aufgabe bewerten.

Nutzen Sie Clustering, um mögliche Inkonsistenzen zu finden, und nicht, um zu behaupten, dass ähnliche Zeichenfolgen dieselbe Entität darstellen. Die Erläuterung zum Clustering in OpenRefine unterscheidet zwischen syntaktischer Ähnlichkeit und semantischer Abstimmung. Zwei Firmennamen oder Produkttitel können sich ähnlich sehen, ohne dass sie dasselbe beschreiben.

Behalten Sie Originalwerte und Identifikatoren bei, bevor Sie Transformationen anwenden. Überprüfen Sie die vorgeschlagenen Zusammenführungen und bewahren Sie genügend Herkunftsdaten auf, um eine falsche Entscheidung rückgängig machen zu können. Diese Option eignet sich besonders gut für eine von Menschen überprüfte Bereinigungswarteschlange, wenn die Schwierigkeit eher im Verstehen inkonsistenter Bezeichnungen als im Abrufen weiterer Seiten liegt.

Definieren Sie die Ausgabe, bevor Sie den Workflow neu erstellen

Eine Ersetzung kann nur dann fair bewertet werden, wenn beide Systeme aufgefordert werden, denselben Datensatz zu erzeugen. „Diese Website scrapen“ ist keine ausreichende Spezifikation. Entscheiden Sie, ob eine Zeile eine URL, ein Produkt, ein Angebot oder eine Beobachtung von etwas zu einem bestimmten Zeitpunkt darstellt.

Bei einer Seitenprüfung sollten die angeforderte URL, die endgültige URL, das Antwort-Ergebnis, der Beobachtungszeitpunkt und die extrahierten Felder erfasst werden. Bei wiederkehrenden Produktdatensätzen sollten eine stabile Quellenkennung sowie die übergeordnete Seite, von der der Datensatz stammt, hinzugefügt werden. Gründe für fehlende Felder sollten von tatsächlichen negativen Werten getrennt behandelt werden.

Anforderung

Eine konkrete Abnahmeregel

Warum dies wichtig ist

Identität

Jeder akzeptierte Datensatz verfügt über einen stabilen Quellschlüssel

Wiederholte Durchläufe können verglichen werden, ohne dass die Reihenfolge der Zeilen berücksichtigt werden muss

Geltungsbereich

Jede angeforderte Seite gehört zur genehmigten Quellmenge

Die Erkennung darf das Projekt nicht stillschweigend erweitern

Aktualität

Der Erfassungszeitpunkt wird getrennt vom Verarbeitungszeitpunkt gespeichert

Ein kürzlich durchgeführter Export kann keine alten Datensätze verschleiern

Fehlende Daten

Unbekannte, nicht verfügbare und fehlgeschlagene Extraktionen bleiben klar voneinander getrennt

Nutzer leiten keine Schlussfolgerungen aus leeren Feldern ab

Herkunft

Quellort und Konfigurationsversion werden beibehalten

Ein umstrittenes Ergebnis kann untersucht werden

Trennen Sie Rohbeobachtungen von Bereinigungsentscheidungen. Wenn ein Tool einen Titel extrahiert und ein anderes ihn normalisiert, bewahren Sie die Beziehung zwischen den beiden auf. Andernfalls kann ein Prüfer nicht erkennen, ob ein überraschender Wert aus der Quelle oder aus einer Transformation stammt.

Verwenden Sie einen kleinen, geprüften Datensatz, um die Bedeutung der Felder festzulegen, bevor Sie den Workflow fortsetzen. Eine klare Vereinbarung ist wertvoller als ein umfangreicher erster Crawl, bei dem sich niemand über die Interpretation der Datensätze einig ist.

Führen Sie die Migration mit einem begrenzten Pilotprojekt und einem Wiederherstellungstest durch

Wählen Sie repräsentative Seiten und einige Randfälle aus, anstatt sich nur auf die einfachsten URLs zu beschränken. Berücksichtigen Sie Paginierung, fehlende Felder, wiederholte Elemente, Weiterleitungen und alle Interaktionen, die der endgültige Job benötigt. Verwenden Sie gegebenenfalls gespeicherte zulässige Testdaten, damit Konfigurationsänderungen konsistent getestet werden können.

Führen Sie den neuen Prozess parallel zum bestehenden Prozess für diese Stichprobe aus. Vergleichen Sie Werte und Datensatzbeziehungen, nicht nur die Anzahl der Zeilen. Wenn sich die Ergebnisse unterscheiden, untersuchen Sie, ob der alte Workflow falsch war, der neue falsch ist oder ob sie auf unterschiedlichen Annahmen basieren. Der ältere Export dient als Referenz zur Überprüfung, nicht als unumstößliche „Grundwahrheit“.

Messen Sie den personellen Aufwand, der für die Vorbereitung, Ausführung, Überprüfung und Korrektur des Jobs erforderlich ist. Eine schnellere Erfassungsphase kann mehr Aufräumarbeit verursachen. Umgekehrt kann ein detaillierterer Ablehnungsbericht die Überprüfungszeit verkürzen, selbst wenn der eigentliche Crawl länger dauert. Vermeiden Sie pauschale Behauptungen zu Geschwindigkeit oder Einsparungen, die auf einem nicht repräsentativen Test basieren.

Testen Sie einen fehlgeschlagenen Durchlauf, bevor Sie das Tool einführen. Können Sie feststellen, welche Eingaben fehlten? Kann der Auftrag fortgesetzt werden, ohne dass akzeptierte Datensätze dupliziert werden? Kann eine Konfigurationsänderung rückgängig gemacht werden? Ein Export unter optimalen Bedingungen beantwortet keine dieser Fragen.

Halten Sie die erste Produktionsbereitstellung klein genug, um sie überprüfen zu können. Bestimmen Sie einen Verantwortlichen für die Wartung und behalten Sie die Möglichkeit bei, eine einzelne Quelle anzuhalten. Stellen Sie den alten Schritt erst dann ein, wenn der Verbraucher die neue Ausgabe nutzen kann und der Wiederherstellungsprozess verstanden wurde.

Halten Sie den Erfassungsumfang und die Vorgänge explizit fest

Überprüfen Sie die Zugriffsbedingungen der Quelle und den Zweck der Datenerfassung, bevor Sie wiederkehrende Jobs ausführen. Crawling-Regeln sind relevant, aber RFC 9309 stellt klar, dass „Robots“-Direktiven kein Mechanismus zur Zugriffsautorisierung sind. Eine Tool-Funktion begründet keine Berechtigung, sie bei einer bestimmten Quelle zu verwenden.

Legen Sie zugelassene Hosts, eine maximale Seitenanzahl, eine Anforderungsrate und begrenzte Wiederholungsversuche fest. Wenn eine Quelle mit einer Zugriffsbeschränkung antwortet, halten Sie den Job an und überprüfen Sie die Quelle, anstatt den Job wiederholt denselben Fehler auslösen zu lassen. Schützen Sie Anmeldedaten und vermeiden Sie die Speicherung unnötiger personenbezogener Daten in Diagnoseexporten.

Trennen Sie die Datenerfassung von ausgehenden Aktionen. Eine URL-Liste für Recherchen sollte nicht automatisch zu einer Warteschlange für Beiträge, Nachrichten oder die Erstellung von Konten werden. Konzentrieren Sie sich bei der Ersetzung auf die genehmigte Datenaufgabe und leiten Sie alle nachgelagerten Aktionen über einen eigenen, sorgfältig geplanten Workflow weiter.

Überwachen Sie nützliche Ergebnisse: neue akzeptierte Datensätze, fehlende Quellen, geänderte Selektoren und den Überprüfungsrückstand. Ein Fortschrittsbalken, der sich dem Abschluss nähert, kann neben einem völlig leeren Feld bestehen, wenn sich eine Website-Vorlage ändert. Warnmeldungen sollten die nicht erfüllte Erwartung benennen, damit der Verantwortliche für die Wartung handeln kann, ohne den gesamten Job neu erstellen zu müssen.

Wichtige Erkenntnisse

  • Ersetzen Sie eine definierte Aufgabe statt einer ganzen Liste von Funktionen, die Sie nicht nutzen.
  • Ordnen Sie Audit-Extraktion, benutzerdefiniertes Crawling, Browser-Interaktion und Bereinigung verschiedenen Tool-Kategorien zu.
  • Überprüfen Sie die Datensatzgruppierung und die Feldbedeutung, bevor Sie einem Export vertrauen.
  • Vergleichen Sie den Gesamtaufwand für die Bediener und das Wiederherstellungsverhalten während eines begrenzten Pilotprojekts.
  • Halten Sie nach der Migration die Herkunft, die Umfangskontrollen und die nachfolgenden Maßnahmen explizit fest.

FAQ

Kann der neue Workflow CSV als Ausgabformat beibehalten?

Ja, sofern CSV die erforderlichen Felder eindeutig darstellt und der Empfänger es konsistent verarbeitet. Verwenden Sie stabile Identifikatoren, explizite Kodierungen und korrekt in Anführungszeichen gesetzte Felder, anstatt sich auf die Zeilenposition zu verlassen. Speichern Sie umfangreichere Herkunftsdaten in einem separaten, verbindlichen Speicher, falls durch eine Vereinfachung wichtiger Kontext verloren ginge. Das Exportformat kann vertraut bleiben, während der Erfassungs- und Validierungsprozess verbessert wird.

Sollten Sie eine einzige Konfiguration für alle Websites verwenden?

Nur dann, wenn die Websites tatsächlich denselben strukturellen Annahmen folgen. Eine wiederverwendbare Basis ist hilfreich, doch das Zusammenzwängen unabhängiger Layouts in einen einzigen Selektorsatz kann Ausnahmen verbergen und Korrekturen riskant machen. Halten Sie quellspezifische Überschreibungen sichtbar und testen Sie diese unabhängig voneinander. Versionsverwalten Sie die gemeinsame Konfiguration, damit eine für eine Quelle beabsichtigte Änderung die anderen nicht unerwartet verändert.

Kann KI bei der Pflege von Extraktionsregeln helfen?

Ja, als überprüfte Entwicklungshilfe. Sie kann Selektoren vorschlagen oder eine geänderte Seite erklären, doch generierte Regeln müssen weiterhin anhand von Quellbeispielen und erwarteten Datensätzen getestet werden. Behandeln Sie Seiteninhalte als nicht vertrauenswürdige Eingabe und halten Sie abgeleitete Werte von direkten Beobachtungen getrennt. Akzeptieren Sie eine plausible Erklärung für einen Parser-Fehler nicht als Beweis dafür, dass die Ersatzregel funktioniert.

Fazit

Die richtige Scrapebox-Alternative ist das Tool, das zu der Aufgabe passt, die Sie weiterhin erledigen müssen. Beginnen Sie mit der Überprüfung der Extraktion, dem benutzerdefinierten Crawling, der Browserinteraktion, der visuellen Konfiguration oder der Bereinigung und testen Sie dann den geeigneten Kandidaten anhand klarer Ausgabevorgaben. Eine zielgerichtete Kombination lässt sich oft leichter warten als ein Ersatz, der nur deshalb ausgewählt wurde, weil seine Funktionsliste vertraut wirkt.

Erstellen Sie ein geprüftes Beispiel, messen Sie den gesamten Workflow und testen Sie die Wiederherstellung vor der Umstellung. Halten Sie die Identität und Herkunft der Quellen stabil, damit die Migration nicht Ihre Fähigkeit beeinträchtigt, frühere Ergebnisse zu erklären.

Wenn Sie das Abrufen von Seiten aus Ihrem eigenen Stack auslagern möchten, prüfen Sie die Scraper-API von WebScrapingAPI für diese Ebene, während Sie Ihre Extraktions- und Validierungsregeln beibehalten. Das Ziel ist ein wiederholbarer Erfassungsprozess mit aussagekräftigen Ergebnissen und einem klar definierten Verantwortlichen für die Wartung. Wählen Sie das Tool oder die Kombination, die diesen Prozess für das dafür zuständige Team nachvollziehbar macht.

Über den Autor

Raluca Penciuc, Full-Stack-Entwickler @ WebScrapingAPI

Raluca Penciuc

Full-Stack-Entwickler

Raluca Penciuc ist Full-Stack-Entwicklerin bei WebScrapingAPI. Sie entwickelt Scraper, verbessert Umgehungsstrategien und findet zuverlässige Wege, um die Erkennung auf Zielwebsites zu verringern.

Web-Scraping mit AWS Lambda: Leitfaden für Python und Java 2026
Anleitungen

Web-Scraping mit AWS Lambda: Leitfaden für Python und Java 2026

TL;DR: Kurz gesagt: Web-Scraping mit AWS Lambda funktioniert am besten, wenn jeder Aufruf kurz, begrenzt und unabhängig wiederholbar ist. Beginnen Sie mit direktem HTTP, AWS SAM und S3 und fügen Sie erst dann SQS, Container, Browser-Rendering, Proxys oder eine verwaltete Abrufebene hinzu, wenn sich im Rahmen der Arbeitslast herausstellt, dass diese erforderlich sind.

Suciu Dan26 min read
Artikel lesen
So verwenden Sie GoSpider: Crawlen, URLs bereinigen und Daten extrahieren
Anleitungen

So verwenden Sie GoSpider: Crawlen, URLs bereinigen und Daten extrahieren

TL;DR: GoSpider ist ein Befehlszeilen-Crawler zum Auffinden von URLs, kein vollständiger Scraper für strukturierte Daten. Diese Anleitung zur Verwendung von GoSpider zeigt einen begrenzten Crawl, die saubere Verarbeitung der Ausgabe, die Übergabe von Colly an CSV sowie einen Diagnosepfad für 403-Antworten oder Seiten, die eine JavaScript-Darstellung erfordern.

Suciu Dan20 min read
Artikel lesen
Wie man Redfin scrappt: Python-Leitfaden für Immobiliendaten
Anleitungen

Wie man Redfin scrappt: Python-Leitfaden für Immobiliendaten

TL;DR: Redfin stellt versteckte API-Endpunkte zur Verfügung, die strukturiertes JSON für Immobilienangebote zurückgeben, wodurch das fragile HTML-Parsing vollständig übersprungen werden kann. Diese Anleitung führt Sie durch den Aufbau eines Python-Scrapers, der Miet- und Verkaufsdaten extrahiert, nach Standort sucht, neue Angebote über XML-Sitemaps überwacht und saubere Ergebnisse in CSV oder JSON exportiert.

Suciu Dan11 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.