
Zum Inhalt springen
Zurück zum Blog

Automatisiertes Web-Scraping: Erstellen Sie Jobs, die Sie wiederherstellen können

Andrei OgiolanZuletzt aktualisiert am 15 min read
Automatisiertes Web-Scraping: Erstellen Sie Jobs, die Sie wiederherstellen können
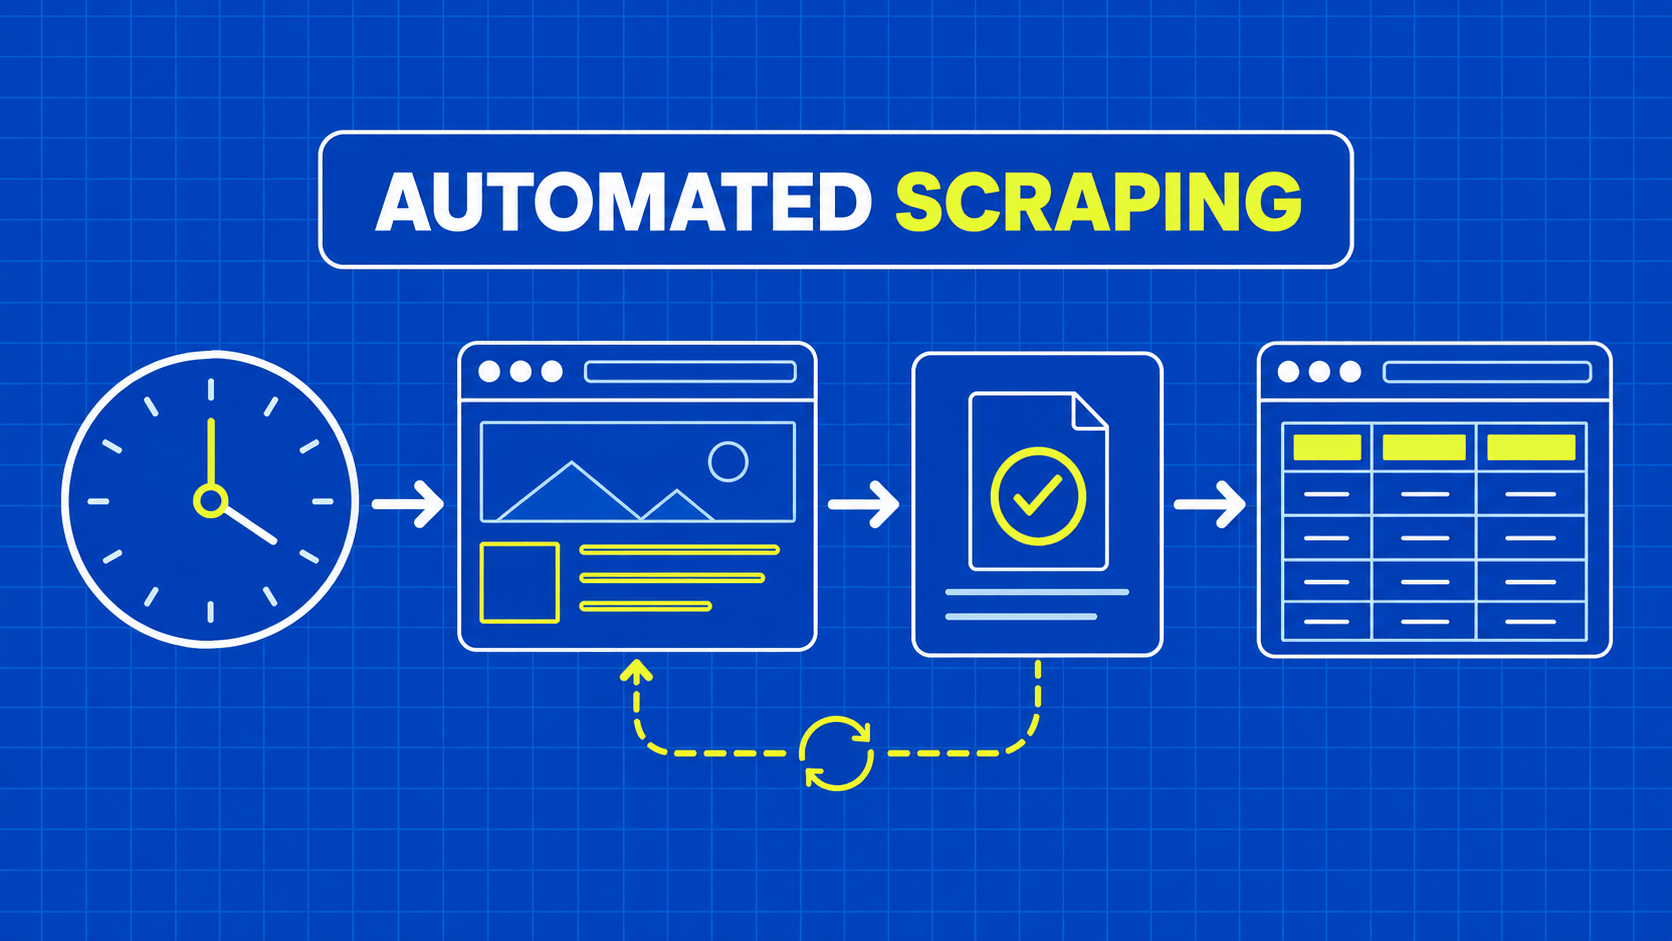
TL;DR: Für automatisiertes Web-Scraping braucht es mehr als nur einen Timer für ein Skript. Trennen Sie Planung, Erfassung, Validierung und Bereitstellung voneinander; weisen Sie jedem Durchlauf eine eindeutige Kennung zu; und gestalten Sie Wiederholungsversuche so, dass Fehler nicht stillschweigend Datensätze duplizieren oder die Abdeckung beeinträchtigen. Messen Sie die Verwertbarkeit und Aktualität der Daten, nicht nur die Anzahl erfolgreicher Anfragen.

Ein geplanter Datensammler wird ohne Ausnahme abgeschlossen, doch sein Export enthält die Daten von gestern und nur die Hälfte der erwarteten Produkte. Das Skript wurde ausgeführt. Der Datenjob ist fehlgeschlagen. Diese Unterscheidung sollte das System prägen, bevor Sie weitere Quellen hinzufügen oder die Parallelität erhöhen.

Automatisiertes Web-Scraping ist die wiederholte Erfassung und Transformation von Website-Daten durch einen definierten, unbeaufsichtigten Workflow. Ein Produktionsjob benötigt zudem eine Möglichkeit, unvollständige Ergebnisse zu erkennen, unterbrochene Vorgänge wiederherzustellen und zu erklären, was geliefert wurde. Andernfalls sorgt die Automatisierung nur dafür, dass sich dieselbe Unsicherheit nach einem Zeitplan wiederholt.

Für Entwickler ist ein „Run Contract“ der nützlichste Ausgangspunkt: Welche Quellen fallen in den Umfang, was gilt als gültige Beobachtung, wohin fließen die Ergebnisse und welche Fehler sollten die Auslieferung stoppen? Ein Collector mit diesen Grenzen ist einfacher zu betreiben als ein größerer Crawler, dessen einziges Erfolgssignal ein Exit-Code ist.

Dieser Leitfaden führt anhand einer wiederkehrenden Katalogerfassung als Beispiel durch diese Architektur. Die Muster gelten auch für öffentliche Verzeichnisse, Stellenanzeigen und Datensätze zur Änderungsüberwachung. Der Schwerpunkt liegt auf der Terminierung und der Semantik der Wiederherstellung, nicht auf dem Versprechen, dass jede Website automatisch gecrawlt werden kann oder dass die Automatisierung die Notwendigkeit einer Überprüfung beseitigt.
Definieren Sie den Ausführungsvertrag für automatisiertes Web-Scraping

Beginnen Sie mit der Ausgabe, die jemand nutzen wird. Ein Katalogauftrag könnte eine Beobachtung pro Quellprodukt und Region liefern, mit dem beobachteten Preis, der Währung, der Verfügbarkeit, der Quell-URL und dem Erfassungszeitpunkt. Schreiben Sie diese Definition auf, bevor Sie den Scheduler auswählen oder entscheiden, wie viele Worker gestartet werden sollen.

Trennen Sie erforderliche Felder von nützlichen optionalen Feldern. Eine fehlende Produkt-ID kann einen Datensatz unbrauchbar machen; ein fehlendes sekundäres Bild möglicherweise nicht. Definieren Sie die Reaktion auf jeden Fehler explizit. Ohne diese Unterscheidung könnte ein Entwickler die Zeile verwerfen, während ein anderer sie mit einer leeren Zeichenkette füllt, wodurch sich die Bedeutung des resultierenden Datensatzes zwischen den Releases ändert.

Verwenden Sie einen Ausführungsdatensatz, um den Job unabhängig von einzelnen Zeilen zu beschreiben. Das Folgende ist ein illustratives Schema, kein von einer bestimmten Plattform vorgeschriebenes Ausgabeformat:

{
  "run_id": "catalog-eu-2026-09-10-01",
  "source_set_version": "catalog-sources-v3",
  "parser_version": "catalog-parser-v7",
  "scheduled_for": "2026-09-10T06:00:00Z",
  "started_at": "2026-09-10T06:02:00Z",
  "status": "collecting",
  "counts": {
    "requested": 0,
    "fetched": 0,
    "valid": 0,
    "rejected": 0,
    "delivered": 0
  }
}

Der geplante Zeitpunkt und der tatsächliche Startzeitpunkt sind getrennt, da ein verzögerter Job nicht mit einer pünktlichen Beobachtung gleichzusetzen ist. Fügen Sie den Datensätzen auch die tatsächlichen Beobachtungszeitpunkte hinzu. Würde man jeder Zeile den Zeitstempel des Zeitplans zuweisen, würde dies bedeuten, dass die Quelle früher beobachtet wurde, als dies tatsächlich der Fall war.

Verwalten Sie die Quellenmenge versionsgesteuert. Das Hinzufügen eines Einzelhändlers oder das Entfernen einer fehlgeschlagenen Kategorie verändert den Erfassungsumfang, selbst wenn der Parser identisch bleibt. Ein nachgelagerter Analyst sollte in der Lage sein, eine größere Marktstichprobe von einer Veränderung des Marktes selbst zu unterscheiden.

Legen Sie schließlich einen Verantwortlichen und eine Abnahmerichtlinie fest. Entscheiden Sie, ob ein Teilauslauf mit einem Vollständigkeitskennzeichen ausgeliefert werden kann oder ob erst die Wiederherstellung abgewartet werden muss. Keine der beiden Vorgehensweisen ist allgemein gültig. Wichtig ist, dass die Nutzer erkennen können, welche Sie angewendet haben.

Trennen Sie Timer, Crawler und Auslieferungsmodul voneinander

Ein Timer legt fest, wann eine Aufgabe fällig ist. Ein Crawler entscheidet, welche Seiten angefordert und wie Felder extrahiert werden sollen. Ein Auslieferungsmodul verschiebt akzeptierte Datensätze an den Zielort. Die klare Trennung dieser Zuständigkeiten verhindert, dass ein fehlgeschlagener Export automatisch einen weiteren vollständigen Crawl auslöst.

Vorbereitungsphase

Eingabe

Ausgabe

Fehlergrenze

Zeitplan

Fälligkeitszeitpunkt und Quellkonfiguration

Lauf-ID

Fehlender oder doppelter Auslöser

Erkennen

Genehmigter Quellumfang

Anforderungskandidaten

Fehlende Kategorien oder Paginierung

Erfassen

Anfragen und Sitzungskontext

Antworten und Abrufergebnisse

Zeitüberschreitungen, Ablehnungen, unerwartete Seiten

Validieren

Extrahierte Kandidaten-Datensätze

Akzeptierte Zeilen und abgelehnte Belege

Schema- oder semantische Diskrepanz

Übergeben

Akzeptierter Stapel und Lieferkennung

Bestätigung vom Empfänger

Teilweise Schreibvorgänge oder doppelte Wiedergabe

Diese Aufteilung erfordert am ersten Tag keine separaten Dienste. Funktionen innerhalb einer Anwendung können dieselben expliziten Ein- und Ausgänge haben. Beginnen Sie mit einer Struktur, die Sie lokal testen können, und verteilen Sie dann nur die Phasen, deren Arbeitslast dies rechtfertigt.

Seien Sie vorsichtig mit dem Begriff „Scheduler“. Der interne Anforderungs-Scheduler eines Crawlers ist nicht zwangsläufig das System, das einen täglichen Job startet. Ersterer verwaltet ausstehende Anforderungen innerhalb eines Durchlaufs; letzterer steuert, wann ein neuer Durchlauf beginnt. Eine Verwechslung dieser Konzepte kann dazu führen, dass eine Warteschlange den Crawl von gestern fortsetzt, obwohl Sie eine neue tägliche Erfassung beabsichtigt haben.

Wenn Sie einen gehosteten Workflow-Runner verwenden, überprüfen Sie dessen Zeitgarantien. In der Dokumentation zu geplanten Workflows von GitHub wird darauf hingewiesen, dass geplante Ereignisse unter Last verzögert werden können und einige in der Warteschlange stehende Jobs verworfen werden können. Ein praktischer geplanter Auslöser ist daher kein Garant für einen exakten Beobachtungszeitpunkt.

Entwerfen Sie eine Überlappungsrichtlinie: Überspringen, in die Warteschlange stellen oder gleichzeitige Ausführungen unter separaten Identitäten zulassen. Lassen Sie nicht zu, dass zwei Ausführungen versehentlich dasselbe Checkpoint-Verzeichnis aktualisieren. Bei einer Quelle, deren Verarbeitung länger dauert als das vorgesehene Intervall, sollten Sie den Umfang reduzieren oder die Anforderungen an die Aktualität anpassen, bevor Sie blindlings überlappende Jobs hinzufügen.

Für das Erfassungs-Framework selbst bietet der Scrapy-Leitfaden einen nützlichen Ausgangspunkt für die Implementierung. Ihr Ausführungsvertrag sollte klar bleiben, unabhängig davon, welches Framework ihn ausführt.

Begrenzte Datenabfrage, Paginierung und Wiederholungsversuche

Jeder automatisierte Web-Scraping-Job benötigt eine endliche Stoppregel. Definieren Sie zulässige Hosts, Pfadmuster, gegebenenfalls die maximale Durchsuchungstiefe, die Beendigung der Paginierung, Zeitüberschreitungen bei Anfragen und eine Ausführungsfrist. Ein Crawler, der jedem verfügbaren Link folgt, kann den beabsichtigten Datensatz verlassen, ohne auf einen technischen Fehler zu stoßen.

Wählen Sie die Abrufmethode aus den erforderlichen Feldern aus. Für server-gerenderte Inhalte ist möglicherweise nur ein HTTP-Client erforderlich. Skript-gerenderte Felder erfordern unter Umständen die Ausführung im Browser. Eine dokumentierte Quell-API kann einen stabileren Weg bieten, wenn ihre Bedingungen und die Datenabdeckung passen. Unser Python-HTTP-Client-Vergleich hilft dabei, den leichtgewichtigen Weg zu bewerten, bevor Browser-Infrastruktur eingeführt wird.

Klassifizieren Sie Fehler, bevor Sie einen erneuten Versuch unternehmen. Ein vorübergehender Netzwerkausfall unterscheidet sich von ungültigen Anmeldedaten oder einem Parser, der nicht mehr zur Seite passt. Ein erneuter Versuch für alle drei Fälle in derselben Schleife verschwendet Kapazitäten und verschleiert den Fehler, der menschliches Eingreifen erfordert.

Der „Retry-After“-Header kann eine Wartezeit in Sekunden oder als HTTP-Datum angeben. Befolgen Sie, sofern zutreffend, die Anweisungen des Servers und Ihre eigenen Anforderungsrichtlinien. Legen Sie ein begrenztes Versuchsbudget und eine Aufgabenfrist fest, damit aus einem kooperativen Warten keine unbegrenzt laufende Aufgabe wird.

Ergebnis

Typische nächste Maßnahme

Beibehalten

Vorübergehender Verbindungsausfall

Begrenzte verspätete Wiederholung

Anzahl der Versuche und Fehlerkategorie

Ratenbegrenzte Antwort

Verzögerung berücksichtigen und Druck verringern

Antwortstatus und nächster möglicher Zeitpunkt

Authentifizierung abgelehnt

Abhängige Arbeit anhalten und Sitzung überprüfen

Redigiertes Ergebnis der Identitätsprüfung

Erwartete Seite fehlt

Antwort vor der Analyse klassifizieren

Endgültige URL und Nachweis des Seitentyps

Parser-Diskrepanz

In Quarantäne verschieben und untersuchen

Parser-Version und zulässige Fixtures

Begrenzen Sie die Parallelität sowohl pro Quelle als auch global. Ein langsamer Host sollte nicht alle verfügbaren Worker erhalten, nur weil andere Warteschlangen leer sind. Scrapy AutoThrottle passt Verzögerungen anhand von latenzbezogenen Rückmeldungen an, ist jedoch weder ein Berechtigungsmechanismus noch eine Garantie dafür, dass Ihre gewählte Anforderungsrichtlinie angemessen ist.

Bei der Paginierung sollten Sie protokollieren, warum die Erkennung abgebrochen wurde. Eine explizite letzte Seite, ein wiederholter Cursor, ein leeres Ergebnis und eine fehlgeschlagene Anfrage haben unterschiedliche Bedeutungen. Behandeln Sie einen wiederholten Cursor als möglichen Fehler, anstatt einen kleineren Datensatz stillschweigend als vollständig zu akzeptieren.

Validieren Sie Datensätze, bevor sie in das Ziel gelangen

Ein erfolgreicher Abruf beweist, dass eine Antwort eingegangen ist. Er beweist jedoch nicht, dass Ihr extrahierter Preis zum richtigen Produkt gehört oder dass die Antwort überhaupt Produkte enthält. Führen Sie die Validierung zwischen dem Parsen und der Übergabe durch, mit Prüfungen, die dem Datensatz angemessen sind.

Beginnen Sie mit der Struktur: Pflichtfelder, erwartete Datentypen, stabile Identifikatoren und zulässige Formate. Prüfen Sie anschließend die Bedeutung: Die Währung muss zum Betrag passen, ein Datum muss richtig interpretiert werden, ein Eintrag muss der ausgewählten Variante zugeordnet sein und eine Meldung „nicht verfügbar“ darf nicht in eine numerische Null umgewandelt werden.

Die Item-Pipeline von Scrapy bietet einen dokumentierten Ort für die Verarbeitung und Validierung von gescrapten Items. Das architektonische Prinzip geht über ein einzelnes Framework hinaus: Die Validierung sollte eine explizite Phase sein, deren Ergebnisse Sie zählen und überprüfen können.

Bewahren Sie abgelehnte Datensätze in einem kontrollierten Überprüfungsablauf auf, sofern die Aufbewahrungsregeln dies zulassen. Fügen Sie einen Grundcode und ausreichende Quellnachweise für die Nachverfolgung hinzu. Das stillschweigende Löschen von Fehlern lässt die gelieferte Datei übersichtlicher erscheinen, verbirgt jedoch eine Veränderung der Erfassungsreichweite. Die Anzahl der Ablehnungen gehört in den Ausführungsbericht, auch wenn abgelehnte Werte nicht in den Datensatz des Verbrauchers gehören.

Einige Prüfungen erstrecken sich über den gesamten Stapel. Ein plötzlicher Rückgang der eindeutigen Produktkennungen kann auf fehlende Paginierung hindeuten. Doppelte Kennungen können Fehler bei der Behandlung von Varianten offenbaren. Eine Verschiebung der Preisverteilung könnte auf eine Werbeaktion oder einen Fehler im Parser hindeuten. Diese Signale sollten eine Untersuchung auslösen; sie sind keine ausreichenden Gründe, um ungewöhnliche Werte automatisch zu löschen.

Verwenden Sie geprüfte Testfälle für repräsentative Seitentypen, einschließlich Fehlerseiten. Eine Anmeldeseite, eine Einwilligungsabfrage, ein entferntes Angebot und eine leere Kategorie sind wertvolle Testdaten. Sie bringen dem Parser und dem Antwortklassifikator bei, was nicht als gewöhnliche Datensätze behandelt werden darf.

Ersetzen Sie einen Datenvertrag nicht durch das Konfidenzniveau der KI. Wenn ein Modell dabei hilft, Felder zu extrahieren oder zu klassifizieren, vergleichen Sie seine Ausgaben mit geprüften Beispielen und bewahren Sie die Modell- oder Prompt-Version auf. Gültiges JSON kann dennoch eine falsche Zuordnung oder einen geschätzten Wert enthalten. Halten Sie unsichere Ausgaben von direkt beobachteten Feldern unterscheidbar.

Akzeptanzprüfungen sollten auch an der Verbrauchergrenze durchgeführt werden. Ein Zielsystem kann Zeichenfolgen abschneiden, Bezeichner als Zahlen interpretieren oder fehlende Werte unerwartet umwandeln. Überprüfen Sie den gesamten Durchlauf über den tatsächlichen Export- und Importpfad, bevor Sie das Schema als stabil erklären.

Entwerfen Sie Kontrollpunkte und Wiederholungen als unterschiedliche Vorgänge

Die Wiederherstellung beginnt mit einer Frage: Setzen Sie einen unterbrochenen Beobachtungslauf fort, liefern Sie einen bestehenden Batch erneut aus oder erfassen Sie eine neue Beobachtung? Diese Operationen können zwar dieselben URLs betreffen, sollten jedoch nicht dieselbe Identität oder dieselben Nebenwirkungen aufweisen.

Die Dokumentation zur Job-Persistenz von Scrapy beschreibt den gespeicherten Crawling-Zustand durch JOBDIR und warnt davor, ein Verzeichnis für separate Jobs gemeinsam zu nutzen. Setzen Sie den Job nach einem ordnungsgemäßen Stopp fort; ein abruptes Herunterfahren kann den Jobstatus beschädigen. Anfragen, die nicht serialisiert werden können, verbleiben im Speicher und gehen bei einer Unterbrechung verloren. Die aktuelle Dokumentation schreibt außerdem vor, dass die Fortsetzung mit derselben Scrapy-Version erfolgen muss. Testen Sie diese Bedingungen, bevor Sie sich auf einen Checkpoint für vollständige Abdeckung verlassen. Eine persistierte Warteschlange ist nützlich, stellt jedoch keinen universellen transaktionalen Checkpoint für Ihre gesamte Anwendung dar.

Halten Sie den Crawling-Fortschritt vom Übermittlungsfortschritt getrennt. Eine Seite kann bereits abgerufen und geparst worden sein, während ihre Ausgabe das Ziel noch nicht erreicht hat. Umgekehrt kann es sein, dass das Ziel einen Stapel akzeptiert hat, auch wenn Ihr Worker die Bestätigung verloren hat. Ein Neustart des gesamten Vorgangs ohne Übermittlungs-ID kann zu doppelten Zeilen führen.

Definieren Sie einen Datensatzschlüssel entsprechend dem Datensatz. Für die Synchronisierung des aktuellen Zustands kann eine Produkt-ID der Quelle zusammen mit dem relevanten Geltungsbereich die zu aktualisierende Entität identifizieren. Für den Beobachtungsverlauf benötigt der Schlüssel zusätzlich die Beobachtungs- oder Lauf-ID. Die ausschließliche Verwendung der Produkt-ID würde den Verlauf überschreiben, den Sie eigentlich beibehalten wollten.

Verwenden Sie eine stabile Lieferkennung für Wiederholungsversuche desselben akzeptierten Batches. Das Ziel oder Ihre Liefer-Ebene kann diese Kennung erkennen und vermeiden, sie zweimal anzuwenden. Gehen Sie nicht davon aus, dass ein „Exactly-Once“-Verhalten vorliegt, nur weil eine Komponente über eine Duplikatsfilterung verfügt. Die Garantie hängt vom gesamten Schreib- und Bestätigungsweg ab.

Vorgang

Die Beobachtungsidentität wiederverwenden?

Quelle erneut abrufen?

Unterbrochene Erfassung fortsetzen

Ja, mit den tatsächlichen Beobachtungszeitpunkten

Nur ausstehende oder explizit erneut versuchte Aufgaben

Zustellung der akzeptierten Ausgabe erneut versuchen

Ja

Nein, den akzeptierten Stapel wiederverwenden

Eine neue geplante Beobachtung starten

Nein

Ja, innerhalb des neuen Geltungsbereichs

Einen Parser-Fehler korrigieren

Korrekturhistorie beibehalten

Hängt von den aufbewahrten Nachweisen und den Richtlinien ab

Stellen Sie sicher, dass Wiederherstellungsentscheidungen nachvollziehbar sind. Wenn ein fortgesetzter Lauf eine lange Unterbrechung überspannt, kennzeichnen Sie das Beobachtungsfenster ehrlich. Seine Aufzeichnungen beschreiben möglicherweise nicht mehr einen genauen Momentaufnahmestand. Die angemessene Reaktion könnte ein neuer Lauf sein, anstatt so zu tun, als wäre die fortgesetzte Ausgabe zu einem einzigen Zeitpunkt erfasst worden.

Behandeln Sie die Speicherung von Checkpoints als Betriebszustand mit Backups und Zugriffskontrollen, die dem Inhalt angemessen sind. Speichern Sie keine sensiblen Sitzungen in einem uneingeschränkt zugänglichen gemeinsamen Verzeichnis. Ein Wiederherstellungsmechanismus sollte den Auftrag wiederherstellen, nicht den Zugriff auf die von ihm genutzten Konten erweitern.

Liefern Sie einen Batch mit einem Manifest und einer Empfangsbestätigung

Eine Exportdatei ist kein Nachweis dafür, dass der Empfänger sie verarbeitet hat. Verfolgen Sie die Übermittlung separat, einschließlich der Ausgabekennung, der Datensatzanzahl, der Schemaversion sowie des Bestätigungs- oder Fehlerstatus. So kann ein Operator die Übermittlung wiederholen, ohne raten zu müssen, ob die Daten erneut erfasst werden müssen.

Scrapy-Feed-Exporte dokumentieren unterstützte Ausgabeformate und Speicherkonfigurationen. Wählen Sie das Format entsprechend den Anforderungen des Verbrauchers und nicht allein aus Bequemlichkeitsgründen. Flaches CSV eignet sich für viele tabellarische Workflows, während verschachtelte Daten oft eine explizite Abflachungsrichtlinie oder ein Format erfordern, das die Struktur beibehält.

Fügen Sie dem Batch ein Manifest bei. Darin sollten das Beobachtungsfenster, die Quellenabdeckung, die Anzahl der akzeptierten und abgelehnten Datensätze sowie die Angabe, ob es sich um einen Teilablauf handelte, erläutert werden. Wenn eine Quelle fehlgeschlagen ist, sollten nachgelagerte Nutzer dies erfahren, bevor sie den Datensatz als vollständigen Vergleich interpretieren.

Vermeiden Sie bei der Dateiübermittlung, eine teilweise geschriebene Datei unter dem endgültigen Namen bereitzustellen. Nutzen Sie die vom Speichersystem unterstützten Mechanismen für Zwischenablage und Fertigstellung und testen Sie deren tatsächliches Verhalten. Definieren Sie bei der API-Übermittlung die Identität für Wiederholungsversuche und die Behandlung von Teilfehlern, bevor Sie einen großen Batch senden. Eine gemischte Antwort sollte Sie nicht dazu zwingen, zu erraten, welche Zeilen akzeptiert wurden.

Machen Sie die Fertigstellung zu einem Zustandsübergang mit Nachweis. „Übermittelt“ sollte bedeuten, dass die erforderliche Zielaktion gemäß Ihrem Vertrag erfolgreich war, und nicht lediglich, dass die Exportfunktion zurückgekehrt ist. Wenn Verbraucher Dateien asynchron abrufen, behalten Sie diese Unterscheidung im Auftragsstatus bei.

Bewahren Sie ein wiedergabebares, akzeptiertes Artefakt auf, sofern die Richtlinien dies zulassen. Dies ist wertvoll für die Wiederherstellung, die Fehlersuche und die erneute Verarbeitung in ein neues Zielschema. Beschränken Sie die Aufbewahrungsdauer auf das, was der Workflow benötigt, und unterscheiden Sie Quellnachweise von normalisierten Exporten, damit beide einen angemessenen Lebenszyklus haben.

Überwachen Sie die Aktualität und testen Sie Fehlerpfade vor der Skalierung

Die wichtigste Frage im Dashboard lautet oft: „Wie alt sind die neuesten verwertbaren Daten?“ Eine hohe Anzahl aktiver Worker sagt wenig aus, wenn jeder Worker abgelehnte Zeilen produziert. Verfolgen Sie die Aktualität anhand erfolgreicher Beobachtungen oder der Zustellung gemäß den Anforderungen der Verbraucher, nicht anhand des letzten Prozessstarts.

Überwachen Sie jede Phase mit separaten Zählwerten. Angeforderte Seiten, abgerufene Antworten, akzeptierte Zeilen, abgelehnte Zeilen und bestätigte Übermittlungen sollten nicht zu einem einzigen Erfolgsprozentsatz zusammengefasst werden. Veränderungen zwischen diesen Zählwerten zeigen Ihnen, wo Sie nachforschen müssen.

Fügen Sie eine Warnmeldung für fehlende Durchläufe hinzu. Ein Job, der nie startet, kann keine eigene Fehlermeldung ausgeben. Eine unabhängige Überprüfung sollte erkennen, wenn erwartete Daten nicht innerhalb der zulässigen Frist eingetroffen sind. Erfassen Sie Verzögerungen im Zeitplan getrennt von langsamen Crawling-Vorgängen und Lieferrückständen.

Testen Sie vor der Erweiterung der Quelldaten bewusst Unterbrechungen, doppelte Auslöser, abgelaufene Sitzungen, geänderte Selektoren, fehlende Pflichtfelder und einen Ausfall des Zielsystems. Stellen Sie sicher, dass jedes Ergebnis eine begrenzte Reaktion auslöst und genügend Informationen für die Wiederherstellung hinterlässt. Eine Demonstration des „Happy Path“ belegt noch keine Betriebssicherheit.

Setzen Sie Änderungen am Parser zunächst auf Testdaten an, dann auf eine kleine, kontrollierte Live-Stichprobe innerhalb des genehmigten Quellumfangs. Vergleichen Sie die Bedeutung der Felder und die Abdeckung, nicht nur die Zeilenanzahl. Ein neuer Parser, der mehr Zeilen extrahiert, folgt möglicherweise einem unbeabsichtigten Empfehlungs-Widget.

Halten Sie Rollback und Datenkorrektur getrennt. Ein Rollback des Codes verhindert weitere fehlerhafte Ausgaben; er repariert jedoch keine bereits gelieferten Datensätze. Ihr Vorfallverfahren sollte betroffene Lauf-IDs identifizieren, Verbraucher bei Bedarf benachrichtigen und eine nachvollziehbare Korrektur vornehmen, anstatt den Verlauf stillschweigend umzuschreiben.

Skalieren Sie die Stufe, die den Workflow tatsächlich einschränkt. Wenn die Validierung die meisten Zeilen ablehnt, verursachen mehr Abruf-Worker nur mehr Überprüfungsaufwand. Wenn die Auslieferung der Engpass ist, kann eine Erhöhung der Browser-Parallelität den Speicherbedarf verschärfen, ohne die nutzbare Aktualität zu verbessern.

Wichtige Erkenntnisse

  • Weisen Sie jedem automatisierten Web-Scraping-Lauf einen klaren Umfang, eine eindeutige Identität, eine Abnahmerichtlinie und einen Verantwortlichen zu.
  • Trennen Sie Planung, Erfassung, Validierung und Bereitstellung voneinander, damit jeder Schritt unabhängig ausfallen und wiederhergestellt werden kann.
  • Begrenzen Sie Wiederholungsversuche und unterscheiden Sie vorübergehende Übertragungsfehler von Authentifizierungs- oder Parserfehlern.
  • Halten Sie neue Beobachtungen, wieder aufgenommene Aufgaben und Wiederholungsversuche bei der Bereitstellung semantisch voneinander getrennt.
  • Überwachen Sie die Aktualität der verwertbaren Daten und testen Sie Fehlerabläufe, bevor Sie den Umfang erhöhen.

FAQ

Sollte jedes erfasste Feld dieselbe Aufbewahrungsfrist haben?

Nein. Rohdaten aus Quellen, normalisierte Datensätze, Betriebsprotokolle und der Authentifizierungsstatus dienen unterschiedlichen Zwecken und können unterschiedliche Lebenszyklen erfordern. Legen Sie die Aufbewahrungsdauer nach Zweck und Sensibilität fest und überprüfen Sie anschließend die Löschung an jedem Speicherort. Eine Richtlinie für kurze Protokollaufbewahrungsfristen entfernt ältere Exporte oder Backups nicht automatisch.

Kann dieselbe Pipeline mehrere Kundendatensätze unterstützen?

Ja, sofern Quellbereich, Zugriffsrechte, Status und Ziele bewusst voneinander isoliert sind. Verwenden Sie einen expliziten Mandantenkontext und validieren Sie diesen an den Grenzen. Die Wiederverwendung von Parser-Code ist nicht mit der gemeinsamen Nutzung von Anmeldedaten oder veränderbare Sitzungen gleichzusetzen. Stellen Sie sicher, dass der Wiederholungsversuch oder eine Konfigurationsänderung eines Kunden nicht dazu führt, dass die Daten eines anderen Kunden an das falsche Ziel weitergeleitet werden.

Wie sollten die Erfassungskosten geschätzt werden?

Messen Sie ein repräsentatives Pilotprojekt, einschließlich fehlgeschlagener Versuche, Browserausführung, Validierungsarbeit, Speicherung und Bereitstellung. Teilen Sie die relevante Gesamtsumme durch die nutzbare Ausgabe und nicht nur durch die angeforderten Seiten. Betrachten Sie diesen Wert als eine auf die Arbeitslast bezogene Beobachtung und nicht als universelle Kosten pro Website. Überprüfen Sie ihn erneut, wenn sich die Anforderungen an Quelllayouts, Abdeckung oder Aktualität ändern.

Fazit

Automatisiertes Web-Scraping wird zuverlässig, wenn der Job erklärt, was passiert ist, und nicht nur, dass er abgeschlossen wurde. Eine Lauf-ID, explizite Akzeptanzprüfungen, begrenzte Wiederholungsversuche und eine bestätigte Zustellung machen Fehler behebbar und Ergebnisse interpretierbar.

Beginnen Sie mit einem kleinen Quelldatensatz und einem vollständigen Lebenszyklus. Unterbrechen Sie den Auftrag, wiederholen Sie die Auslieferung und stellen Sie sicher, dass am Zielort keine unbeabsichtigten Duplikate ankommen. Vergewissern Sie sich, dass ein versäumter Zeitplan eine Warnmeldung auslöst und dass eine erfolgreiche Antwort mit der falschen Seite niemals als normale Daten behandelt wird. Diese Tests schaffen mehr vertrauenswürdige Sicherheit als eine beeindruckende Anzahl von Anfragen.

Wenn der Abruf von Seiten die größte Herausforderung darstellt, prüfen Sie die Scraper-API von WebScrapingAPI für diese Komponente, während Sie Ihre Validierungs- und Übermittlungsvereinbarungen beibehalten. Die Verlagerung des Abrufs in einen Dienst beseitigt nicht die Notwendigkeit, die Abdeckung oder Aktualität zu definieren. Das Ziel ist eine Pipeline, deren Ausgabe ein anderer Entwickler überprüfen, innerhalb der angegebenen Grenzen vertrauen und wiederherstellen kann, ohne alles blind erneut ausführen zu müssen.

Über den Autor

Andrei Ogiolan, Full-Stack-Entwickler @ WebScrapingAPI

Andrei Ogiolan

Full-Stack-Entwickler

Andrei Ogiolan ist Full-Stack-Entwickler bei WebScrapingAPI, wo er in verschiedenen Bereichen des Produkts mitwirkt und dabei hilft, zuverlässige Tools und Funktionen für die Plattform zu entwickeln.

Web-Scraping mit AWS Lambda: Leitfaden für Python und Java 2026
Anleitungen

Web-Scraping mit AWS Lambda: Leitfaden für Python und Java 2026

TL;DR: Kurz gesagt: Web-Scraping mit AWS Lambda funktioniert am besten, wenn jeder Aufruf kurz, begrenzt und unabhängig wiederholbar ist. Beginnen Sie mit direktem HTTP, AWS SAM und S3 und fügen Sie erst dann SQS, Container, Browser-Rendering, Proxys oder eine verwaltete Abrufebene hinzu, wenn sich im Rahmen der Arbeitslast herausstellt, dass diese erforderlich sind.

Suciu Dan26 min read
Artikel lesen
So verwenden Sie GoSpider: Crawlen, URLs bereinigen und Daten extrahieren
Anleitungen

So verwenden Sie GoSpider: Crawlen, URLs bereinigen und Daten extrahieren

TL;DR: GoSpider ist ein Befehlszeilen-Crawler zum Auffinden von URLs, kein vollständiger Scraper für strukturierte Daten. Diese Anleitung zur Verwendung von GoSpider zeigt einen begrenzten Crawl, die saubere Verarbeitung der Ausgabe, die Übergabe von Colly an CSV sowie einen Diagnosepfad für 403-Antworten oder Seiten, die eine JavaScript-Darstellung erfordern.

Suciu Dan20 min read
Artikel lesen
Wie man Redfin scrappt: Python-Leitfaden für Immobiliendaten
Anleitungen

Wie man Redfin scrappt: Python-Leitfaden für Immobiliendaten

TL;DR: Redfin stellt versteckte API-Endpunkte zur Verfügung, die strukturiertes JSON für Immobilienangebote zurückgeben, wodurch das fragile HTML-Parsing vollständig übersprungen werden kann. Diese Anleitung führt Sie durch den Aufbau eines Python-Scrapers, der Miet- und Verkaufsdaten extrahiert, nach Standort sucht, neue Angebote über XML-Sitemaps überwacht und saubere Ergebnisse in CSV oder JSON exportiert.

Suciu Dan11 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.