
Zum Inhalt springen
Zurück zum Blog

Screen-Scraping von Websites: Ein praktischer DOM-Workflow

Raluca PenciucZuletzt aktualisiert am 12 min read
Screen-Scraping von Websites: Ein praktischer DOM-Workflow
TL;DR: Beim Screen-Scraping von Websites werden Informationen aus der Darstellungsschicht einer Website extrahiert. Bei gewöhnlichen Webseiten sollten Sie zunächst das gerenderte DOM auslesen, bevor Sie Screenshots und OCR in Betracht ziehen; anschließend müssen Sie die Datensätze validieren und nachweisen, dass die Erfassung einen definierten Endpunkt erreicht hat.

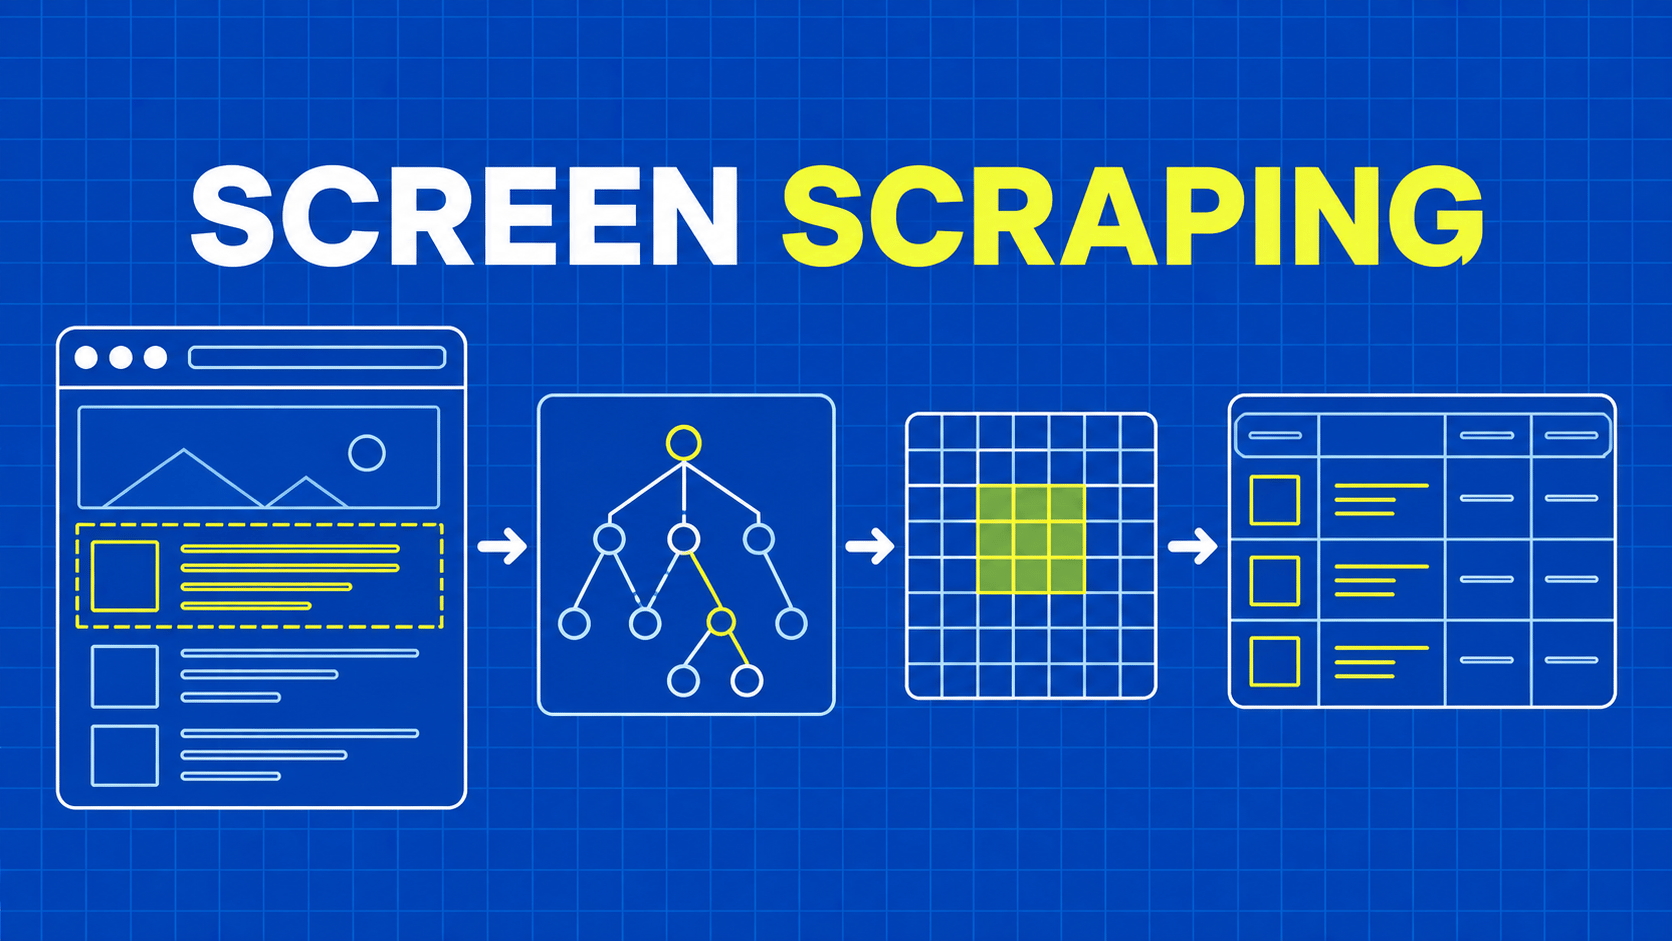
Eine Produktkarte zeigt einen Namen und einen Preis an, doch der von Ihrem Skript heruntergeladene HTML-Code enthält lediglich einen leeren Container. Beim Screen-Scraping von Websites wird diese Lücke geschlossen, indem Daten von der Seite erfasst werden, nachdem der Browser die für die Darstellung erforderlichen Schritte ausgeführt hat. Die praktische Herausforderung besteht darin, zu entscheiden, welche Darstellung die benötigten Informationen enthält und wann diese Darstellung bereitsteht.

Der Begriff kann auch das Auslesen von Pixeln aus Screenshots beschreiben. Dabei handelt es sich um unterschiedliche technische Probleme. Ein Browser kann strukturierte Elemente, Attribute und Text bereitstellen, ohne Bilder zu erkennen. OCR geht von Pixeln aus und schätzt, welche Zeichen sie enthalten, wobei viele der Beziehungen verloren gehen, die HTML bereits bereitstellt.

Dieser Leitfaden baut eine kleine, kontrollierte Übung zur Datenextraktion aus dem Browser auf und überträgt die darin enthaltenen Überlegungen anschließend auf reale Datenerfassungsaufgaben. Sie werden einen Datensatz definieren, Lokalisatoren auswählen, auf einen aussagekräftigen Zustand warten, unvollständige Ergebnisse identifizieren und Nachweise sichern, wenn die Extraktion fehlschlägt. Das Beispiel verwendet eine im Browser erstellte Seite, sodass es nicht von einer Website eines Drittanbieters abhängig ist und keinen Datenverkehr zu einer solchen erzeugt. Wenden Sie denselben Arbeitsablauf nur auf Seiten und Daten an, zu deren Erfassung Sie berechtigt sind.
Wählen Sie die richtige Ebene für das Screen-Scraping von Websites

Beginnen Sie mit einem einzelnen erforderlichen Feld, beispielsweise dem aktuell angezeigten Preis. Prüfen Sie, wo dieses Feld vorhanden ist, bevor Sie ein Tool auswählen. Es könnte im ursprünglichen HTML enthalten sein, nach Ausführung von JavaScript in das DOM eingefügt, auf eine Leinwand gezeichnet oder in einem autorisierten Export enthalten sein. Jede dieser Möglichkeiten beeinflusst die einfachste und zuverlässigste Erfassungsmethode.

Verfügbare Darstellungsformen

Sinnvoller Ansatz

Wichtigste zu prüfende Einschränkung

Dokumentierte API oder Export

Nutzen Sie die unterstützte strukturierte Schnittstelle

Abdeckung, Zugriffsbereich und Aktualisierungszeitpunkt

HTML der ersten Antwort

Das heruntergeladene Dokument analysieren

Daten werden möglicherweise erst nach dem Rendern angezeigt

Gerendertes DOM

Verwenden Sie einen Browser und bereichsbezogene Locators

Bereitschaft und sich ändernde Darstellungsstruktur

Canvas- oder Bildtext

Verwenden Sie zugelassene Bildauszugs- und OCR-Verfahren

Erkennungsfehler und verlorene Beziehungen

Das Screen-Scraping von Websites erfordert keinen Screenshot. Befindet sich ein Preis als Textknoten innerhalb einer Produktkarte, bleibt durch das Extrahieren dieses Knotens die Beziehung zur Karte erhalten. Das Ausschneiden desselben Preises aus einem Bild verursacht zusätzlichen Aufwand: Auswahl eines Ausschnitts, Erkennung von Zeichen, Zuordnung des Ergebnisses zum richtigen Produkt und Erkennung unklarer Ergebnisse.

Ein HTTP-Parser ist nach wie vor ein guter Ausgangspunkt, wenn das Ausgangsdokument die erforderlichen Felder enthält. Unser Leitfaden zu Python-HTTP-Clients erläutert die Anfrageebene, die dem Parsing vorausgeht. Ein Browser ist dann sinnvoll, wenn die Datenerfassung von der Ausführung der Seite oder von zulässigen Interaktionen abhängt, wie beispielsweise der Auswahl eines Reiters.

Betrachten Sie die Wahl als Experiment. Rufen Sie ein autorisiertes Beispiel mit der einfachsten Methode ab, vergleichen Sie dessen Felder mit der sichtbaren Seite und dokumentieren Sie den Unterschied. Setzen Sie Browser-Automatisierung nicht allein deshalb ein, weil eine Website irgendwo JavaScript verwendet. Umgekehrt beweist eine erfolgreiche HTTP-Antwort nicht, dass die Antwort die gewünschten Daten enthält.

Behalten Sie die Quelldarstellung in den Ausgabemetadaten bei. Ein aus gerendertem Text gewonnener Datensatz und ein aus einem Bild abgeleiteter Datensatz können unterschiedliche Überprüfungsanforderungen haben, selbst wenn ihre Endwerte identisch aussehen.

Definieren Sie Datensätze, bevor Sie Browser-Aktionen schreiben

Halten Sie fest, was eine Zeile bedeutet. Bei einer Katalogbeobachtung könnte ein nützlicher Datensatz eine Quellprodukt-ID, den angezeigten Namen, den Rohpreis-Text, die Währung, die Seiten-URL, den Beobachtungszeitpunkt und die Extraktionsversion enthalten. Legen Sie fest, welche Felder obligatorisch sind und welche legitimerweise fehlen dürfen, bevor Sie den Browser ausführen.

Das Screen-Scraping von Websites wird anfällig, wenn Selektoren das Schema stillschweigend festlegen. Ein fehlender Preis-Knoten sollte nicht automatisch zu Null werden. Ein mit „ab“ gekennzeichneter Preis sollte nicht zu einem exakten Preis werden, ohne dass dieser Qualifizierer beibehalten wird. Eine Produktkarte, die zweimal in separaten Karussells erscheint, sollte nicht automatisch zwei verschiedene Produkte erzeugen.

Behalten Sie den Rohtext neben den normalisierten Werten bei, wenn die Unterscheidung von Bedeutung ist. Speichern Sie beispielsweise „€1.249,00“ als beobachteten Text und leiten Sie den numerischen Betrag erst anhand einer bekannten Ländereinstellungsregel ab. Das Erraten von Interpunktionskonventionen kann einen gültigen Preis in einen Wert verwandeln, der um Größenordnungen daneben liegt. Die Rohbeobachtung ermöglicht es dir, die Umwandlung zu korrigieren, ohne die Seite erneut aufrufen zu müssen.

Wählen Sie eine Datensatz-ID unabhängig von der visuellen Reihenfolge. Eine Quell-ID ist vorzuziehen, wenn die Seite eine solche in einer zulässigen Darstellung bereitstellt. Eine kanonische Produkt-URL kann verwendet werden, wenn deren Identitätsregeln bekannt sind. Die dritte Karte auf der Seite stellt keine stabile Identität dar, da Sortierungen, Empfehlungen und Bestandsänderungen ihre Position verschieben können.

Definieren Sie außerdem den Erfassungskontext. Viewport, Sprache, Konto und ausgewählte Filter können das angezeigte Ergebnis beeinflussen. Wenn ein autorisiertes Konto beteiligt ist, verwalten Sie HTTP-Cookies und die Sitzungseigentümerschaft explizit. Teilen Sie eine Sitzung nicht zwischen nicht miteinander in Zusammenhang stehenden Kundenaufträgen, nur weil es bereits funktioniert.

Eine nützliche Akzeptanzregel liest sich wie ein Test: Jede akzeptierte Karte verfügt über eine nicht leere ID und einen Namen, der Preistext wird wörtlich beibehalten, doppelte IDs werden klassifiziert, und der Durchlauf protokolliert, ob er abgeschlossen wurde. Dies bietet Websites für Screen-Scraping eine beobachtbare Erfolgskondition, die über „das Skript wurde ohne Fehler beendet“ hinausgeht.

Extrahieren einer gerenderten Fixture mit Playwright

Diese Übung erstellt nach einer kurzen asynchronen Verzögerung zwei fiktive Produkte, markiert den Katalog als bereit und extrahiert strukturierte Datensätze. Installiere Playwright in einem temporären Node.js-Projekt, installiere den zugehörigen Chromium-Browser und speichere das JavaScript als ES-Modul, beispielsweise collect.mjs. Das Beispiel enthält keine API-Anfrage, keine Anmeldedaten und kein externes Ziel.

import assert from 'node:assert/strict';
import { chromium } from 'playwright';

const browser = await chromium.launch();
try {
  const page = await browser.newPage();
  await page.setContent(`
    <main id="catalog" data-ready="false"></main>
    <script>
      setTimeout(() => {
        document.querySelector('#catalog').innerHTML =
          '<article data-id="p1"><h2>Desk lamp</h2>' +
          '<span class="price">EUR 24.00</span></article>' +
          '<article data-id="p2"><h2>Notebook</h2>' +
          '<span class="price">EUR 6.50</span></article>';
        document.querySelector('#catalog').dataset.ready = 'true';
      }, 30);
    </script>
  `);
  await page.locator('#catalog[data-ready="true"]').waitFor();
  const records = await page.locator('#catalog article').evaluateAll(
    cards => cards.map(card => ({
      id: card.getAttribute('data-id'),
      name: card.querySelector('h2')?.textContent?.trim() ?? '',
      priceText: card.querySelector('.price')?.textContent?.trim() ?? ''
    }))
  );
  assert.deepEqual(records, [
    { id: 'p1', name: 'Desk lamp', priceText: 'EUR 24.00' },
    { id: 'p2', name: 'Notebook', priceText: 'EUR 6.50' }
  ]);
  console.log(JSON.stringify(records, null, 2));
} finally {
  await browser.close();
}

Der wichtige Teil ist die Bereitschaftsvereinbarung, nicht die Verzögerung, die zur Simulation von Arbeit verwendet wird. Der Collector wartet auf ein Attribut, das bedeutet, dass das Fixture das Einfügen seiner Datensätze abgeschlossen hat. Er geht niemals davon aus, dass 30 Millisekunden auch auf einer echten Website ausreichen würden. Die Assertion überprüft das gesamte Ergebnis, einschließlich der Anzahl der Datensätze und ihrer Verknüpfungen.

Die Page-API von Playwright dokumentiert das Festlegen von Seiteninhalten, während die Locator-API das Auswerten passender Elemente dokumentiert. Der Callback wird im Seitenkontext ausgeführt und gibt reine Daten zurück. Browser-DOM-Objekte selbst werden nicht zu dauerhaften Anwendungsdatensätzen.

Für das praktische Screen-Scraping von Websites ersetzen Sie das Fixture durch die Navigation zu einer genehmigten Seite und ersetzen Sie dessen Bereitschaftsmarker durch für diese Seite spezifische Nachweise. Behalten Sie den Validierungsschritt bei. Ein nützlicher erster Negativtest entfernt ein Preiselement und überprüft, ob Ihr Produktionsvalidator die unvollständige Zeile ablehnt oder in Quarantäne versetzt, anstatt sie als normales Ergebnis zu veröffentlichen.

Das Testbeispiel ist bewusst klein gehalten, um das Verständnis zu erleichtern. Es umfasst weder Zeitplanung noch persistenten Speicher noch einen allgemeinen Crawler. Unser umfassenderer Playwright-Leitfaden zum Scraping bietet zusätzlichen Kontext zum Browser-Workflow, wenn Sie bereit sind, über eine einzelne Datenextraktion hinauszugehen.

Machen Sie Bereitschaft und Selektoren explizit

Eine Seite kann das Laden ihres Dokuments abschließen, bevor ihre nützlichen Daten eintreffen. Sie kann auch Netzwerkverbindungen offen halten, nachdem die benötigten Daten bereits verfügbar sind. Beim Screen-Scraping von Websites ist eine an die Erfassungsaufgabe geknüpfte Bedingung erforderlich, wie beispielsweise eine Ergebnisüberschrift sowie ein Indikator für den abgeschlossenen Ladevorgang, anstatt einer willkürlichen Pause.

Für eine interaktive Aktion sollten Sie das Steuerelement anhand einer stabilen Eigenschaft lokalisieren und den Bereich auf die relevante Region beschränken. Eine Seite kann mehrere „Weiter“-Schaltflächen in Produktgalerien, Suchergebnissen und verwandten Inhalten enthalten. Das Anklicken des ersten übereinstimmenden Texts ist kein ausreichender Beweis dafür, dass der Collector in der beabsichtigten Liste vorangekommen ist. Playwright empfiehlt in seinen Leitlinien zur Lokalisierung benutzerseitige Attribute und explizite Vereinbarungen.

Unterscheiden Sie zwischen Aktionsbereitschaft und Vollständigkeit des Datensatzes. Dass eine Schaltfläche sichtbar und anklickbar ist, bedeutet nicht, dass alle Ergebniszeilen vorhanden sind. Überprüfen Sie nach dem Klick, ob sich der resultierende Seitenmarker oder Datensatz geändert hat und ob die seitenbezogene Abschlussbedingung erfüllt ist. Wenn Sie die Quellanwendung pflegen, lässt sich dieser Vertrag durch Hinzufügen eines stabilen Bereitschaftsattributs testbar machen.

Wählen Sie die Textextraktion bewusst aus. MDN beschreibt „innerText“ als die Darstellung berücksichtigend, während „textContent“ den Knotentext ohne Berücksichtigung dieser Darstellung ausliest. Keines von beiden ist eine automatische Definition des Geschäftsfeldes. Extrahieren Sie aus einem bestimmten Preiselement, anstatt eine gesamte Karte auszulesen und zu hoffen, die Beschriftungen später trennen zu können.

Beispielsweise kann eine Karte den aktuellen Preis, einen durchgestrichenen Preis, einen Liefertext und eine versteckte Barrierefreiheitsbezeichnung enthalten. Eine pauschale Textextraktion kann alle vier Elemente zusammenfassen. Entscheiden Sie, ob der Datensatz den angezeigten aktuellen Preis, den ursprünglichen Preis oder beides benötigt, und verwenden Sie dann separate benannte Felder und Lokalisatoren.

Wenn ein Selektor fehlschlägt, sollte dies deutlich sichtbar sein. Vermeiden Sie eine Fallback-Kette, die sich schrittweise ausweitet, bis sie nicht zum Thema gehörenden Text findet. Beim Screen-Scraping von Websites lässt sich ein klarer Fehler aufgrund eines fehlenden Feldes leichter beheben als ein erfolgreicher Durchlauf, der mit plausiblen, aber falschen Werten gefüllt ist.

Stellen Sie sicher, dass Paginierung und Bildlauf vollständig sind

Zehn korrekte Einträge von der ersten Seite stellen immer noch einen unvollständigen Datensatz dar, wenn die Aufgabe die gesamte Kategorie erfordert. Definieren Sie eine Stoppbedingung, bevor Sie eine Schleife einführen. Bei paginierten Seiten könnte dies ein dokumentierter Indikator für die letzte Seite oder ein deaktiviertes „Weiter“-Steuerelement sein. Bei einer anerkannten „Mehr laden“-Oberfläche könnte es sich um eine explizite Endmarkierung handeln.

Das Screen-Scraping von Websites mit unendlichem Scrollen erfordert besondere Sorgfalt, da einige Listen ihren Inhalt virtualisieren. Sie verwenden eine kleine Gruppe von DOM-Knoten wieder, während sich der Leser durch eine größere Sammlung bewegt. Das Zählen der derzeit im Dokument vorhandenen Elemente kann daher die Anzahl der erschienenen Datensätze unterschätzen, und bei einer einzigen abschließenden DOM-Momentaufnahme können frühere Datensätze übersehen werden.

Sammeln Sie jeden Stapel, sobald dessen Bereitschaftsbedingung erfüllt ist, und verwenden Sie die Quellidentität, um Beobachtungen zu deduplizieren. Verfolgen Sie die bereits akzeptierten IDs, die letzte Navigationsmarkierung und die Anzahl aufeinanderfolgender Versuche, bei denen keine neuen IDs erzeugt wurden. Behandeln Sie eine „Kein-Fortschritt“-Grenze als Schutzstopp mit dem Status „unvollständig“, es sei denn, die Quelle liefert auch eine zuverlässige Endbedingung.

Verwenden Sie begrenzte Arbeitsschritte, auch wenn die Schnittstelle endlos erscheint. Legen Sie eine maximale Seitenanzahl, eine maximale verstrichene Zeit und eine maximale Datensatzanzahl fest, die für den Auftrag angemessen sind. Zeichnen Sie auf, welche Grenze den Lauf beendet hat. „Nach dem konfigurierten Seitenbudget gestoppt“ und „die letzte Seite der Quelle erreicht“ haben für nachgelagerte Nutzer unterschiedliche Bedeutungen.

Speichern Sie Checkpoints, nachdem akzeptierte Daten dauerhaft gespeichert wurden. Wenn ein Prozess zwischen Erfassung und Speicherung abstürzt, kann die Wiederaufnahme ab einem zu früh gespeicherten Cursor dazu führen, dass Datensätze übersprungen werden. Das erneute Abspielen einer Seite ist sicherer, wenn Ihr Zielsystem anhand stabiler Identitäten und Beobachtungsrichtlinien dedupliziert.

Bei einem sich ändernden Katalog ist Vollständigkeit auch zeitlich begrenzt. Elemente können während des aktiven Laufs zwischen Seiten verschoben werden. Erfassen Sie das Erfassungsfenster und vermeiden Sie es, die Ausgabe als exakten Momentaufnahme zu bezeichnen, es sei denn, die Quelle bietet diese Garantie. Ein täglicher Beobachtungsauftrag kann nützlich sein, ohne den Anspruch zu erheben, einen momentanen Zustand zu beschreiben.

Diese Grenzen verwandeln das Screen-Scraping von Websites von einem Browser-Makro in einen Erfassungsprozess, dessen Grenzen erklärt und getestet werden können.

Verwenden Sie Screenshots und OCR nur, wenn Pixel eine Rolle spielen

Ein Screenshot ist ein nützlicher Beweis, wenn die visuelle Darstellung selbst Teil der Fragestellung ist. Er kann einen fehlenden Preis, ein unerwartetes Dialogfeld oder ein Layout zeigen, das nicht mehr der Extraktionsvereinbarung entspricht. Playwright unterstützt die Erfassung von Seiten und Elementen über seine Screenshot-Schnittstelle.

OCR ist eine separate Transformation, die auf dieses Bild angewendet wird. Ziehen Sie sie in Betracht, wenn autorisierte Informationen tatsächlich nur als Pixel verfügbar sind – wie beispielsweise in einem Canvas gezeichneter Text – und keine geeignete strukturierte Darstellung existiert. Verwenden Sie sie nicht, um Zugriffsprobleme zu lösen oder die Zugangsverweigerung einer Website zu umgehen. Halten Sie inne und klären Sie Berechtigungs- oder Zugriffsprobleme mit dem Eigentümer.

Das Screen-Scraping von Websites mittels OCR erfordert eine Richtlinie für Unsicherheiten. Ähnliche Zeichen, Dezimalzeichen, abgeschnittener Text und geringer Kontrast können die Ausgabe verfälschen. Eine Zeichenfolge, die einen einfachen numerischen Parser passiert, kann dennoch den falschen Preis darstellen. Bewahren Sie den relevanten Bildbereich, den erkannten Text, die Transformationsversion und alle verfügbaren Konfidenzsignale gemeinsam auf.

Überprüfen Sie Felder mit hoher Auswirkung anhand einer unabhängigen Einschränkung. Ein erkannter Währungsbetrag benötigt möglicherweise sowohl eine bekannte Währungsbezeichnung als auch ein sinnvolles Format. Eine Produktkennung könnte eine feste Länge oder eine Prüfsumme haben. Diese Prüfungen können einige Fehler erkennen, beweisen jedoch nicht, dass ein plausibles Ergebnis mit dem Quellbild übereinstimmt.

Bei Screenshots, die als Debugging-Artefakte verwendet werden, sollten Sie den Bildausschnitt auf den relevanten Bereich beschneiden und die Aufbewahrungsdauer begrenzen. Der autorisierte Zugriff auf eine Seite bedeutet nicht, dass jede sichtbare Kontodetailangabe in ein dauerhaftes Diagnosearchiv gehört. Halten Sie fest, warum das Bild aufgenommen wurde, beschränken Sie den Zugriff darauf und löschen Sie es, sobald es für die Untersuchung nicht mehr benötigt wird.

Die gleiche Sorgfalt gilt für HTML-Snapshots: Versteckte Felder und kontospezifische Inhalte können vorhanden sein, auch wenn der Screenshot harmlos aussieht. Speichern Sie nur die Mindestmenge an Beweismaterial, die zur Reproduktion des Extraktionsproblems erforderlich ist.

Wichtige Erkenntnisse

  • Prüfen Sie die Quelldarstellung, bevor Sie ein Tool auswählen. Ursprünglicher HTML-Code, gerendertes DOM und Bildpixel erfordern unterschiedliche Extraktions- und Validierungsstrategien.
  • Lassen Sie die Bereitschaft die benötigten Daten beschreiben, und validieren Sie den vollständig extrahierten Datensatz, anstatt nur zu prüfen, ob eine Browseraktion erfolgreich war.
  • Definieren Sie Identität, Ende der Paginierung, Zeitpunkt der Kontrollpunkte und Status bei unvollständigen Durchläufen, bevor Sie einen Collector über eine Seite hinaus skalieren.
  • Behalten Sie Rohdaten bei, wenn eine Normalisierung die Bedeutung verändern könnte. Verwenden Sie Screenshots selektiv und wenden Sie explizite Überprüfungsregeln auf OCR-Ergebnisse an.

FAQ

Können Browser-Erweiterungen ein nützliches Prototyping-Tool sein?

Ja. Eine Erweiterung kann dabei helfen, eine Seite zu untersuchen oder eine kleine Extraktionsidee zu testen, bevor Sie einen geplanten Collector erstellen. Bewerten Sie deren Datenzugriff und Exportverhalten, bevor Sie sie in einem authentifizierten Browser installieren. Ein erfolgreicher manueller Prototyp benötigt dennoch reproduzierbare Eingaben, Validierung und operative Zuständigkeit, bevor er zu einem zuverlässigen Produktionsauftrag wird.

Sollte extrahierter Text während der Erfassung übersetzt werden?

Behalten Sie in der Regel die Originalsprache im Rohdatensatz bei und übersetzen Sie in einem separaten Schritt. Eine Übersetzung verändert die Beobachtung und kann Vergleiche zwischen verschiedenen Durchläufen erschweren. Speichern Sie die Ausgangssprache, die übersetzte Ausgabe und die Transformationsversion separat, damit eine Korrektur der Übersetzung keinen erneuten Besuch der Quellseite erfordert.

Wie sollte ein Team einen bestehenden Collector übergeben?

Stellen Sie den Extraktionsvertrag, eine kleine genehmigte Testumgebung, die erwartete Ausgabe und Beispiele für klassifizierte Fehler bereit. Geben Sie an, wer Zugriff auf die Quelle hat und welche nachgelagerten Jobs das Ergebnis verarbeiten. Der nächste Betreuer sollte in der Lage sein, eine erfolgreiche Extraktion zu reproduzieren und einen unvollständigen Durchlauf zu erkennen, ohne auf den Browserverlauf des ursprünglichen Autors angewiesen zu sein.

Erstellen Sie einen Collector mit einem nachvollziehbaren Ergebnis

Der erste nützliche Meilenstein beim Screen-Scraping von Websites ist ein validierter Datensatz mit bekannter Herkunft. Beginnen Sie damit und fügen Sie erst dann Navigation, Persistenz und Zeitplanung hinzu, wenn deren Erfolgsbedingungen ebenso klar sind. Sie sollten erklären können, woher jedes Feld stammt, warum die Seite bereit war und was den Lauf zum Abbruch gebracht hat.

Testen Sie vor einer breiteren Einführung das Fehlen eines Feldes, eine sich wiederholende Seite und eine Quellenänderung, die keine neuen Datensätze erzeugt. Vergewissern Sie sich, dass diese Szenarien zu eindeutigen Klassifizierungen führen und nicht zu leeren Erfolgsberichten. Diese kleine Reihe von Fehlern zeigt oft, ob Ihr Workflow einen echten Datenvertrag enthält oder nur eine Abfolge von Browseraktionen ist.

Falls der Betrieb der Browser-Infrastruktur zu dem Faktor wird, der Ihren autorisierten Erfassungs-Workflow einschränkt, sollten Sie die Browser-API von WebScrapingAPI zur Steuerung gehosteter Browser in Betracht ziehen. Halten Sie Ihr Datensatzschema, Ihre Bereitschaftsregeln und Ihre Validierung unabhängig von der Wahl der Infrastruktur, damit diese auch bei Wachstum des Systems weiterhin überprüfbar bleiben.

Über den Autor

Raluca Penciuc, Full-Stack-Entwickler @ WebScrapingAPI

Raluca Penciuc

Full-Stack-Entwickler

Raluca Penciuc ist Full-Stack-Entwicklerin bei WebScrapingAPI. Sie entwickelt Scraper, verbessert Umgehungsstrategien und findet zuverlässige Wege, um die Erkennung auf Zielwebsites zu verringern.

Web-Scraping mit AWS Lambda: Leitfaden für Python und Java 2026
Anleitungen

Web-Scraping mit AWS Lambda: Leitfaden für Python und Java 2026

TL;DR: Kurz gesagt: Web-Scraping mit AWS Lambda funktioniert am besten, wenn jeder Aufruf kurz, begrenzt und unabhängig wiederholbar ist. Beginnen Sie mit direktem HTTP, AWS SAM und S3 und fügen Sie erst dann SQS, Container, Browser-Rendering, Proxys oder eine verwaltete Abrufebene hinzu, wenn sich im Rahmen der Arbeitslast herausstellt, dass diese erforderlich sind.

Suciu Dan26 min read
Artikel lesen
So verwenden Sie GoSpider: Crawlen, URLs bereinigen und Daten extrahieren
Anleitungen

So verwenden Sie GoSpider: Crawlen, URLs bereinigen und Daten extrahieren

TL;DR: GoSpider ist ein Befehlszeilen-Crawler zum Auffinden von URLs, kein vollständiger Scraper für strukturierte Daten. Diese Anleitung zur Verwendung von GoSpider zeigt einen begrenzten Crawl, die saubere Verarbeitung der Ausgabe, die Übergabe von Colly an CSV sowie einen Diagnosepfad für 403-Antworten oder Seiten, die eine JavaScript-Darstellung erfordern.

Suciu Dan20 min read
Artikel lesen
Wie man Redfin scrappt: Python-Leitfaden für Immobiliendaten
Anleitungen

Wie man Redfin scrappt: Python-Leitfaden für Immobiliendaten

TL;DR: Redfin stellt versteckte API-Endpunkte zur Verfügung, die strukturiertes JSON für Immobilienangebote zurückgeben, wodurch das fragile HTML-Parsing vollständig übersprungen werden kann. Diese Anleitung führt Sie durch den Aufbau eines Python-Scrapers, der Miet- und Verkaufsdaten extrahiert, nach Standort sucht, neue Angebote über XML-Sitemaps überwacht und saubere Ergebnisse in CSV oder JSON exportiert.

Suciu Dan11 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.