TL;DR: Eine Web-Scraping-API kann – je nach Dienst – das Abrufen von Daten, die Proxy-Verwaltung oder die Ausführung im Browser aus Ihrer Anwendung auslagern. Die strukturierte Extraktion ist eine eigenständige Funktion, und weder eine erfolgreiche Anfrage noch gültiges JSON garantieren verwertbare Daten. Prüfen Sie, welche Verantwortung Sie auslagern, welche Datensätze Sie akzeptieren und welche Wiederherstellungsaufgaben weiterhin in Ihrer Verantwortung liegen.
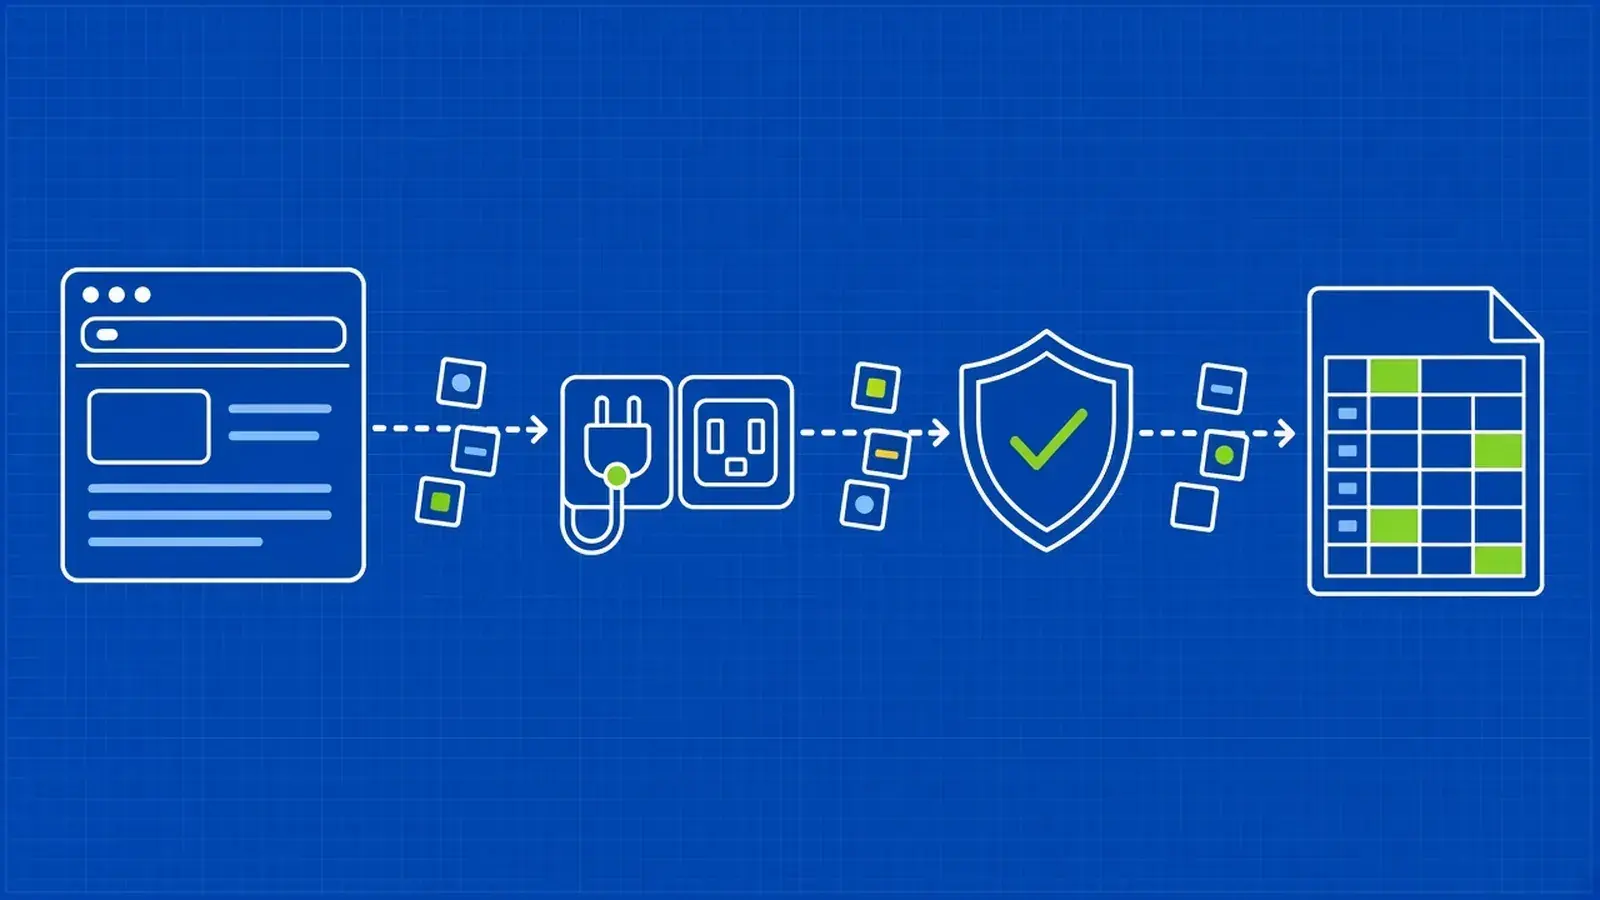
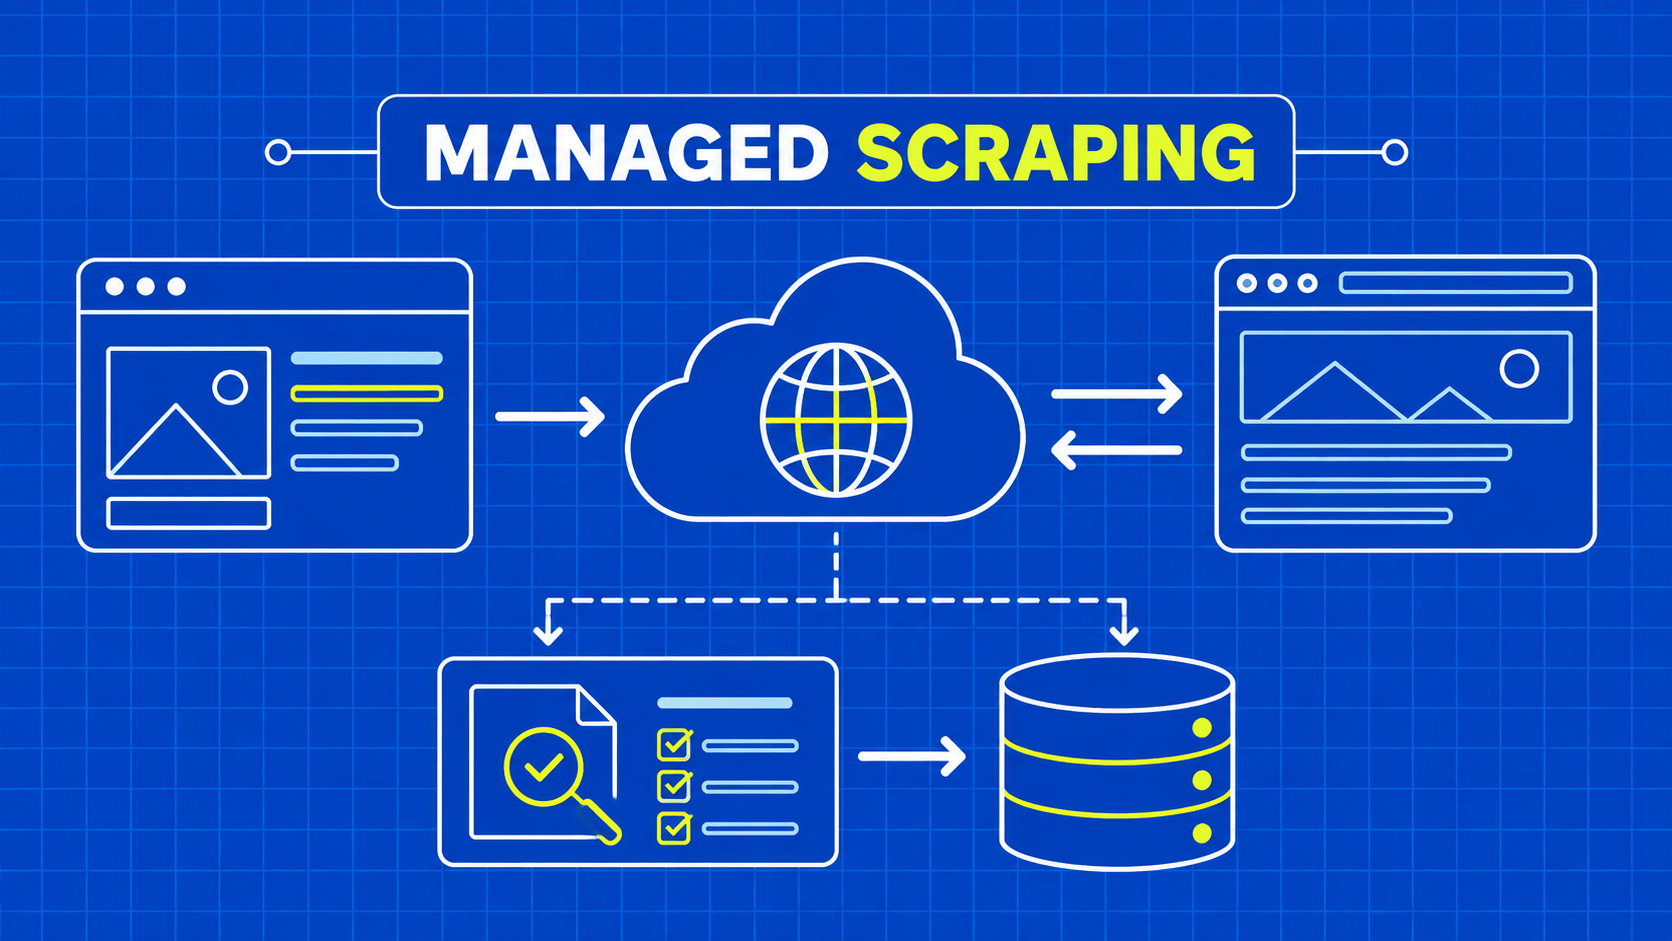
Eine Web-Scraping-API ist eine Service-Schnittstelle, über die Ihre Anwendung Webseiteninhalte oder extrahierte Daten anfordert. Ihr wichtigster Vorteil liegt in einer Verlagerung der betrieblichen Verantwortung: Ihr Team kann einen definierten Dienst nutzen, anstatt jede Komponente zu warten, die die Seite abruft.
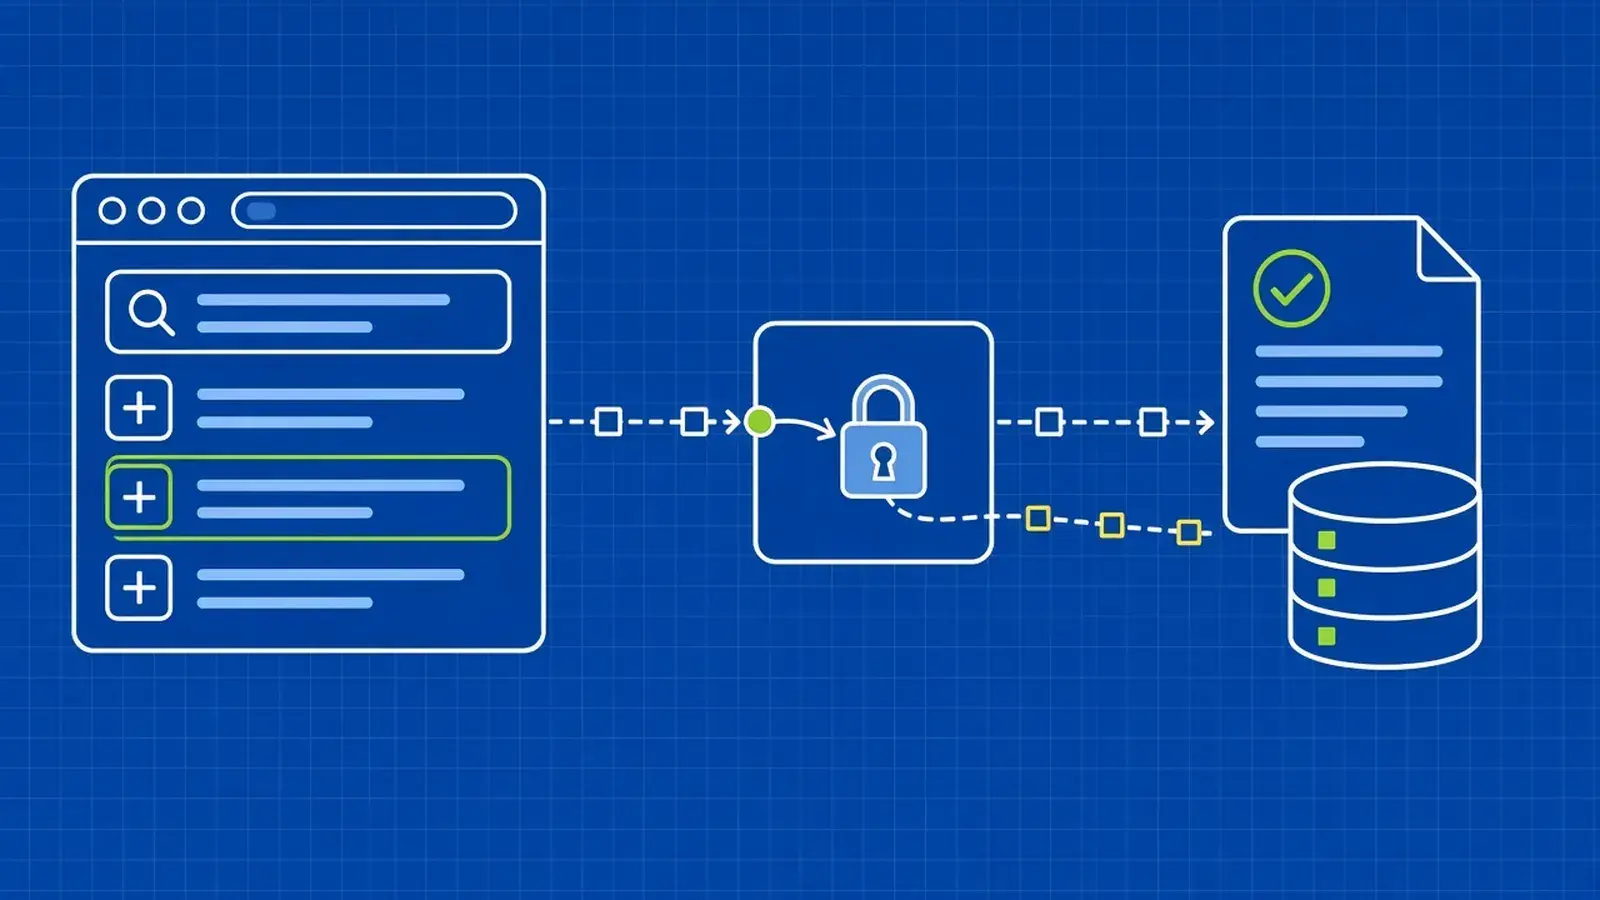
Stellen Sie sich einen täglichen Katalog-Job vor. Gestern hat er jede Seite abgerufen, doch der heutige Durchlauf verbringt seine Zeit damit, Browser neu zu starten. Der Kauf eines Extraktionsdienstes könnte helfen, aber nur, wenn dieser die fehlgeschlagene Verantwortung übernimmt. Ein Dienst, der rohes HTML zurückgibt, überlässt die Feldextraktion weiterhin Ihnen. Eine strukturierte Antwort erfordert nach wie vor Überprüfungen auf das richtige Produkt, die richtige Währung und den richtigen Erfassungszeitpunkt.
Dieser Leitfaden erläutert die Vorteile von Web-Scraping-APIs, ohne eine API als vollständige Datenplattform zu betrachten. Sie werden sehen, welche Aufgaben an einen Anbieter ausgelagert werden können, welche bei Ihrer Anwendung verbleiben und wie Sie beurteilen können, ob sich die Umstellung lohnt. Die Beispiele dienen als Orientierungshilfe für die Architektur und sind weder Anbieter-Benchmarks noch eine Behauptung, dass jeder Dienst die gleichen Funktionen bietet.