Zum Inhalt springen
Zurück zum Blog

Proxy-Verwaltung für Web-Scraping: Ein praxisorientierter Ansatz

Raluca PenciucZuletzt aktualisiert am 13 min read
Proxy-Verwaltung für Web-Scraping: Ein praxisorientierter Ansatz
TL;DR: Die Proxy-Verwaltung für das Web-Scraping ist die Richtlinienebene, die zulässige Aufgaben geeigneten Netzwerkrouten zuweist und nachverfolgt, was anschließend geschieht. Halten Sie den Sitzungsstatus, den Routenzustand und die Budgets für Quellanfragen voneinander getrennt. Wechseln Sie eine Route aus oder nehmen Sie sie aus dem Verkehr – aus einem dokumentierten betrieblichen Grund, nicht als automatische Reaktion auf jede fehlgeschlagene Seite.

Ein Worker erhält eine leere Produktseite und markiert seinen Proxy als ausgefallen. Ein anderer Worker wählt sofort eine neue Route und wiederholt die Anfrage. Nach mehreren Versuchen erscheint der Pool als fehlerhaft, doch der eigentliche Fehler liegt bei einem Parser, der ein Element erwartet, das in der Quelle entfernt wurde.

Das ist in erster Linie ein Verwaltungsproblem und erst in zweiter Linie ein Netzwerkproblem. Das System traf eine Routing-Entscheidung auf der Grundlage von Informationen aus der falschen Ebene. Das Hinzufügen weiterer Adressen würde den Fehler vergrößern, nicht beheben.

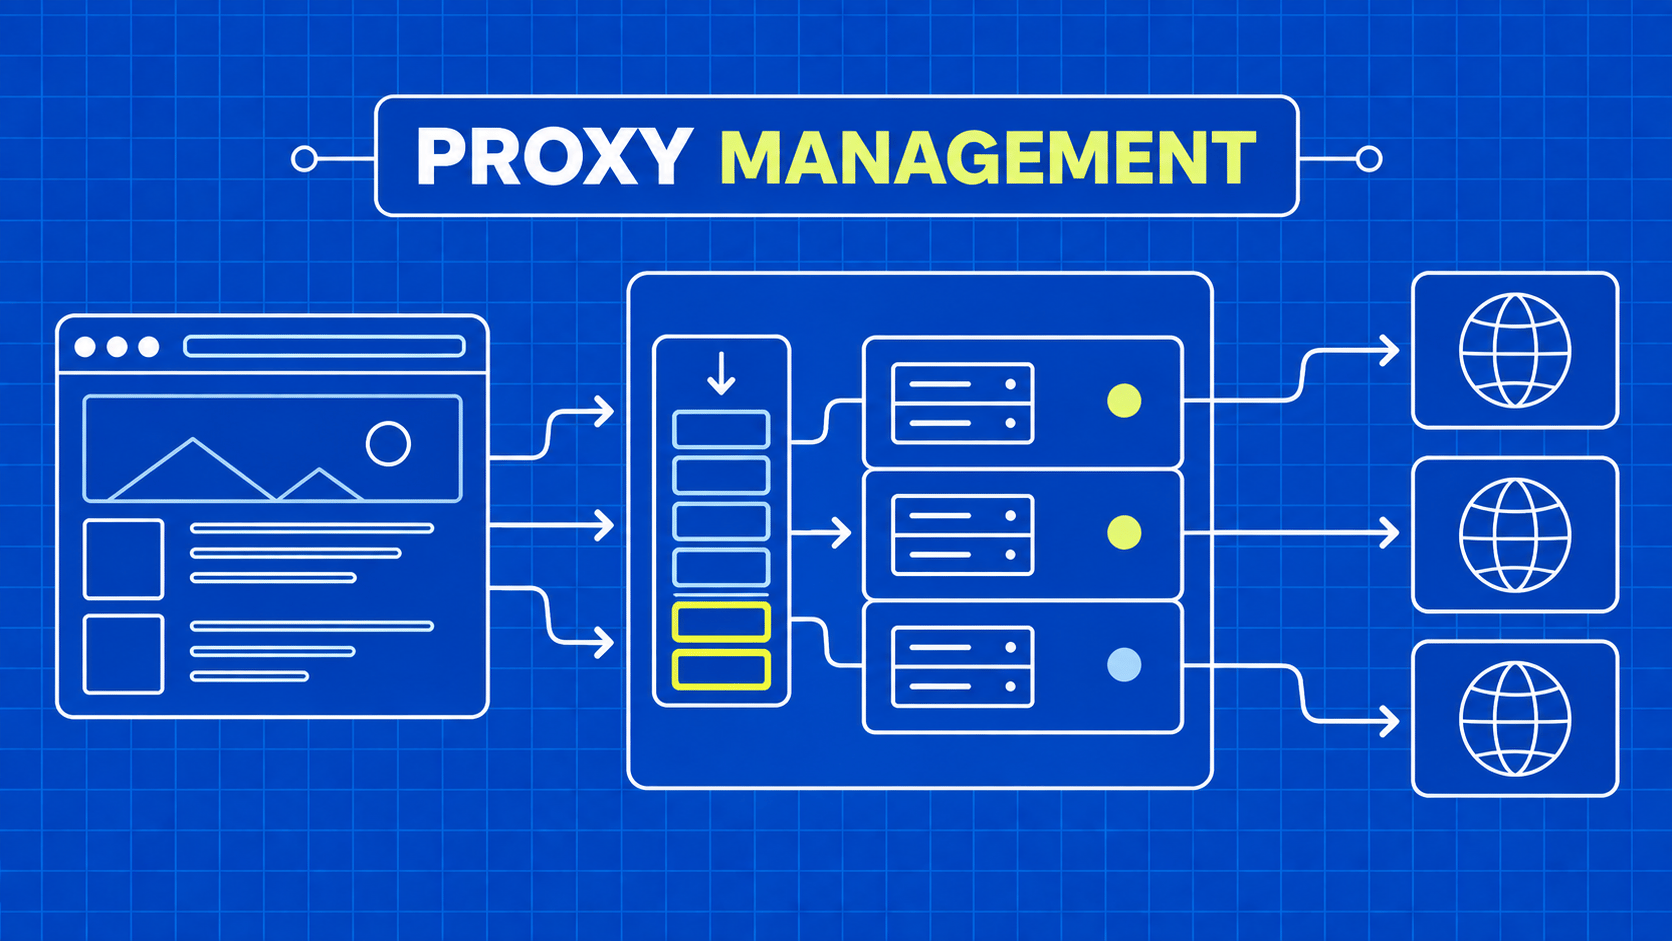
Ein nützlicher Proxy-Manager leistet mehr, als nur den nächsten Endpunkt auszuwählen. Er weiß, welche Aufgaben Kontinuität erfordern, welche Routen die genehmigten Standortanforderungen erfüllen, wie viel Datenverkehr die Quelle empfangen kann und wann ein Operator einen Ausfall überprüfen muss. Sein Erfolg wird anhand gültiger Beobachtungen gemessen, die im Rahmen der Erfassungsrichtlinie geliefert werden, und nicht daran, wie oft er Adressen wechselt.

Dieser Leitfaden beschreibt dieses Design für Entwickler, die autorisierte Sammler betreiben. Die Beispiele sind Empfehlungen für die Architektur und kein Benchmark für Anbieter. Sie können dieselben Grenzen sowohl auf einen kleinen, konfigurationsgestützten Worker als auch auf einen größeren, gemeinsam genutzten Erfassungsdienst anwenden.
Beginnen Sie die Proxy-Verwaltung für Web-Scraping mit einem Vertrag

Legen Sie fest, was ein Arbeitselement benötigt, bevor Sie eine Route zuweisen. Ein nützlicher Vertrag umfasst das zulässige Ziel, gegebenenfalls die gewünschte Region, die Frist, die Anforderungen an die Sitzung und den erwarteten Ausgabetyp. Halten Sie Anmeldedaten aus der normalen diagnostischen Darstellung des Arbeitselements heraus. Der Vertrag sollte die Absicht beschreiben und nicht jede anbieterspezifische Verbindungseinstellung offenlegen.

Erstellen Sie anschließend eine Bestandsaufnahme der Routen, die Sie tatsächlich nutzen können. Erfassen Sie Produkttyp, unterstützte Protokolle, Authentifizierungsmethode, genehmigte Verwendungszwecke, Standortmöglichkeiten sowie etwaige Verbindungs- oder Datenverkehrsbeschränkungen. Unterscheiden Sie zwischen einer einzelnen Ausgangsadresse und einem Gateway, das einen Ausgang für Sie auswählt. Sie haben unterschiedliche Lebenszyklen und sollten kein mehrdeutiges Feld gemeinsam nutzen, das einfach proxy.

Die Anbieterkonfiguration ist nicht allein durch die Schreibweise übertragbar. Die Oxylabs-Proxy-Schnellstartanleitung veranschaulicht produktspezifische Endpunkte und verschiedene Mechanismen für die Standort- und Sitzungsauswahl. Behandeln Sie solche Dokumentation als Eingabe für einen Adapter und nicht als Grund, die Benutzernamenssyntax eines Anbieters in Ihrem gesamten Extraktionscode zu verankern.

Fügen Sie explizite Ausschlüsse hinzu. Manche Aufgaben müssen auf einer kontrollierten Infrastruktur verbleiben; manche dürfen keine Cookies an Dritte senden; manche benötigen kein alternatives Netzwerk-Routing. Ein Manager sollte in der Lage sein, inkompatible Aufgaben abzulehnen, anstatt stillschweigend die nächstgelegene verfügbare Option zu wählen.

Schließlich sollten Sie die Akzeptanz getrennt von der Bereitstellung definieren. Der Empfang von Bytes erfüllt eine Transportanforderung. Die Erstellung eines korrekt identifizierten, zeitnahen Datensatzes erfüllt eine Datenanforderung. Die Beibehaltung dieser Unterscheidung vom ersten Entwurfsdokument an verhindert, dass das Gesundheitssystem einen Anwendungsfehler mit einem ausgefallenen Netzwerkpfad verwechselt.

Weisen Sie Routen nach Richtlinien zu, statt nach dem Zufallsprinzip

Eine zufällige Auswahl kann zwar unabhängige Aufgaben verteilen, stellt jedoch keine vollständige Zuteilungsrichtlinie dar. Filtern Sie zunächst die Kandidaten anhand der zwingenden Anforderungen: Protokoll, genehmigter Zielbereich, Standort und Sitzungskompatibilität. Berücksichtigen Sie anschließend Verfügbarkeit und Kapazität. Die Auswahl unter den in Frage kommenden Kandidaten ist der letzte Schritt, nicht der erste.

Arbeitsanforderung

Zuweisungsregel

Nicht verhindert

Unabhängige, schreibgeschützte Seite

Verwenden Sie eine zulässige, verfügbare Route

Unnötige Sitzungskopplung

Mehrstufiger zulässiger Workflow

Eine Route für den Workflow anmieten

Kontextwechsel auf halbem Weg

Spezifische regionale Beobachtung

Erforderlich: verifizierte, anwendbare Routenführung

Vergleich von Datensätzen aus verschiedenen Märkten

Sensible Anfragebedingungen

Nur genehmigte Infrastruktur verwenden

Übermittlung vertraulicher Daten über einen nicht geprüften Pfad

Abgelaufene Erfassungsfrist

Keine neuen Aufgaben zuweisen

Ausgaben für bereits nutzlose Ergebnisse

Legen Sie für eine Zuweisung eine begrenzte Laufzeit fest. Eine Lease identifiziert den Eigentümer der Aufgabe und läuft ab oder wird freigegeben, wenn der Workflow abgeschlossen ist. Dies hilft dabei, Kapazitäten wiederherzustellen, wenn ein Worker ausfällt. Gehen Sie nicht davon aus, dass ein fehlender Heartbeat beweist, dass ein Netzwerkendpunkt defekt ist; es kann auch bedeuten, dass der Worker oder die Steuerungsebene ausgefallen ist.

Halten Sie Zuweisungsentscheidungen nachvollziehbar. Eine kurze Begründung wie „erforderliche Region nicht verfügbar“ ist besser als ein stiller Fallback, der falsche Inhalte zurückgibt. Eine Warteschlange kann bis zum Ablauf der Frist auf verfügbare Kapazität warten und dann ein eindeutiges Endergebnis liefern.

Vermeiden Sie unnötige globale Komplexität. Eine überschaubare Arbeitslast benötigt möglicherweise lediglich eine statische Richtliniendatei und einen kleinen Lease-Speicher, nicht jedoch eine verteilte Planungsplattform. Fügen Sie Koordinationsmechanismen hinzu, wenn sich mehrere Worker eine begrenzte Ressource oder ein systemweites Budget teilen. Die Richtlinie sollte auch bei wachsender Implementierung verständlich bleiben, da die für die Störungsbehebung zuständigen Mitarbeiter weiterhin erklären müssen, warum eine Anfrage eine bestimmte Route genutzt hat.

Verwalten Sie eine Sitzung als mehr als nur eine IP-Adresse

Eine stabile Ausgangsadresse ist nur ein Teil einiger Sitzungen, nicht die vollständige Definition einer Sitzung. Die Anwendung kann auch von Cookies, Browserspeicher, Ländereinstellungen, Authentifizierung und dem Fortschritt innerhalb einer Abfolge abhängen. Modellieren Sie diese als miteinander verbundene, aber eigenständige Zustände, anstatt anzunehmen, dass ein einziges Routing-Flag alles bewahrt.

Eine Sitzungslease sollte einen Eigentümer, eine Startzeit, eine erwartete Lebensdauer und eine Wiederherstellungsgrenze haben. Wenn sich das Netzwerk unerwartet ändert, muss entschieden werden, ob die Arbeit fortgesetzt werden kann oder von einem bekannten Zustand aus neu gestartet werden muss. Diese Entscheidung obliegt dem Workflow, nicht einem generischen Pool-Manager, der die Anwendungssemantik nicht erkennen kann.

Beispielsweise liefert eine zulässige Katalogfilterfolge nur dann vergleichbare Ergebnisse, wenn ihre Region und ihr Filterstatus konsistent bleiben. Wenn die Kontinuität verloren geht, markieren Sie die Teilbeobachtung als unvollständig. Kombinieren Sie keine frühere Seite aus einem Kontext mit einer späteren Seite aus einem anderen und präsentieren Sie diese nicht als einen zusammenhängenden Datensatz.

Der Leitfaden zu HTTP-Cookies und Scraping-Sitzungen erklärt, warum die Cookie-Verwaltung neben, aber nicht innerhalb der Routenauswahl angesiedelt sein sollte. Beschränken Sie die Gültigkeit von Cookie-Jars auf die beabsichtigte Sitzung. Ihre gemeinsame Nutzung über nicht miteinander in Zusammenhang stehende Aufträge hinweg kann sowohl zu einem falschen Kontext als auch zu einer unnötigen Offenlegung von Daten führen.

Geben Sie den Status bewusst frei, wenn der Workflow endet. Lassen Sie Leasingverträge ablaufen, löschen Sie temporäre Browserprofile, wo dies angemessen ist, und behalten Sie nur die diagnostischen Metadaten, die gemäß den Richtlinien erforderlich sind. Eine wachsende Sammlung vergessener Sitzungsobjekte ist keine nützliche Ausfallsicherheit. Es handelt sich um einen nicht nachverfolgten Zustand, der spätere Fehler schwer reproduzierbar macht und Informationen möglicherweise länger speichert, als es die Aufgabe erfordert.

Trennen Sie den Routenzustand vom Zustand der Quelle und des Parsers

Verwenden Sie mehr als eine Integritätsdimension. Eine Route kann einen kontrollierten Endpunkt erreichen, während eine bestimmte Quelle die Anfrage ablehnt. Eine Quelle kann eine gültige Seite zurückgeben, während der Parser fehlschlägt. Das Managementsystem muss diese Unterscheidungen beibehalten, bevor es entscheidet, was unter Quarantäne gestellt werden soll.

Beobachtung

Wahrscheinliche Untersuchungsebene

Angemessene Reaktion des Managements

Keine Verbindung zum Gateway möglich

Netzwerk- oder Proxy-Konfiguration

Route und Konnektivität prüfen

Proxy-Authentifizierung abgelehnt

Anmeldedaten oder Zulassungsliste

Betroffene Konfiguration pausieren

Ziel-Ratenbegrenzung

Richtlinie für den Quellverkehr

Relevante Vorgänge reduzieren oder pausieren

Identitätskonflikt bei der Seite

Quellantwort oder Kontext

Quarantäne zur Überprüfung

Erforderliches Feld fehlt

Quelllayout oder Parser

Untersuchen Sie die Extraktion, nicht den gesamten Pool

Sofern ein Vermittler diesen bereitstellt, kann der in RFC 9209 definierte „Proxy-Status“-Header strukturierte Diagnoseinformationen zur Proxy-Verarbeitung liefern. Sein Fehlen ist kein Hinweis darauf, dass die Route intakt oder defekt ist. Verwenden Sie ihn in Verbindung mit Zeitangaben, Client-Ausnahmen und dem tatsächlichen Antwortkontext, anstatt ihn als verbindliches universelles Signal zu betrachten.

Definieren Sie Zustandsprüfungen für die Infrastruktur, die Ihnen gehört oder die Sie testen dürfen. Eine minimale Prüfung kann das erwartete Verbindungs- oder Standortverhalten verifizieren, ohne die Produktionsquelle wiederholt anzusteuern. Halten Sie die Prüfungen begrenzt und vermeiden Sie die Übertragung sensibler Sitzungszustände an einen Diagnose-Endpunkt.

Unser Leitfaden zu Proxy-Statusfehlern beschreibt einen detaillierteren Vorfall-Workflow. Im Manager ist die Zuordnung entscheidend: Isolieren Sie die kleinste betroffene Einheit, die durch Beweise gestützt wird. Eine quellenspezifische Ablehnung sollte nicht automatisch jede Route als fehlerhaft einstufen, und eine erfolgreiche Diagnoseantwort sollte keine ungültigen Datensätze bestätigen.

Setzen Sie eine quellweite Auslastungssteuerung über den gesamten Pool hinweg durch

Ein größerer Proxy-Pool bedeutet nicht automatisch ein größeres Berechtigungsbudget. Wenn mehrere Worker Daten von einer Quelle abrufen, koordinieren Sie die insgesamt zulässige Rate, anstatt jeder Route ein unabhängiges Kontingent zuzuweisen, das den Gesamtdatenverkehr vervielfacht. Stellen Sie in der Entscheidungsreihenfolge die Quellenrichtlinie über die Routenzuweisung.

HTTP 429 weist auf eine Ratenbegrenzung hin, doch der Standard verlangt nicht, dass der Server ausschließlich nach IP-Adressen zählt. RFC 6585 erlaubt ausdrücklich andere Methoden zur Identifizierung von Benutzern und zur Zählung von Anfragen. Das Rotieren einer Adresse stellt daher weder eine Berechtigung noch eine wirksame Abhilfe für einen ratenbegrenzten Workflow dar.

Verwenden Sie einen gemeinsamen Begrenzer oder einen anderen Koordinationsmechanismus, der zu Ihrem Worker-Modell passt. Beziehen Sie Wiederholungsversuche in dasselbe Kontingent ein. Ein Wiederholungsversuch ist immer noch eine Anfrage an die Quelle; wenn man ihn als kostenlose Hintergrundarbeit behandelt, kann dies dazu führen, dass die verkehrsreichste Zeit mit einem Vorfall zusammenfällt.

Beachten Sie geltende Warteanweisungen und halten Sie an, wenn das zulässige Wiederherstellungsfenster nicht mit der Auftragsfrist vereinbar ist. Reduzieren Sie den Arbeitsaufwand, anstatt um jeden Preis den Durchsatz aufrechterhalten zu wollen. Ein veralteter Datensatz, der nach einer anhaltenden Flut von Wiederholungsversuchen entsteht, kann schlimmer sein als eine explizit fehlende Beobachtung.

Eine adaptive Drosselung kann helfen, ist jedoch kein Ersatz für Richtlinien. Die „AutoThrottle“-Dokumentation von Scrapy beschreibt eine latenzbasierte Verzögerungsanpassung, die die konfigurierten Einstellungen für Parallelität und Verzögerung berücksichtigt. Wenn Sie einen ähnlichen Mechanismus verwenden, stellen Sie sicher, dass dessen Gruppierung mit dem Quellenbudget übereinstimmt, das Sie durchsetzen möchten. Eine automatisch gewählte Verzögerung kann dennoch ungeeignet sein, wenn jeder Proxy fälschlicherweise als separate Quelle behandelt wird.

Schaffen Sie Observability rund um akzeptierte Aufträge

Erfassen Sie genügend Informationen, um eine Zuweisungsentscheidung mit einem Endergebnis in Verbindung zu bringen. Zu den nützlichen Feldern gehören die Arbeits-ID, die Routenreferenz, die Konfigurationsversion, die Quellgruppe, der Zeitpunkt, die Anzahl der Wiederholungsversuche und die Ergebniskategorie. Bevorzugen Sie undurchsichtige Verweise gegenüber rohen Anmeldedaten oder vollständigen sensiblen URLs. Der Zweck besteht darin, das Verhalten zu erklären, nicht darin, jede Anfrage in ein permanentes Protokoll zu kopieren.

Verfolgen Sie sowohl Betriebs- als auch Datenkennzahlen. Verbindungsfehler beschreiben das Routenverhalten. Die Ausbeute an akzeptierten Datensätzen beschreibt, ob der gesamte Erfassungspfad nützliche Ergebnisse geliefert hat. Das Alter der Warteschlange und verpasste Fristen beschreiben, ob dies rechtzeitig geschah. Kein einzelner Erfolgsprozentsatz erfasst alle drei Aspekte.

Gliedern Sie die Metriken nach aussagekräftigen Workload-Segmenten auf. Ein einwandfreier Workload mit statischen Seiten kann Fehler auf interaktiven Seiten verschleiern, wenn alles zusammen gemittelt wird. Umgekehrt sollte eine sich ändernde Quelle nicht dazu führen, dass das gesamte Netzwerk als unbrauchbar erscheint. Halten Sie die Segmentdefinitionen stabil genug, um Durchläufe vergleichen zu können.

Richten Sie Warnmeldungen auf Entscheidungen aus, die jemand treffen kann. „Es sind viele Fehler aufgetreten“ ist weniger umsetzbar als „die genehmigte regionale Arbeitslast hat vor Ablauf der Frist keine zulässigen Routen“. Verknüpfen Sie die Warnmeldung mit einem Runbook, das eine Stoppbedingung, einen Verantwortlichen und die zu sammelnden Nachweise enthält.

Für eine Kostenübersicht teilen Sie vergleichbare Betriebsausgaben durch eindeutige, gültige und zeitnahe Datensätze statt durch gesendete Anfragen. Berücksichtigen Sie Wartungsarbeiten, die sich zwischen den Konfigurationen wesentlich ändern. Erfinden Sie nicht für jede Protokollmeldung einen Geldwert, sondern erfassen Sie wiederkehrende Arbeitszeiten der Betreiber. So lässt sich entscheiden, ob eine stärker verwaltete Erfassungsgrenze tatsächlich Arbeitsaufwand einsparen würde.

Schützen Sie die Steuerungsebene und überprüfen Sie die Netzwerk-Sourcing-Praktiken

Bewahren Sie Proxy-Anmeldedaten in einem genehmigten geheimen Speicher oder in der Umgebungskonfiguration auf, nicht in Artikelbeispielen, Job-Nutzdaten oder öffentlichen Dashboards. Beschränken Sie den Zugriff auf die Prozesse, die ihn benötigen, wechseln Sie Anmeldedaten bei Bedarf aus und stellen Sie sicher, dass ausgeschiedene Mitarbeiter keinen Zugriff mehr haben. Schützen Sie Verwaltungsendpunkte genauso sorgfältig wie den Collector selbst.

Überprüfen Sie die Vertrauensgrenze für jeden Verbindungsmodus. Was kann der Vermittler beobachten? Sendet der Workflow Authentifizierungs-Cookies oder private Request-Bodies? Verfügen Sie über eine genehmigte Vereinbarung zur Aufbewahrung und Verarbeitung dieser Inhalte? Diese Fragen sind unabhängig davon von Bedeutung, ob es sich um einen kostenlosen oder kostenpflichtigen Dienst handelt.

Bei Netzwerken, an denen Geräte von Teilnehmern beteiligt sind, verlangen Sie Nachweise zum Beschaffungsmodell, zum Einwilligungsprozess, zum Widerrufsmechanismus und zum Umgang mit Missbrauch. Eine Erklärung des Anbieters kann als Leitfaden für die Sorgfaltsprüfung dienen, ist jedoch nicht mit einem von Ihnen durchgeführten Audit gleichzusetzen. Halten Sie fest, welches Produkt und welche Vereinbarung die Überprüfung abdeckt, anstatt davon auszugehen, dass eine pauschale Unternehmensangabe überall gilt.

Der Zugriff auf Quellen ist eine separate Entscheidung. Ein legitimes Netzwerk erteilt keine Erlaubnis, jede erreichbare Ressource zu erfassen. Das Robots Exclusion Protocol unterscheidet zwischen Anweisungen für Crawler und Zugriffsberechtigungen. Befolgen Sie die Anweisungen der Quelle und den von der Organisation genehmigten Erfassungsumfang und leiten Sie Zugriffskonflikte an einen menschlichen Verantwortlichen weiter.

Statten Sie die Betreiber mit einer sicheren Stopp-Funktion aus, die neue Zuweisungen pausiert, ohne bereits in der Warteschlange befindliche Aufgaben zu löschen. Während eines Vorfalls ist die Möglichkeit, den Datenverkehr zu stoppen und Beweismittel zu sichern, wichtiger als die Beschäftigung aller Mitarbeiter. Testen Sie diese Funktion, bevor das System sie dringend benötigt.

Führen Sie Richtlinienänderungen mit einem Wiederherstellungspfad ein

Entwickeln Sie Routing-Richtlinien unabhängig von der Parsing-Logik. Eine Änderung an einer Standortanforderung oder der Laufzeit einer Lease sollte als Konfigurationsrevision sichtbar sein und nicht zwischen nicht damit zusammenhängenden Extraktionsänderungen versteckt werden. Halten Sie die vorherige Konfiguration für ein definiertes Rollback-Fenster verfügbar.

Beginnen Sie mit einer Arbeitslast mit geringem Risiko und überprüfen Sie sowohl akzeptierte als auch abgelehnte Beobachtungen. Behalten Sie stabile Arbeitskennungen bei, damit bei der Wiedergabe keine Datensätze doppelt erstellt werden. Wenn Sie Konfigurationen parallel vergleichen, halten Sie den kombinierten Datenverkehr innerhalb desselben genehmigten Quellbudgets, anstatt die Last aus Bequemlichkeit zu verdoppeln.

Testen Sie Fehlergrenzen gezielt in kontrollierten Testumgebungen. Lassen Sie eine Lease ablaufen, unterbrechen Sie einen Worker, machen Sie eine Route unzugänglich und verzögern Sie eine Speicherbestätigung. Überprüfen Sie, ob die Arbeit entweder wiederhergestellt oder eindeutig als unvollständig markiert wird. Gehen Sie nicht davon aus, dass ein Neustart des Prozesses die Konsistenz der Daten belegt.

Der Leitfaden zum automatisierten Web-Scraping erläutert den dauerhaften Arbeitszustand und die Wiederherstellung auf Pipeline-Ebene. Ein Proxy-Manager sollte mit diesem Zustand zusammenarbeiten und keine isolierte Sicht auf den Erfolg beibehalten, die der Scheduler nicht in Einklang bringen kann.

Überprüfen Sie nach der Einführung, ob die neue Richtlinie das beabsichtigte Ergebnis verbessert hat. Sind die Sitzungsausfälle zurückgegangen? Blieb die Quellenauslastung innerhalb der Richtlinie? Hat sich die Belastung für den Betreiber tatsächlich verringert? Beziehen Sie die Antwort auf die beobachtete Arbeitslast, nicht auf die Poolgröße. Entfernen Sie ungenutzte Anmeldedaten und veraltete Konfigurationen erst, nachdem die Rollback-Phase und die Überprüfung der Verantwortlichkeiten abgeschlossen sind.

Wichtige Erkenntnisse

  • Filtern Sie Routen nach expliziten Arbeitsanforderungen, bevor Sie den Datenverkehr verteilen.
  • Behandeln Sie Routing-Leases, Anwendungssitzungen und Budgets für Quell-Anfragen als getrennte Konzepte.
  • Ordnen Sie Fehler dem Transport, einem Zwischenstation, der Quelle oder der Extraktion zu, bevor Sie den Pool-Zustand ändern.
  • Zählen Sie Wiederholungsversuche bei gemeinsam genutzten Quelllimits mit und bewahren Sie eine sichere Pausensteuerung bei.
  • Messen Sie akzeptierte Datensätze, die Einhaltung von Fristen und den Aufwand für den Bediener, nicht die Häufigkeit der Adressrotation.

FAQ

Benötigt jeder Collector einen separaten Proxy-Management-Dienst?

Nein. Ein kleiner Collector mit nur einem Worker ist möglicherweise besser mit einer expliziten Konfiguration und einem einfachen Richtlinienmodul bedient. Ein gemeinsam genutzter Dienst wird dann sinnvoll, wenn mehrere Worker Leases, Anmeldedaten oder Quellenbudgets koordinieren müssen. Führen Sie ihn bei einem konkreten Koordinationsproblem ein, anstatt davon auszugehen, dass eine größere Architektur eine moderate Arbeitslast automatisch zuverlässiger macht.

Sollten Routenidentifikatoren in exportierte Geschäftsdatensätze aufgenommen werden?

Bewahren Sie diese in der Regel in eingeschränkten operativen Metadaten auf und nicht in für Verbraucher bestimmten Datensätzen. Verbraucher benötigen normalerweise Herkunftsinformationen wie Quell-URL, Erfassungszeitpunkt und Schemaversion. Operative Routenverweise können für Untersuchungen über eine Arbeits-ID verknüpft bleiben. Diese Trennung gewährleistet die Verfügbarkeit von Diagnosedaten, ohne Infrastrukturdetails unnötig offenzulegen oder nachgelagerte Logik dazu zu veranlassen, von einem bestimmten Anbieter abhängig zu sein.

Kann eine Route für eine Arbeitslast funktionsfähig und für eine andere ungeeignet sein?

Ja. Der Zustand beschreibt das beobachtete Verhalten unter bestimmten Bedingungen, während die Eignung vom Arbeitsvertrag abhängt. Eine Route kann zwar korrekt verbunden sein, aber einen erforderlichen Standort oder eine genehmigte Abwicklungsvereinbarung vermissen lassen. Halten Sie Eignungsentscheidungen getrennt von Zustandsbewertungen, damit eine funktionierende Route nicht für Aufgaben ausgewählt wird, für deren Ausführung sie nie vorgesehen oder autorisiert war.

Fazit

Gutes Proxy-Management für Web-Scraping beginnt mit Verantwortung, nicht mit Rotation. Definieren Sie den Arbeitsvertrag, weisen Sie nur zulässige Routen zu und bewahren Sie die Unterscheidung zwischen einer Netzwerkverbindung, einer Anwendungssitzung und einem akzeptierten Datensatz. Diese Struktur verhindert, dass nicht damit zusammenhängende Ausfälle als Beweis dafür gewertet werden, dass der gesamte Pool ersetzt werden muss.

Halten Sie die quellseitige Auslastung über dem Pool und machen Sie Wiederholungsversuche im selben Budget sichtbar. Schaffen Sie genügend Observabilität, um eine Zuweisung zu erklären, genügend dauerhaften Status, um unvollendete Arbeit wiederherzustellen, und eine Stoppsteuerung, der die Betreiber vertrauen können. Betrachten Sie die Überprüfung von Anmeldedaten und die Netzwerkbeschaffung als fortlaufende betriebliche Aufgaben und nicht als einmalige Einrichtungsaufgaben.

Das daraus resultierende System sollte Ausfälle minimieren und Entscheidungen leichter überprüfbar machen. Wenn die Wartung der Abrufschicht die Belastung ist, die Sie beseitigen möchten, bewerten Sie die Scraper-API von WebScrapingAPI im Hinblick auf Ihre bestehenden Akzeptanz- und Zugriffsvereinbarungen. Eine verwaltete Grenze ist dann sinnvoll, wenn sie bestimmte Aufgaben übernimmt, ohne die Verantwortlichkeiten zu verschleiern, die Ihre Anwendung weiterhin trägt.

Über den Autor

Raluca Penciuc, Full-Stack-Entwickler @ WebScrapingAPI

Raluca Penciuc

Full-Stack-Entwickler

Raluca Penciuc ist Full-Stack-Entwicklerin bei WebScrapingAPI. Sie entwickelt Scraper, verbessert Umgehungsstrategien und findet zuverlässige Wege, um die Erkennung auf Zielwebsites zu verringern.

Nodriver-Python-Tutorial: Unauffälliges Web-Scraping – vom ersten Skript bis zur Produktion
Die Wissenschaft des Web-Scrapings

Nodriver-Python-Tutorial: Unauffälliges Web-Scraping – vom ersten Skript bis zur Produktion

TL;DR: Kurzfassung: Nodriver ist eine asynchrone Python-Bibliothek, die Chromium über das Chrome DevTools Protocol steuert, ohne Selenium oder chromedriver-Binary. Nutzen Sie sie, wenn ein selbst gehosteter Stealth-Browser, der einer echten Chrome-Sitzung näherkommt, besser passt als ein WebDriver-Stack – aber sie beseitigt IP-, TLS- oder Verhaltensrisiken nicht von allein. Dieses Tutorial führt vom ersten Skript bis zur containerisierten Produktion und einer gehosteten Browser API.

Suciu Dan12 min read
Artikel lesen
Umgang mit Google-/goto-Weiterleitungs-URLs und CAES-Token in einem SERP-Scraper
Die Wissenschaft des Web-Scrapings

Umgang mit Google-/goto-Weiterleitungs-URLs und CAES-Token in einem SERP-Scraper

TL;DR: Kurzfassung: Google-/goto-URLs mit CAES-Token und ältere /url-Wrapper sind Weiterleitungsschichten, keine Ziele; ein SERP-Scraper, der jede href als endgültig behandelt, verfälscht Rank-Tracking und Link-Datenbanken. Bevorzugen Sie eine strukturierte SERP-API, wenn sie Ziel-Links liefert. Wenn Sie HTML parsen müssen, klassifizieren Sie jede href, deduplizieren Sie Weiterleitungen und lösen Sie sie mit einem einfachen GET auf. Entschlüsseln Sie CAES nicht.

Suciu Dan11 min read
Artikel lesen
HTTP-Antwort-Header in cURL: Jedes Flag, jede Technik und jedes Skripting-Rezept
Die Wissenschaft des Web-Scrapings

HTTP-Antwort-Header in cURL: Jedes Flag, jede Technik und jedes Skripting-Rezept

TL;DR: cURL verbirgt standardmäßig Antwort-Header. Verwenden Sie -i, um Header neben dem Body zu sehen, -I für eine HEAD-Anfrage, die nur Header zurückgibt, -v für vollständiges Debugging von Anfrage und Antwort und -D, um Header in einer Datei zu speichern. Für modernes Scripting können Sie mit cURL 7.83+ einzelne Header extrahieren oder mit der Option -w write-out alle Header als JSON ausgeben.

Suciu Dan11 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.