Zum Inhalt springen
Zurück zum Blog

API-Stile: Vergleich von fünf praktischen Integrationsmodellen

Robert MunceanuZuletzt aktualisiert am 13 min read
API-Stile: Vergleich von fünf praktischen Integrationsmodellen
TL;DR: REST, SOAP, GraphQL, RPC und Webhooks beschreiben verschiedene Aspekte einer Integration. Vergleichen Sie deren Ressourcenmodell, Nachrichtenkontrakt, Abfrageverhalten, Operationssemantik und Übermittlungsrichtung, anstatt sie als fünf austauschbare Protokolle zu betrachten.

Ein Katalogdienst kann REST-Lesezugriffe anbieten, Webhook-Benachrichtigungen versenden und einen internen RPC-Dienst aufrufen, um den Lagerbestand zu berechnen. Alle drei Funktionen können zu ein und demselben Produkt gehören. API-Stile sind Ansätze zur Organisation der Art und Weise, wie Software Funktionen bereitstellt und Informationen austauscht; der Begriff wird jedoch oft so locker verwendet, dass Architektur mit Nachrichten- und Übermittlungsmustern vermischt wird.

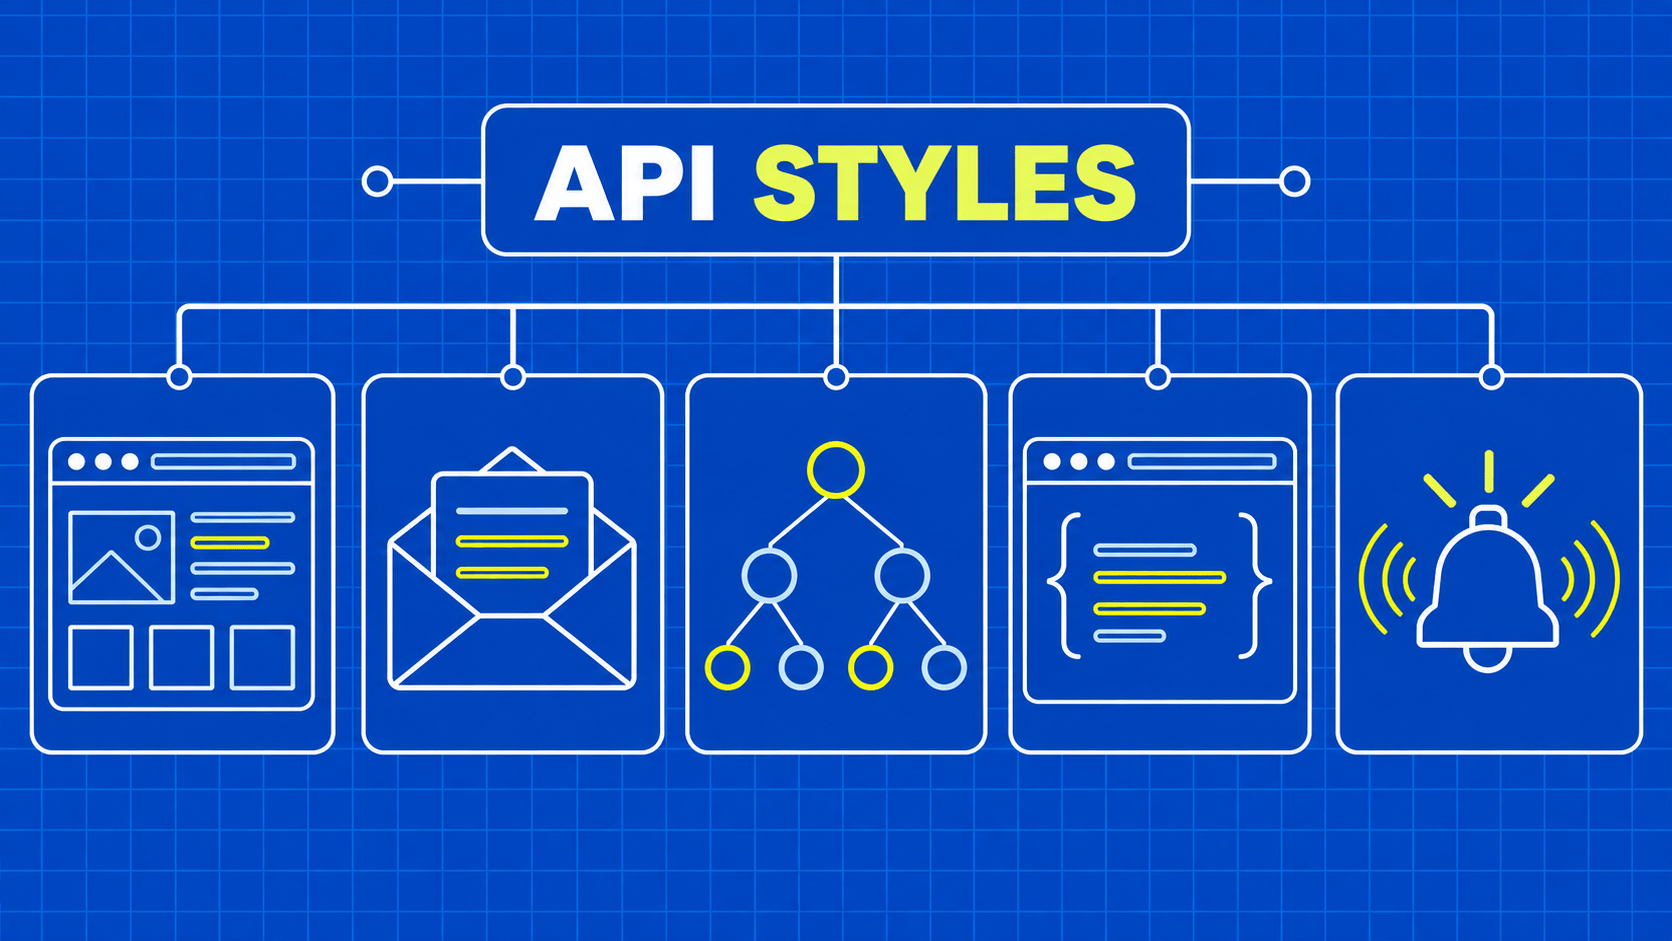
Diese lockere Verwendung macht einen gängigen Vergleich irreführend. REST ist ein Architekturstil, SOAP ist ein Messaging-Protokoll, GraphQL ist eine Abfragesprache und ein Ausführungsmodell, RPC beschreibt Remote-Operations-Aufrufe und Webhooks beschreiben ereignisgesteuerte Übermittlung. Es handelt sich um nützliche Ansätze zum Vergleich, nicht um sich gegenseitig ausschließende Kategorien, in die jede API passen muss.

Dieser Leitfaden verwendet einen hypothetischen Katalog, um fünf gängige Ansätze zu erläutern. Er ordnet sie nicht nach Marktanteilen ein und behauptet auch nicht, dass sie die einzigen Optionen sind. Das Ziel ist praktischer Natur: zu erkennen, was die Schnittstelle eines Anbieters verspricht, welche Fehlerfälle Sie behandeln müssen und wo sich zwei Ansätze gegenseitig ergänzen können. Für einen Datensammler sind diese Antworten wichtiger als die Wahl der Bezeichnung, die in einem Architekturdiagramm am häufigsten vorkommt.

Vergleichen Sie API-Stile, ohne ihre Kategorien zu verwechseln

Bevor Sie eine Beispiel-Nutzlast untersuchen, fragen Sie sich, was die Schnittstelle sichtbar macht. Navigiert ein Verbraucher durch Ressourcen, sendet er eine definierte Nachricht, wählt er Felder aus einem Schema aus, ruft er eine Operation auf oder erhält er nach einem Ereignis eine Benachrichtigung? Diese erste Unterscheidung gibt Ihnen Aufschluss darüber, welche Vertragsartefakte Sie anfordern müssen.

Ansatz

Kategorie

Beispiel aus dem Katalog

Zu prüfende Vertragsnachweise

REST

Architekturstil

Eine Produktdarstellung abrufen und deren Links folgen

Ressourcensemantik, Medientypen, Übergänge, Cache-Richtlinien

SOAP

Nachrichtenprotokoll

Austausch einer strukturierten Bestandsnachricht

Envelope-Version, Schemata, Bindung, Fehlerdefinitionen

GraphQL

Abfragesprache und Ausführungsmodell

Wählen Sie einen Produktnamen und ausgewählte Bestandsfelder aus

Schema, Operationsregeln, Null-Zulässigkeit, Fehler

RPC

Modell für den Fernaufruf

Aufruf einer definierten Bestandsberechnungsoperation

Dienstdefinition, Parametertypen, Fristen, Ergebnissemantik

Webhooks

Muster zur Ereignisübermittlung

Benachrichtigung erhalten, wenn sich ein Produkt ändert

Abonnement, Nutzdaten, Verifizierung, Zustell- und Wiederherstellungsrichtlinie

Die Tabelle beschreibt, was Sie prüfen sollten, nicht, was jede Implementierung garantiert. Ein als REST beschriebener Dienst stellt möglicherweise keine navigierbaren Übergänge bereit. Ein Webhook-Anbieter bietet möglicherweise eine manuelle erneute Zustellung an, jedoch keine automatischen Wiederholungsversuche. Ein generierter RPC-Client lässt einen Remote-Aufruf möglicherweise wie einen lokalen Aufruf erscheinen, ohne dass Netzwerkfehler dadurch verschwinden.

Halten Sie API-Stile von anderen Entscheidungen getrennt. JSON und XML beschreiben die Datendarstellung; HTTP beschreibt die Protokollsemantik; „öffentlich“ und „privat“ beschreiben die Offenlegung oder Zugriffsregelungen. Keine dieser Kategorien ersetzt die anderen. Ein vollständiger Integrationsvertrag benötigt mehrere davon gleichzeitig.

Schreiben Sie für den hypothetischen Katalog zunächst eine kleine Anforderung auf: Abruf aktueller Produktbeschreibungen, Erkennung von Änderungen an relevanten Produkten und Wiederherstellung nach einem Ausfall des Collectors. Nun können Sie vergleichen, wie jeder Ansatz zur Erfüllung dieser Anforderung beiträgt. Ohne diese Anforderung wird eine Liste von Funktionen zu einer Diskussion über Vorlieben statt zu einer Entscheidung über das System, das Sie benötigen.

REST: Navigation durch Ressourcen über eine einheitliche Schnittstelle

Ein REST-Design organisiert die Interaktion rund um Ressourcen und deren Repräsentationen. Im Katalogszenario ist ein Produkt die Ressource; ein Dokument, das seinen aktuellen Zustand beschreibt, ist eine Repräsentation. Ein Client kann diese Repräsentation lesen, ohne vom zugrunde liegenden Datenbanklayout abhängig zu sein.

Zu den definierenden Einschränkungen gehören die Trennung von Client und Server, zustandslose Interaktion, Cache-Fähigkeit, eine einheitliche Schnittstelle, ein schichtbasiertes System und optionales „Code-on-Demand“. Die einheitliche Schnittstelle umfasst die Identifizierung von Ressourcen, die Manipulation über Darstellungen, selbstbeschreibende Nachrichten und hypermediengesteuerte Übergänge. Fieldings Dissertation gilt als maßgebliche Definition.

Als Collector sollten Sie prüfen, wie die Schnittstelle eine nächste Seite oder eine verwandte Ressource bereitstellt. Das Verfolgen eines vorgegebenen Übergangs kann verhindern, dass eine private Regel zur URL-Bildung im Client eingebettet wird. Sie müssen dennoch das Darstellungsformat und die Link-Semantik verstehen; ein URL-Feld ohne definierte Bedeutung macht einen unbekannten Arbeitsablauf nicht verständlich.

Wenn REST über HTTP implementiert wird, spielen Methoden- und Cache-Semantik eine Rolle. Ein Abruf, der eine Validierung unterstützt, kann es dem Collector ermöglichen, eine unveränderte Darstellung unter den geltenden Bedingungen wiederzuverwenden. Das ist eine Eigenschaft, die im tatsächlichen Antwortvertrag zu überprüfen ist, und kein automatischer Vorteil der Bezeichnung „REST“.

Unter den API-Stilen wird REST oft so diskutiert, als bedeute es lesbare URLs plus JSON. Diese Vereinfachung lässt die architektonischen Anforderungen außer Acht. Der Leitfaden zu den REST-Einschränkungen bietet eine tiefergehende Betrachtung, wenn strenge Konformität für Ihr Design von Bedeutung ist.

Prüfen Sie für diesen Katalog, ob jede Anfrage den erforderlichen Kontext enthält, ob personalisierte Ergebnisse isoliert bleiben und ob unterstützte Übergänge erkennbar sind. Wenn der Anbieter stattdessen eine nützliche, aber enger gekoppelte HTTP-API anbietet, integrieren Sie diese entsprechend dem dokumentierten Verhalten. Gehen Sie nicht davon aus, dass Eigenschaften fehlen, nur weil die Marketingseite die Schnittstelle als „RESTful“ bezeichnet.

SOAP: Austausch von Nachrichten nach expliziten Verarbeitungsregeln

Eine SOAP-Integration beginnt mit dem Nachrichten-Framework. Der SOAP-Envelope verwendet XML, definiert, wo der Nachrichteninhalt hingehört, und legt Verarbeitungsregeln fest, einschließlich strukturierter Fehlermeldungen. Die SOAP-1.2-Spezifikation bietet zudem ein Erweiterungs-Framework und ein Bindungsmodell.

Stellen Sie sich für den hypothetischen Katalog eine vom Lieferanten definierte Bestandsnachricht mit einer Produktkennung und einem Lagerbereich vor. Ihr Client muss die dokumentierte Nachricht erstellen und interpretieren, anstatt ihre Bedeutung aus einer visuellen Seite abzuleiten. Der genaue Namensraum, die Pflichtfelder und die unterstützte SOAP-Version sind Teil des Vertrags des Anbieters.

Gehen Sie nicht davon aus, dass SOAP immer Remote Procedure Calls (RPC) bedeutet. Es kann auch dokumentorientierte Nachrichten übertragen. Ebenso sollten Sie Signaturen, Verschlüsselung, zuverlässige Zustellung oder Transaktionskoordination nicht allein dem Envelope zuschreiben. Eine Bereitstellung kann zusätzliche Spezifikationen verwenden, aber der Anbieter muss angeben, welche Profile und welches Verhalten er unterstützt.

Die wichtigste Frage bei der Implementierung ist oft die Kompatibilität der Tools. Besorgen Sie sich die Dienstbeschreibung und die Schemata und überprüfen Sie anschließend, ob ein gepflegter Client in Ihrer Infrastruktur die relevanten Versionen und Erweiterungen unterstützt. Generierter Code kann den Aufwand für die Serialisierung verringern, lässt jedoch geschäftliche Details ungelöst, beispielsweise was eine ausgelassene Menge bedeutet.

Vermeiden Sie beim Vergleich von API-Stilen die Behauptung, dass SOAP automatisch langsamer oder sicherer sei. Die Struktur der Nutzdaten ist ein Kostenfaktor; auch die Operation, der Netzwerkpfad und die Service-Implementierung spielen eine Rolle. Die Sicherheit hängt von den gewählten Mechanismen und der korrekten Autorisierung ab, nicht vom Vorhandensein von XML.

Für einen Lieferanten, der bereits SOAP verlangt, ist möglicherweise ein kleiner Adapter die sinnvollste Lösung, der geprüfte Nachrichten in Ihr internes Katalogschema übersetzt. Der Vergleich zwischen REST und SOAP erläutert, wie Sie das tatsächliche Vertrags- und Fehlerbehebungsverhalten bewerten können, bevor Sie entscheiden, ob eine alternative Schnittstelle die Integration verbessern würde.

GraphQL: Anforderung eines maßgeschneiderten Ergebnisses aus einem typisierten Schema

Mit GraphQL kann ein Client ein angefordertes Ergebnis anhand einer schemadirekt definierten Auswahl beschreiben. Im Katalogbeispiel könnte ein Verbraucher den Namen eines Produkts und ausgewählte Bestandsfelder anfordern, während nicht relevante Beschreibungsfelder aus dieser Operation ausgeklammert werden. Der Server bestimmt weiterhin, welche Felder vorhanden sind und wie deren Werte ermittelt werden.

Die GraphQL-Spezifikation definiert das Typsystem, die Operationssprache, die Ausführung und die Antwortstruktur. Sie umfasst Abfrage-, Mutations- und Abonnementoperationen. GraphQL schreibt an sich weder ein Datenbankdesign vor noch sorgt es dafür, dass jeder Resolver effizient ist.

Für einen Abfrager ist die relevante Frage, ob das Schema genau die benötigten Daten und Beziehungen bereitstellt. Durch die Feldauswahl lässt sich die angeforderte Ausgabe explizit machen. Dies garantiert jedoch nicht, dass der Server weniger Arbeit leistet als bei einer anderen Schnittstelle oder dass eine große, verschachtelte Operation ressourcenschonend ist. Messen Sie die vom Anbieter zugelassenen Operationen, anstatt Rückschlüsse aus der Form der Syntax zu ziehen.

Prüfen Sie Fehler und Nullbarkeit sorgfältig. Ein GraphQL-Ergebnis kann sowohl Daten als auch Fehler enthalten; wenn Sie also das gesamte Ergebnis akzeptieren, nur weil eine Übertragungsanfrage abgeschlossen wurde, kann ein teilweiser Fehler übersehen werden. Legen Sie fest, welche Felder für einen akzeptierten Datensatz erforderlich sind und ob Teil-Daten beibehalten, erneut abgefragt oder in Quarantäne gestellt werden sollen.

Auch die Paginierung bleibt Teil der Anwendungsvereinbarung. Machen Sie sich mit den Argumenten des Anbieters, der Bedeutung des Cursors, den Seitengrenzen und den Abschlussindikatoren vertraut. Gehen Sie nicht davon aus, dass jede GraphQL-API dasselbe Verbindungsmuster offenlegt oder dass sich ein Cursor aus einer Seitenzahl konstruieren lässt.

API-Stile machen Entscheidungen zur Zugriffskontrolle nicht überflüssig. Ein im Schema aufgeführtes Feld bedeutet nicht, dass Ihr Konto jede Instanz davon abrufen darf. Testen Sie für den Katalog eine kleine zulässige Abfrage, überprüfen Sie die Bedeutung jedes ausgewählten Feldes und bewahren Sie die Versionsnummer der Operation in Ihrer Extraktionslogik auf. Dadurch lässt sich eine spätere Schemaänderung leichter von einer vorübergehenden Datenlücke unterscheiden.

RPC: Aufruf einer benannten Operation über ein Netzwerk

Remote-Procedure-Call-Modelle stellen eine Schnittstelle in Form von benannten Operationen sowie deren Ein- und Ausgängen dar. Im Katalogszenario könnte eine Operation den verfügbaren Lagerbestand für ein Produkt und ein Lager berechnen. Im Mittelpunkt der Schnittstelle stehen die Aktion und ihr Vertrag, anstatt so zu tun, als sei jede Domäneninteraktion ein einfacher Abruf von Datensätzen.

RPC ist ein weit gefasstes Modell und kein einzelnes Serialisierungsformat. gRPC ist ein konkretes Framework mit Dienstdefinitionen, generiertem Client-Code und Unterstützung für unäre und Streaming-Methoden. Die Dokumentation zu seinen Kernkonzepten erläutert diese Muster und die Rolle von Deadlines.

Generierte Client-Methoden können den Integrationscode prägnant gestalten. Sie können zudem den Zeitpunkt verbergen, zu dem die Ausführung eine Netzwerkgrenze überschreitet. Das Remote-System kann die Arbeit möglicherweise erst nach Ablauf der Frist des Aufrufers abschließen, oder der Aufrufer kann fehlschlagen, bevor er ein Ergebnis erhält. Behandeln Sie diese Ergebnisse als Teil des Vertrags, auch wenn der Quellcode einem lokalen Funktionsaufruf ähnelt.

Entscheiden Sie bei einer Leseoperation, ob ein weiterer Versuch akzeptabel ist und ob das Ergebnis einen Beobachtungszeitstempel benötigt. Verlangen Sie für eine Operation, die Bestände reserviert, einen dokumentierten Mechanismus zur Vermeidung von Duplikaten oder zur Abstimmung. Eine praktische Client-Methode verspricht keine „Exactly-Once“-Geschäftsausführung.

Vergleichen Sie API-Stile unter Berücksichtigung des gesamten Bereitstellungspfads. Vergewissern Sie sich, dass Ihre Laufzeitumgebung, Ihr Gateway, Ihre Observability-Tools und der gewählte Client das Protokoll und die Operationstypen des Anbieters unterstützen. Eine Streaming-Operation benötigt zudem eine Richtlinie für die Wiederherstellung der Verbindung und zur Identifizierung der Ergebnisse, die vor dem Verbindungsabbruch akzeptiert wurden.

Für das Katalogteam kann RPC eine geeignete interne Grenze für einen Berechnungsdienst sein, während eine andere öffentliche Schnittstelle die Ergebnisse bereitstellt. Diese Kombination ist kein Widerspruch. Halten Sie den internen Vorgangskontrakt von der externen Darstellung getrennt, damit eine Änderung in einem Bereich nicht stillschweigend neu definiert, was nachgelagerte Verbraucher unter einem Bestandswert verstehen.

Webhooks: Ereignisse empfangen, anstatt wiederholt abzufragen

Ein Webhook verändert, wer die Übermittlung initiiert. Ein Anbieter sendet eine ereignisbezogene Anfrage an einen von Ihnen betriebenen Endpunkt, nachdem ein abonniertes Ereignis eingetreten ist. Für den hypothetischen Katalog kann eine Benachrichtigung über eine Produktänderung Ihrem System mitteilen, dass ein Artikel möglicherweise aktualisiert werden muss. Die Webhook-Dokumentation von GitHub bietet ein konkretes Beispiel für einen Anbieter dieses ereignisgesteuerten Musters.

Webhooks sind kein vollständiger Ersatz für eine Abfrageschnittstelle. Eine Benachrichtigung kann den vollständigen relevanten Datensatz, nur geänderte Felder oder eine Kennung enthalten, die Ihr Verbraucher separat abrufen muss. Klären Sie, welche Interpretation zutrifft, bevor Sie entscheiden, dass die Ereignisdaten Ihr gespeichertes Produkt direkt ersetzen können.

Zustellungsgarantien sind Teil des Anbietervertrags. Stellen Sie fest, ob Wiederholungsversuche erfolgen, wie fehlgeschlagene Zustellungen überprüft werden, ob Ereignisse stabile Identifikatoren haben und wie die Reihenfolge beschrieben wird. Entwerfen Sie eine Behandlung von Duplikaten, falls das dokumentierte Zustellungsverhalten dies erfordert. Gehen Sie nicht davon aus, dass eine automatische erneute Zustellung erfolgt, nur weil ein anderer Anbieter dies anbietet.

Der empfangende Endpunkt hat seine eigene Aufgabe. Überprüfen Sie die Anfrage mithilfe des vom Anbieter dokumentierten Mechanismus, validieren Sie den Ereignistyp und die Nutzdaten und trennen Sie die Annahme einer Zustellung vom Abschluss der nachgelagerten Verarbeitung. Wenn Sie eine Bestätigung vor der dauerhaften Aufzeichnung des Ereignisses geben, kann ein späterer Systemabsturz dazu führen, dass keine lokalen Nachweise für die Arbeit vorhanden sind, die der Absender als zugestellt betrachtet.

API-Stile können sich hier ergänzen. Eine Katalog-API kann den anfänglichen Datensatz und einen Wiederherstellungs-Lesevorgang bereitstellen, während Webhooks selektive Aktualisierungen auslösen. Nach einem Ausfall kann im Rahmen der Abgleichung der aktuelle Quellzustand mit gespeicherten Beobachtungen verglichen werden, anstatt davon auszugehen, dass der Benachrichtigungsstrom vollständig war.

Behandeln Sie die Ereigniszeit, die Empfangszeit und die Aktualisierungszeit als unterschiedliche Werte, wenn diese für die Verbraucher von Bedeutung sind. Sie beschreiben verschiedene Zeitpunkte. Der Leitfaden zum automatisierten Web-Scraping-Workflow geht näher auf dauerhafte Verarbeitung und Jobverantwortung ein – Aspekte, die unabhängig davon wichtig bleiben, ob neue Aufgaben mit einem Zeitplan oder einer eingehenden Benachrichtigung beginnen.

Wählen Sie eine Kombination aus Ausfall- und Wiederherstellungsstrategien

Schreiben Sie drei Ausfallszenarien auf, bevor Sie sich für einen API-Stil entscheiden: Eine Anfrage läuft ab, ein Feld ist nicht mehr verfügbar und Ihr Collector ist offline, während sich die Quelle ändert. Fragen Sie sich dann, wie die vorgeschlagene Schnittstelle es Ihnen ermöglicht, jedes Szenario zu erkennen und sich davon zu erholen. Ein Design, das nur dann elegant wirkt, wenn jede Nachricht erfolgreich ist, ist unvollständig.

Anforderung

Nützliche Frage an den Anbieter oder Entwickler

Aktuellen Status abrufen

Wodurch wird ein Datensatz identifiziert, und wie wird seine Darstellung interpretiert?

Ein eng gefasstes Ergebnis abfragen

Kann der Verbraucher Felder auswählen, und wie werden die Abfragekosten gesteuert?

Geschäftsprozesse aufrufen

Was geschieht, wenn das Ergebnis ungewiss ist oder die Anfrage wiederholt wird?

Änderungen empfangen

Wie lauten die Regeln für Bereitstellung, Reihenfolge, Überprüfung und Wiederherstellung?

Wiederherstellung nach einem Ausfall

Gibt es einen unterstützten vollständigen Lesevorgang, Checkpoint oder Abgleichprozess?

Ein und dieselbe Geschäftsfunktion kann mehr als einen Ansatz unterstützen. Ihr Katalog könnte Ressourcenlesungen für den aktuellen Zustand, Webhooks für Änderungssignale und eine RPC-Operation innerhalb des Dienstes nutzen. Der Kompromiss besteht darin, mehrere klare Verträge aufrechtzuerhalten, anstatt davon auszugehen, dass eine einzige Bezeichnung das gesamte System erklärt.

Behalten Sie bei HTTP-basierten Interaktionen die Standardsemantik bei, wenn Sie Wiederholungsversuche und anderes gemeinsames Verhalten implementieren. Die HTTP-Semantik definiert Konzepte wie sichere und idempotente Methoden; eine anwendungsspezifische Operation benötigt dennoch eine explizite Erläuterung ihrer geschäftlichen Auswirkungen.

Schließen Sie mit einer kurzen Entscheidungsaufzeichnung ab: dem erforderlichen Ergebnis für den Verbraucher, den ausgewählten Schnittstellen, den verifizierten Garantien und den ungelösten Abhängigkeiten. Fügen Sie den Test ein, der eine fehlerhafte Annahme aufdeckt. Spielen Sie beispielsweise eine zulässige Übermittlung nach und stellen Sie sicher, dass sie keine bereits akzeptierte Arbeit dupliziert, oder unterbrechen Sie einen Lesevorgang und überprüfen Sie das Checkpoint-Verhalten.

Der Zweck des Vergleichs von API-Stilen besteht darin, diese Entscheidungen sichtbar zu machen. Es ist nicht notwendig, jede Interaktion in eine Kategorie zu zwängen, wenn eine dokumentierte Kombination besser zum tatsächlichen Lebenszyklus der Sammlung passt.

Wichtige Erkenntnisse

  • Trennen Sie die Kategorien, bevor Sie API-Stile vergleichen: REST schränkt die Architektur ein, SOAP strukturiert Nachrichten, GraphQL gestaltet Abfragen, RPC benennt Operationen und Webhooks liefern Ereignisse.
  • Fordern Sie Nachweise für den tatsächlichen Vertrag an, einschließlich Fehlern, Versionen, Zugriffsregeln und Wiederherstellung, anstatt Garantien aus einer Bezeichnung zu übernehmen.
  • Behandeln Sie unvollständige Daten, ungewisse Ergebnisse, doppelte Übermittlungen und versäumte Benachrichtigungen als explizite Integrationsszenarien mit beobachtbaren Ergebnissen.
  • Kombinieren Sie Ansätze, wenn sie unterschiedlichen Anforderungen dienen, und wahren Sie dabei klare Grenzen zwischen öffentlichen Darstellungen und internen Abläufen.

FAQ

Wer sollte für einen API-Kompatibilitätstest verantwortlich sein?

Bestimmen Sie im nutzenden Team einen Verantwortlichen, der unerwartete Vertragsänderungen erkennen und an den Anbieter weiterleiten kann. Der Test sollte einen kleinen, genehmigten Eingabewert und dessen erwartetes Geschäftsergebnis beibehalten. Halten Sie die Verantwortlichkeiten sichtbar, auch wenn sich Mitarbeiter oder Lieferanten ändern, damit eine fehlgeschlagene Prüfung nicht zu einer ignorierten Warnung wird.

Können alte und neue API-Versionen parallel laufen?

Ja, wenn der Anbieter diesen Übergang bewusst unterstützt. Erkundigen Sie sich, welche Nutzer welche Version verwenden, wie lange die Überschneidungsphase andauern wird und welche Änderungen eine Migration erfordern. Testen Sie beide Versionen anhand repräsentativer Ergebnisse, bevor Sie den Datenverkehr umleiten. Eine Koexistenzphase ist nur dann sinnvoll, wenn die Supportverpflichtungen und Auslaufbedingungen klar definiert sind.

Kann ein SDK den Schnittstellenstil vollständig verbergen?

Es kann die routinemäßige Nachrichtenerstellung verbergen, aber es kann die operativen Konsequenzen der Schnittstelle nicht beseitigen. Sie müssen weiterhin Timeouts, Wiederholungsversuche, Teilergebnisse und Kompatibilität verstehen. Behalten Sie den Zugriff auf nützliche Anfrage-Identifikatoren und bereinigte Diagnosedaten bei, damit ein praktischer Wrapper nicht zum Hindernis wird, wenn der zugrunde liegende Dienst ausfällt.

Fazit

Der beste nächste Schritt besteht darin, eine reale Datenanforderung heranzuziehen und diese in der Dokumentation des Anbieters nachzuverfolgen. Identifizieren Sie die Anfrage oder das Ereignis, das diese liefert, die Felder, die die Bedeutung festlegen, und den Nachweis, dass die Erfassung erfolgreich abgeschlossen wurde. Verfolgen Sie dann denselben Pfad mit einem absichtlich herbeigeführten Fehler in einer zugelassenen Testumgebung.

API-Stile helfen Ihnen bei der Organisation dieser Überprüfung, ersetzen sie jedoch nicht. Eine Ressourcenschnittstelle mit unklarer Paginierung kann schwierig zu handhaben sein; eine operationsorientierte Schnittstelle mit einem präzisen Wiederherstellungsvertrag kann hingegen unkompliziert sein. Bevorzugen Sie explizites Verhalten und gepflegte Tools gegenüber Annahmen darüber, was eine Kategorie bereitstellen sollte.

Falls erforderliche Informationen nur über Webseiten verfügbar sind, ziehen Sie die Scraper-API von WebScrapingAPI als zusätzliche Erfassungsquelle in Betracht. Unterziehen Sie deren Ausgabe denselben internen Validierungs- und Herkunftsregeln wie Ihre anderen Quellen, damit Ihre Pipeline auch bei sich ändernden Eingaben nachvollziehbar bleibt.

Über den Autor

Robert Munceanu, Full-Stack-Entwickler @ WebScrapingAPI

Robert Munceanu

Full-Stack-Entwickler

Robert Munceanu ist Full-Stack-Entwickler bei WebScrapingAPI, wo er in allen Bereichen des Produkts mitwirkt und an der Entwicklung zuverlässiger Tools und Funktionen zur Unterstützung der Plattform mitwirkt.

Nodriver-Python-Tutorial: Unauffälliges Web-Scraping – vom ersten Skript bis zur Produktion
Die Wissenschaft des Web-Scrapings

Nodriver-Python-Tutorial: Unauffälliges Web-Scraping – vom ersten Skript bis zur Produktion

TL;DR: Kurzfassung: Nodriver ist eine asynchrone Python-Bibliothek, die Chromium über das Chrome DevTools Protocol steuert, ohne Selenium oder chromedriver-Binary. Nutzen Sie sie, wenn ein selbst gehosteter Stealth-Browser, der einer echten Chrome-Sitzung näherkommt, besser passt als ein WebDriver-Stack – aber sie beseitigt IP-, TLS- oder Verhaltensrisiken nicht von allein. Dieses Tutorial führt vom ersten Skript bis zur containerisierten Produktion und einer gehosteten Browser API.

Suciu Dan12 min read
Artikel lesen
Umgang mit Google-/goto-Weiterleitungs-URLs und CAES-Token in einem SERP-Scraper
Die Wissenschaft des Web-Scrapings

Umgang mit Google-/goto-Weiterleitungs-URLs und CAES-Token in einem SERP-Scraper

TL;DR: Kurzfassung: Google-/goto-URLs mit CAES-Token und ältere /url-Wrapper sind Weiterleitungsschichten, keine Ziele; ein SERP-Scraper, der jede href als endgültig behandelt, verfälscht Rank-Tracking und Link-Datenbanken. Bevorzugen Sie eine strukturierte SERP-API, wenn sie Ziel-Links liefert. Wenn Sie HTML parsen müssen, klassifizieren Sie jede href, deduplizieren Sie Weiterleitungen und lösen Sie sie mit einem einfachen GET auf. Entschlüsseln Sie CAES nicht.

Suciu Dan11 min read
Artikel lesen
HTTP-Antwort-Header in cURL: Jedes Flag, jede Technik und jedes Skripting-Rezept
Die Wissenschaft des Web-Scrapings

HTTP-Antwort-Header in cURL: Jedes Flag, jede Technik und jedes Skripting-Rezept

TL;DR: cURL verbirgt standardmäßig Antwort-Header. Verwenden Sie -i, um Header neben dem Body zu sehen, -I für eine HEAD-Anfrage, die nur Header zurückgibt, -v für vollständiges Debugging von Anfrage und Antwort und -D, um Header in einer Datei zu speichern. Für modernes Scripting können Sie mit cURL 7.83+ einzelne Header extrahieren oder mit der Option -w write-out alle Header als JSON ausgeben.

Suciu Dan11 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.