Zum Inhalt springen

Autorprofil

Gabriel Cioci

Full-Stack-Entwickler12 Artikel

Gabriel Cioci ist Full-Stack-Entwickler bei WebScrapingAPI und verantwortlich für die Entwicklung und Wartung der Websites, des Benutzerportals sowie der wichtigsten benutzerseitigen Komponenten der Plattform.

Gabriel Cioci, Full-Stack-Entwickler @ WebScrapingAPI

Veröffentlichte Artikel

12 Artikel

browser automationsearch data extractione-commerce data extractionnews and media monitoringScience of Web ScrapingGuidesUse CasesEngineering

Veröffentlichte Artikel

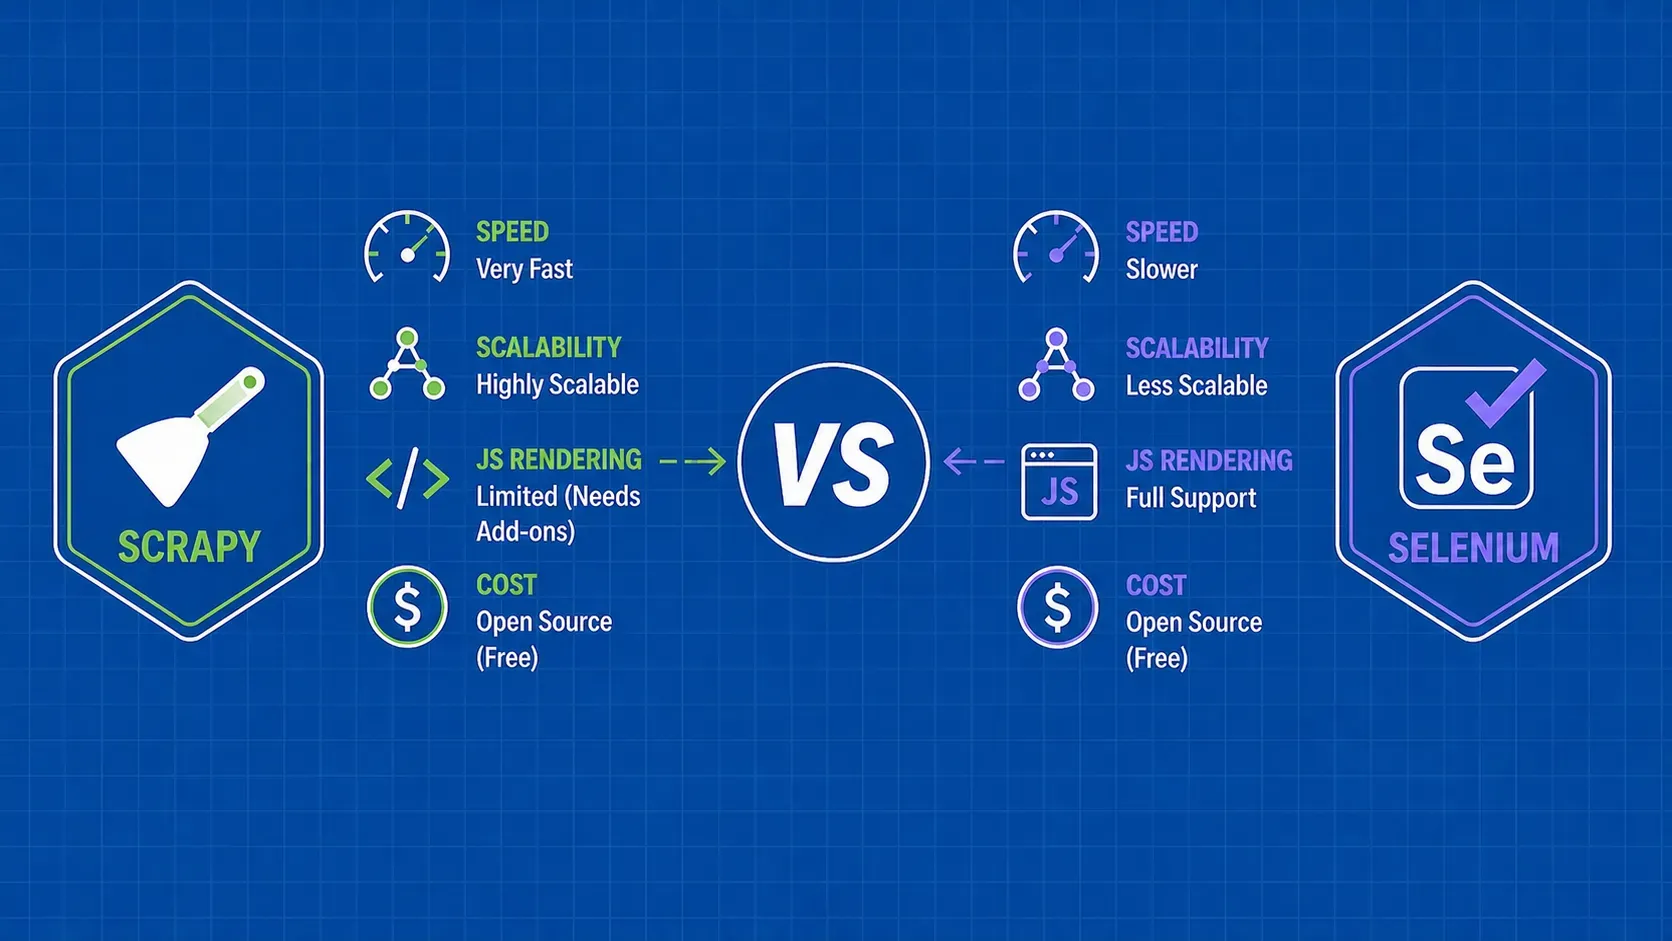
Scrapy gegen Selenium: Wer gewinnt?
Die Wissenschaft des Web-Scrapings

Scrapy gegen Selenium: Wer gewinnt?

TL;DR: Scrapy ist ein schnelles, asynchrones Crawling-Framework, das für die Extraktion strukturierter Daten aus statischen Seiten in großem Umfang entwickelt wurde. Selenium automatisiert echte Browser und bewältigt JavaScript-lastige Seiten, allerdings mit einem viel höheren Ressourcenaufwand. Für die meisten Scraping-Projekte ist es von Vorteil, wenn man weiß, wann man die beiden Systeme einsetzen oder kombinieren sollte.

Gabriel Cioci9 min read
Artikel lesen
Die besten Job Scraping Tools im Jahr 2026: Vergleich & Leitfaden
Anleitungen

Die besten Job Scraping Tools im Jahr 2026: Vergleich & Leitfaden

TL;DR: Job-Scraping-Tools reichen von leichtgewichtigen API-Diensten und Open-Source-Browser-Automatisierung bis zu KI-gestützten Extraktoren und visuellen No-Code-Plattformen. Dieser Leitfaden vergleicht die besten Job-Scraping-Tools für Google Jobs, Indeed, Monster, Upwork und Freelance-Marktplätze und führt Sie dann durch den Aufbau einer zuverlässigen Pipeline mit Deduplizierung, Zeitplanung und Anti-Bot-Behandlung, damit Sie beginnen können, saubere Jobdaten in großem Umfang zu sammeln.

Gabriel Cioci15 min read
Artikel lesen
Dateien mit Python herunterladen: Das Praxis-Playbook
Anleitungen

Dateien mit Python herunterladen: Das Praxis-Playbook

TL;DR: So laden Sie Dateien mit Python per urllib, requests und aiohttp herunter: Streaming, Fortschrittsbalken, parallele und asynchrone Downloads, Retries und Authentifizierung.

Gabriel Cioci15 min read
Artikel lesen
Premium-Proxy-Liste 2026: Die 9 besten kostenpflichtigen Proxy-Dienste im Ranking
Die Wissenschaft des Web-Scrapings

Premium-Proxy-Liste 2026: Die 9 besten kostenpflichtigen Proxy-Dienste im Ranking

TL;DR: Kurzfassung: Für die meisten Scraping-Teams sind Oxylabs und Decodo die stärksten Allround-Premium-Proxy-Dienste, Bright Data passt zu Enterprise-Budgets, und Webshare ist der günstigste Einstieg mit einer statischen Liste. Wählen Sie eine statische Liste, wenn die IPs für die Mietdauer Ihnen gehören sollen, und ein rotierendes Gateway, wenn jede Anfrage oder Sitzung über eine andere IP laufen soll.

Gabriel Cioci23 min read
Artikel lesen
HTTP-Cookies: Ein Leitfaden für Entwickler zum Auslesen von Sitzungen
Anleitungen

HTTP-Cookies: Ein Leitfaden für Entwickler zum Auslesen von Sitzungen

TL;DR: Erfahren Sie, wie sich Cookie-Speicher, Browsereinstellungen und die Zuordnung von Sitzungen auf die erfassten Antworten auswirken. Lernen Sie, Authentifizierungsfehler zu diagnostizieren, ohne Anmeldedaten preiszugeben.

Gabriel Cioci12 min read
Artikel lesen
Octoparse-Alternative: Vergleichen Sie die von Ihnen entwickelten Lösungen
Anleitungen

Octoparse-Alternative: Vergleichen Sie die von Ihnen entwickelten Lösungen

TL;DR: Vergleichen Sie Web Scraper, Browse AI, Apify und Scrapy anhand der verbleibenden Arbeitsleistung. Führen Sie einen kontrollierten Reparaturfähigkeitstest durch und überprüfen Sie die vollständige Lieferung, bevor Sie Octoparse ersetzen.

Gabriel Cioci14 min read
Artikel lesen
So extrahieren Sie Daten von eBay-Seiten für Preisanalysen
Anleitungen

So extrahieren Sie Daten von eBay-Seiten für Preisanalysen

TL;DR: Bei neuen Produkten ist es schwierig, den richtigen Preis festzulegen. Nun, es gibt eine Lösung: Sammeln Sie Daten von E-Commerce-Giganten und legen Sie Preise auf der Grundlage klarer Daten fest

Gabriel Cioci4 min read
Artikel lesen
Web Scrape mit Puppeteer und NodeJS 2026 Anleitung
Anleitungen

Web Scrape mit Puppeteer und NodeJS 2026 Anleitung

TL;DR: Puppeteer gibt Ihnen die volle Kontrolle über eine Headless-Chrome-Instanz von Node.js aus und ist damit das Tool der Wahl für das Scraping von JavaScript-gerenderten Seiten. Dieser Leitfaden führt Sie durch die Installation, die selektorbasierte Extraktion, das unendliche Scrollen, die Formularanmeldung, das Abfangen von Anfragen, Stealth-Plugins, den Export strukturierter Daten und die Docker-Bereitstellung, damit Sie von einem Spielzeug-Skript zu einem produktionsfähigen Scraper werden.

Gabriel Cioci15 min read
Artikel lesen
Web-Scraping für SEO: Erstellen Sie ein evidenzbasiertes Audit
Anwendungsfälle

Web-Scraping für SEO: Erstellen Sie ein evidenzbasiertes Audit

TL;DR: Erstellen Sie ein fundiertes SEO-Audit, bei dem die auf der Seite festgestellten Fakten von den Suchmaschinenergebnissen getrennt werden. Vergleichen Sie Darstellungsweise, kanonische Signale, Anweisungen und Fehler in den Vorlagen.

Gabriel Cioci14 min read
Artikel lesen
REST-API vs. SOAP-API: Die Wahl hängt von Vertrag und Verhalten ab
Technik

REST-API vs. SOAP-API: Die Wahl hängt von Vertrag und Verhalten ab

TL;DR: Wählen Sie eine Integration anhand ihres tatsächlichen Vertrags, ihres Sicherheitsprofils, ihrer Tools und ihres Wiederherstellungsverhaltens aus. Trennen Sie die REST-Architektur vom SOAP-Messaging und hinterfragen Sie gängige Mythen.

Gabriel Cioci13 min read
Artikel lesen
Daten aus APIs extrahieren: Eine zuverlässige erste Pipeline
Technik

Daten aus APIs extrahieren: Eine zuverlässige erste Pipeline

TL;DR: Erstellen Sie einen Workflow zur API-Extraktion, der Datensätze validiert, Fortsetzungstoken verfolgt und unvollständige Durchläufe meldet. Üben Sie zunächst mit einer lokalen Testumgebung, bevor Sie einen Live-Dienst nutzen.

Gabriel Cioci12 min read
Artikel lesen
Die besten Web Scraping Tools des Jahres 2026
Die Wissenschaft des Web-Scrapings

Die besten Web Scraping Tools des Jahres 2026

TL;DR: Die besten Web-Scraping-Tools des Jahres 2026 lassen sich in drei Kategorien einteilen: verwaltete APIs, die Proxys, Headless-Browser und CAPTCHAs hinter einem HTTP-Aufruf verstecken; Open-Source-Frameworks wie Scrapy und Crawlee, die Ihnen die volle Kontrolle geben, wenn Sie sie hosten können; und visuelle Scraper ohne Code für Nicht-Entwickler. Es gibt keinen einzigen Gewinner. Wir vergleichen mehr als 22 Optionen in Bezug auf Preismodelle, JavaScript-Rendering, Anti-Bot-Stärke und ideale Anwendungsfälle, damit Sie zwei oder drei in die engere Wahl nehmen können, um sie mit Ihren tatsächlichen Zielseiten zu testen.

Gabriel Cioci47 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.