TL;DR: Web-Scraping für SEO wandelt eine autorisierte Auswahl von Seiten in Belege zu Vorlagen, Links und technischen Vorgaben um. Vergleichen Sie, was Ihr Server sendet, mit dem, was Ihr Browser anzeigt, und überprüfen Sie dann vermutete Probleme anhand der Dokumentation der Suchmaschinen und des beabsichtigten Verhaltens Ihrer Website.
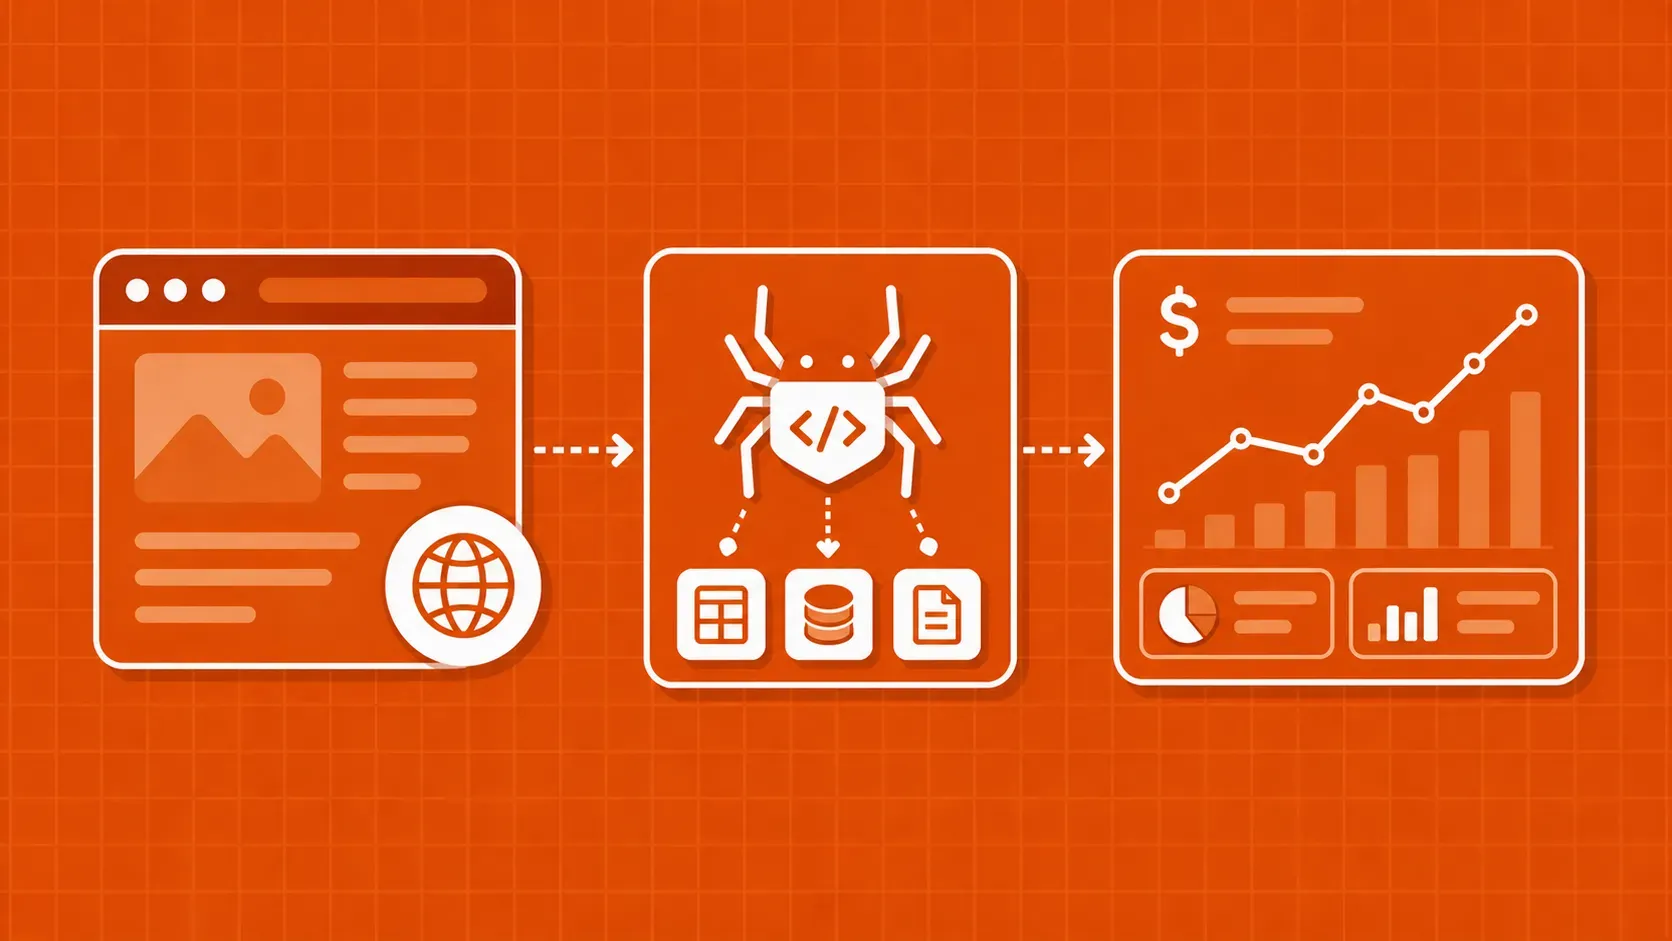
Ein Audit meldet, dass Hunderte von Seiten keine Beschreibung haben, doch der Browser zeigt auf jeder Seite eine Beschreibung an. Web-Scraping für SEO ist das Sammeln von Webseiten-Nachweisen für suchbezogene Analysen, und die erste Frage in dieser Situation lautet: Welche Darstellung hat das Audit tatsächlich ausgelesen? Ein Response-Parser und ein gerenderter Browser können unterschiedliche Dokumente anzeigen, ohne dass eines der beiden Tools fehlerhaft ist.
Das nützliche Ergebnis ist ein reproduzierbarer Befund: eine definierte Gruppe von URLs, die beobachteten Daten, das beabsichtigte Verhalten und eine verifizierte Korrektur. Eine lange Tabelle mit Markierungen ist nicht automatisch ein nützliches Audit, und eine technisch sauberere Website ist keine Garantie für bessere Rankings.
Dieser Leitfaden konzentriert sich auf Websites, die Ihnen gehören oder für deren Audit Sie autorisiert sind. Er erklärt, wie Sie den Erfassungsumfang festlegen, ein Nachweisschema entwerfen, den HTML-Response-Code mit der gerenderten Ausgabe vergleichen und kanonische sowie Indexierungssignale interpretieren, ohne Heuristiken in unbegründete Schlussfolgerungen umzuwandeln. Außerdem zeigt er, wie Sie Fehler in Vorlagen priorisieren und nachweisen können, dass eine Korrektur das relevante Verhalten verändert hat.
Nutzen Sie Suchleistungs- und Indizierungstools als separate Beweisquellen, sofern diese verfügbar sind. Ihr Crawler kann eine Antwort und ein DOM beobachten; er kann jedoch nicht jede Entscheidung direkt beobachten, die eine Suchmaschine bezüglich der Indizierung oder des Rankings dieser Seite trifft.