Zum Inhalt springen

Blog

Einblicke & Technik

Ein tiefer Einblick in die Infrastruktur von Webdaten, Extraktionstechniken und die Zukunft strukturierter Daten in großem Maßstab.

Neueste Artikel

156 Artikel

Leitfaden zur SERP-Scraping-API: Google, Bing, DuckDuckGo, Yandex
Anleitungen

Leitfaden zur SERP-Scraping-API: Google, Bing, DuckDuckGo, Yandex

TL;DR: Senden Sie Ihre erste WebScrapingAPI-SERP-API-Anfrage mit dem Schlüssel in einer Umgebungsvariablen, lokalisieren Sie anschließend die Google-Ergebnisse nach Land, Sprache und Gerät, lesen Sie die JSON-Daten von Google und Bing auf sichere Weise aus, extrahieren Sie die HTML-Daten von DuckDuckGo und Yandex selbst, führen Sie asynchrone Google-Jobs aus, versuchen Sie es anhand der dokumentierten Fehlercodes erneut und wählen Sie einen Tarif anhand der Google-Preise vom Oktober 2026 aus.

Suciu Dan21 min read
Artikel lesen
So nutzen Sie die Amazon Scraper API: Schnellstartanleitung
Anleitungen

So nutzen Sie die Amazon Scraper API: Schnellstartanleitung

TL;DR: Erste Schritte mit der Amazon-Scraper-API von WebScrapingAPI: Senden Sie Ihre erste Anfrage, wählen Sie aus neun Anfragetypen (Produkt, Suche, Bestseller, Angebote, Verkäuferbewertungen und mehr), nutzen Sie 20 Amazon-Marktplätze, analysieren Sie jede JSON-Antwort, behandeln Sie Fehler und Wiederholungsversuche und wählen Sie einen Tarif aus.

Robert Sfichi21 min read
Artikel lesen
Scrapy gegen Selenium: Wer gewinnt?
Die Wissenschaft des Web-Scrapings

Scrapy gegen Selenium: Wer gewinnt?

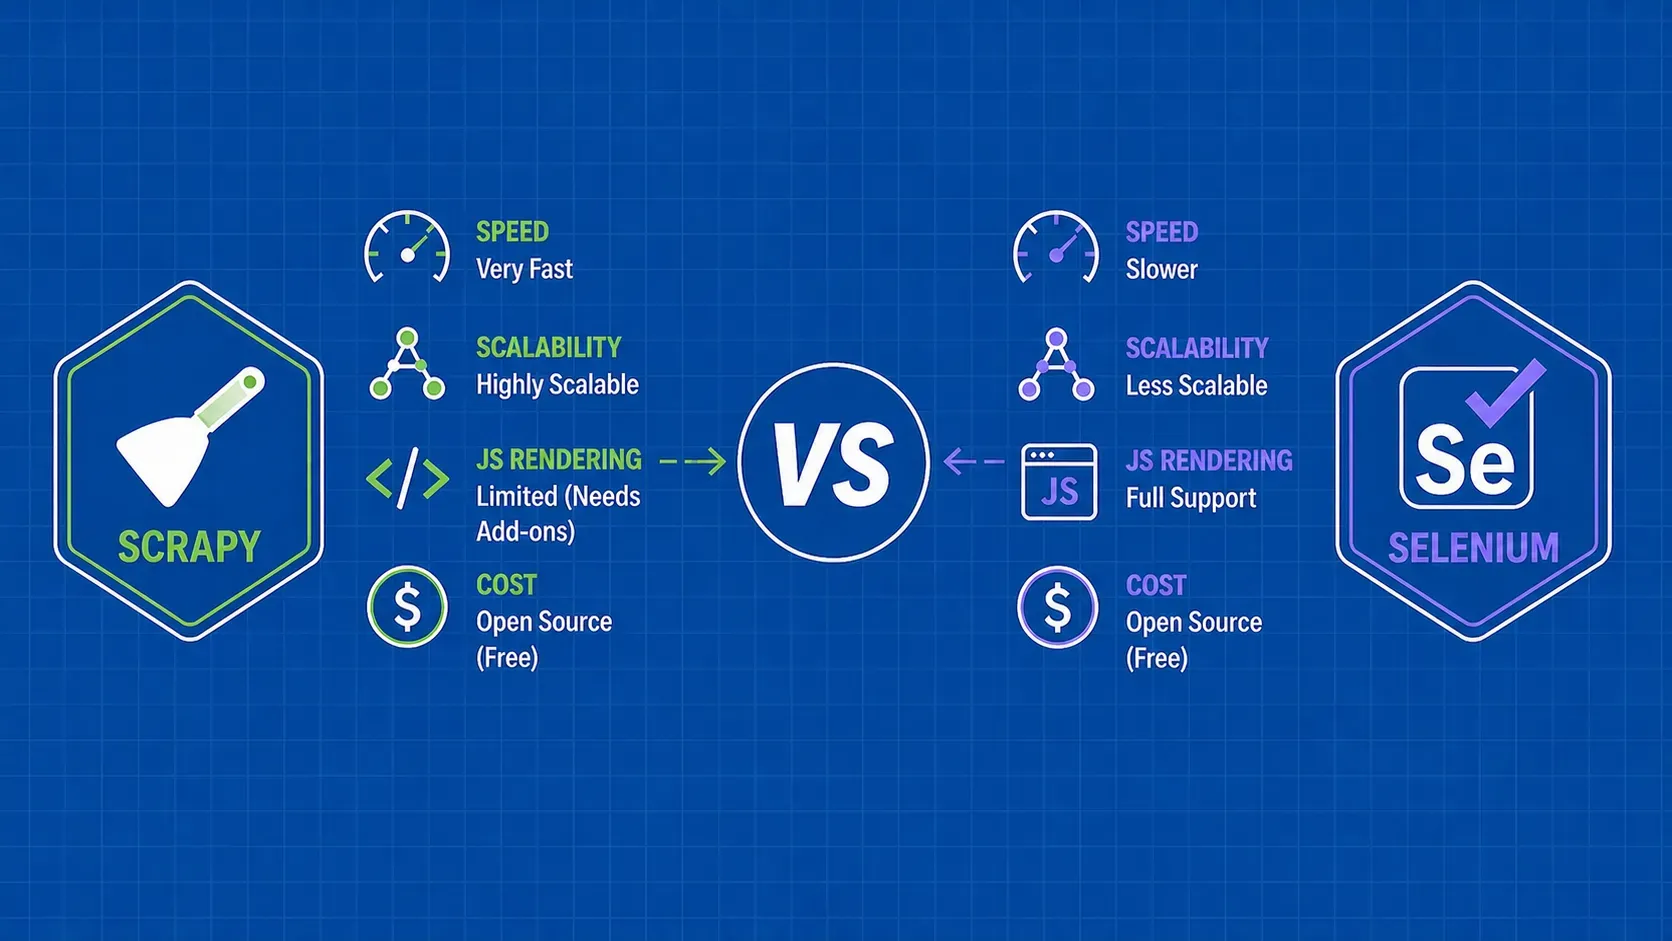
TL;DR: Scrapy ist ein schnelles, asynchrones Crawling-Framework, das für die Extraktion strukturierter Daten aus statischen Seiten in großem Umfang entwickelt wurde. Selenium automatisiert echte Browser und bewältigt JavaScript-lastige Seiten, allerdings mit einem viel höheren Ressourcenaufwand. Für die meisten Scraping-Projekte ist es von Vorteil, wenn man weiß, wann man die beiden Systeme einsetzen oder kombinieren sollte.

Gabriel Cioci9 min read
Artikel lesen
Scrapy gegen Beautiful Soup: Welche Python Scraper zu wählen
Anleitungen

Scrapy gegen Beautiful Soup: Welche Python Scraper zu wählen

TL;DR: Scrapy ist ein vollständiges Crawling-Framework, das Anfragen, Parsing und Datenexport in einem Paket behandelt. Beautiful Soup ist eine leichtgewichtige Parsing-Bibliothek, die Sie mit einem HTTP-Client wie Requests kombinieren. Wählen Sie Scrapy, wenn Sie ein umfangreiches, gleichzeitiges Crawling mit integrierten Pipelines benötigen. Wählen Sie Beautiful Soup, wenn Sie ein schnelles, minimales Setup für das Parsen einer Handvoll Seiten benötigen.

Mihnea-Octavian Manolache10 min read
Artikel lesen
Scrapy Splash Tutorial: JavaScript-Seiten rendern
Anleitungen

Scrapy Splash Tutorial: JavaScript-Seiten rendern

TL;DR: Scrapy Splash verbindet die schnelle Crawling-Engine von Scrapy mit dem Headless-Browser Splash, um JavaScript-lastige Seiten zu rendern. Dieses Scrapy-Splash-Tutorial führt Sie durch die Docker-Einrichtung, die Konfiguration des Scrapy-Projekts, die Grundlagen von SplashRequest, Lua-Skripte zum Scrollen und Klicken, die Proxy-Integration und die Behebung der häufigsten Fehler, auf die Sie stoßen werden.

Ștefan Răcilă11 min read
Artikel lesen
Scrapen von Amazon Produktdaten mit Python: Hands-On Anleitung
Anleitungen

Scrapen von Amazon Produktdaten mit Python: Hands-On Anleitung

TL;DR: Amazon-Produktseiten sind vollgepackt mit wertvollen Daten (Preise, Bewertungen, Rezensionen, ASINs), aber um sie zuverlässig zu extrahieren, braucht es mehr als eine einfache HTTP-Anfrage. Dieser Leitfaden führt Sie durch die Erstellung eines Python-Scrapers mit Requests und BeautifulSoup, die Handhabung von Paginierung und Anti-Bot-Verteidigung, den Export nach CSV oder JSON und die Einspeisung der Ergebnisse in LLM-Workflows. Sie werden auch lernen, wann Sie eine Scraping-API verwenden sollten, anstatt Ihre eigene Lösung zu entwickeln.

Raluca Penciuc15 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.