TL;DR: Web-Scraping für das Content-Marketing sollte Belege liefern, keine kopierten Artikel. Erstellen Sie ein abgegrenztes Quellenverzeichnis, halten Sie fest, was wann beobachtet wurde, und nutzen Sie diese Belege dann, um eine Leserfrage mit einer eigenen Analyse, transparenten Einschränkungen und angemessenen Quellenangaben zu beantworten.
Ihre Entwickler-Zielgruppe fragt immer wieder, wie man Optionen zum Datenexport vergleichen kann. Ein Redakteur wünscht sich einen praktischen Leitfaden, doch der Entwurf der Gliederung ist derzeit nur eine Sammlung von Überschriften der Konkurrenz. Das Sammeln weiterer Überschriften löst das zugrunde liegende Problem nicht: Das Team benötigt Belege für die Entscheidungen, vor denen die Leser tatsächlich stehen.
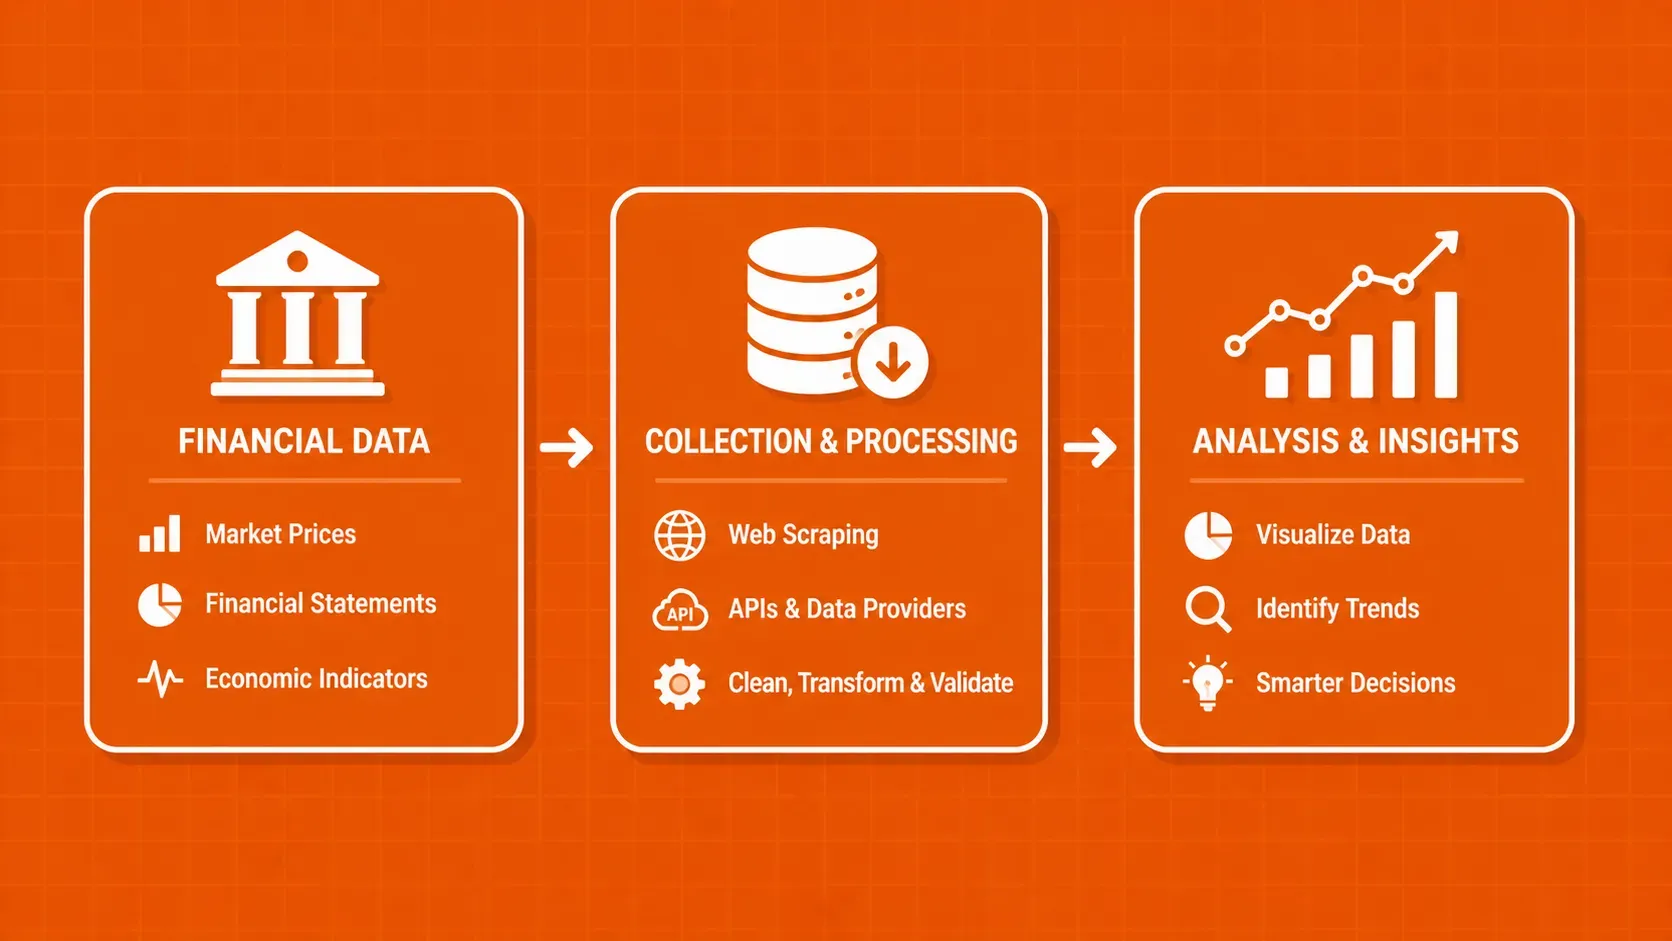
Web-Scraping für das Content-Marketing ist die kontrollierte Extraktion von Web-Informationen zur Unterstützung von Recherche, Planung und evidenzbasierter redaktioneller Arbeit. Ein nützliches Ergebnis könnte ein Bestandsverzeichnis der Produktdokumentation, eine Reihe erklärungswürdiger Änderungen oder ein reproduzierbarer Datensatz für eine eigene Analyse sein. Es sollte keine Maschine zur Wiederveröffentlichung der Arbeiten anderer sein.
Dieser Leitfaden folgt einem hypothetischen Entwickler-Content-Projekt: dem Vergleich, wie eine definierte Gruppe öffentlicher Dokumentationsseiten den Datenexport erläutert. Das Projekt dient der Veranschaulichung; es wird kein marktweiter Anspruch auf eine Studie oder gemessene Ergebnisse erhoben. Der Arbeitsablauf lässt sich gleichermaßen gut auf einen technischen Newsletter, einen forschungsgestützten Leitfaden oder ein internes redaktionelles Planungssystem anwenden.
Das Ziel ist es, dem Leser zu helfen, eine bessere Entscheidung zu treffen. Besucherzahlen, Sichtbarkeit in Suchmaschinen und Zitate mögen messenswerte Ergebnisse sein, doch weder das Sammeln von Daten noch das Formatieren einer Tabelle garantieren diese. Beginnen Sie mit der Frage des Lesers und richten Sie jeden Schritt der Datenerhebung daran aus.