Zum Inhalt springen
Zurück zum Blog

Web Scraping für Leads: eine B2B-Pipeline aufbauen

Robert MunceanuZuletzt aktualisiert am 13 min read
Web Scraping für Leads: eine B2B-Pipeline aufbauen
Kurz gesagt: Web Scraping zur Lead-Generierung verwandelt freigegebene Unternehmenswebsites und Verzeichnisse in strukturierte Account-Daten. Bauen Sie die Pipeline um Unternehmensidentität, Quellennachweise, Aktualität und den Abgleich mit dem CRM herum auf. Behandeln Sie die Erlaubnis, jemanden zu kontaktieren, als eigene Entscheidung, getrennt vom Erfassen eines Unternehmensdatensatzes.

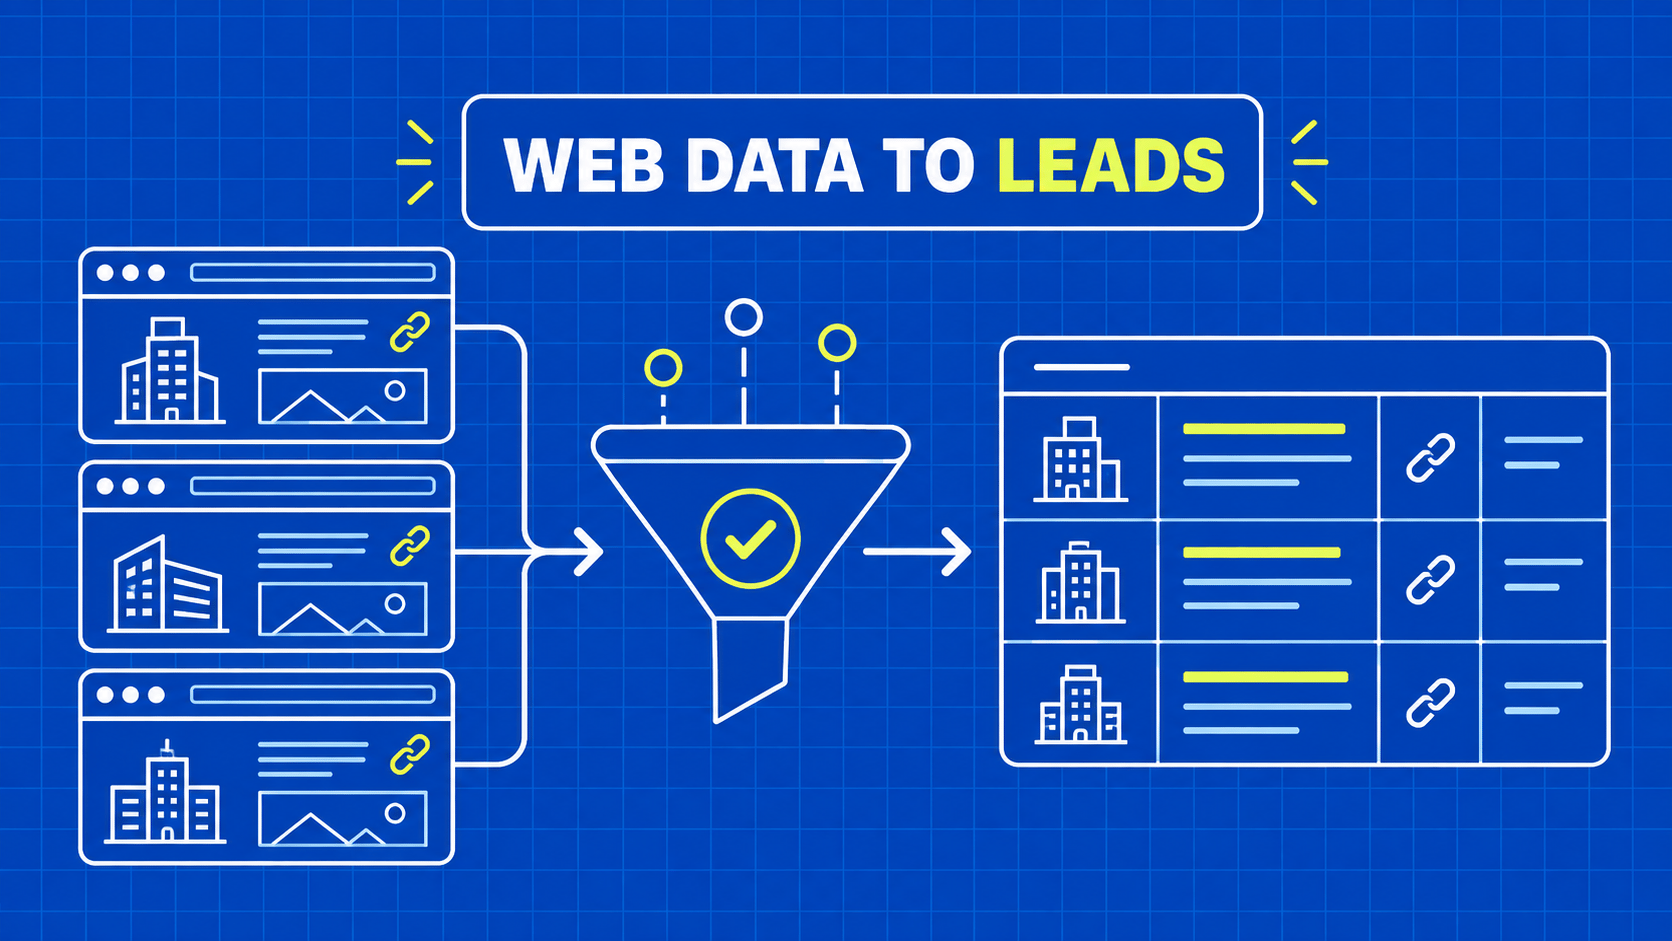
Web Scraping zur Lead-Generierung ist das automatisierte Erfassen von Website-Informationen, um potenzielle Geschäftskunden zu finden und zu bewerten. Ein brauchbares Ergebnis ist ein Unternehmensdatensatz mit verifizierter Domain, relevanten geschäftlichen Merkmalen und Nachweisen, die erklären, warum er in Ihre Vertriebspipeline gehört.

Marktforschung, Wettbewerbsanalyse und Markenüberwachung zählen neben der Lead-Generierung zu den geschäftlichen Anwendungsfällen von Web Scraping.

Nehmen wir zwei Exporte. Der eine enthält Tausende Firmennamen und eine Spalte mit der Überschrift „qualifiziert“. Der andere enthält weniger Accounts, doch jede Zeile nennt die offizielle Website, die angebotene Leistung, den Zeitpunkt, zu dem diese Tatsache beobachtet wurde, und die Quelle hinter der Qualifizierung. Entwickler können den zweiten Export debuggen. Sales Operations kann ihn prüfen. Keines der beiden Teams muss einem rätselhaften Score vertrauen.

Dieser Leitfaden arbeitet auf das zweite Ergebnis hin. Sie definieren den benötigten Account, wählen Quellen aus, extrahieren ein bewusst kleines Schema, normalisieren Identitäten und übergeben geprüfte Datensätze an ein CRM. Die Beispiele konzentrieren sich auf Organisationen und ihre veröffentlichten Geschäftstätigkeiten, nicht auf das massenhafte Sammeln persönlicher Kontaktdaten. Dieselbe Architektur funktioniert, ob Sie mit einem zulässigen Branchenverzeichnis beginnen oder mit einer Liste von Unternehmenswebsites, die Sie bereits pflegen.

Unternehmensseiten auf LinkedIn sind eine solche Quelle. Unser Leitfaden zum Scraping von LinkedIn mit Python zeigt, welche Unternehmensfelder ohne Anmeldung erreichbar sind.

Web Scraping zur Lead-Generierung mit einem Account-Vertrag beginnen

Bevor Sie einen Parser auswählen, schreiben Sie einen Satz, der einen nützlichen Account definiert. Zum Beispiel: „Unabhängige Anbieter industrieller Instandhaltung, die in unseren unterstützten Regionen tätig sind und ausdrücklich Geräteprüfungen anbieten.“ Das ist eine beispielhafte Targeting-Regel, keine Aussage über einen bestimmten Markt.

Jeder Teil sollte sich einem beobachtbaren Nachweis zuordnen lassen. Eine Leistungsseite kann das Prüfkriterium belegen. Eine Standortseite kann die regionale Abdeckung belegen. Ein vager Slogan auf der Startseite kann keines von beiden belegen. Wenn Ihr Geschäft eine Eigenschaft benötigt, die die verfügbaren Quellen nicht offenlegen, markieren Sie sie als unbekannt, statt eine Schätzung zu erfinden.

Trennen Sie drei Fragen, die oft in einem einzigen Lead-Score zusammengefasst werden:

Frage

Ergebnis

Beispielnachweis

Ist das die richtige Organisation?

Aufgelöste Account-Identität

Offizielle Domain, verlinkt aus einem freigegebenen Verzeichnis

Passt sie zu unseren Account-Kriterien?

Fit-Entscheidung mit Begründung

Veröffentlichte Prüfleistung und unterstützter Standort

Dürfen wir sie über diesen Kanal kontaktieren?

Unabhängig geprüfter Outreach-Status

Geltende Richtlinien und dokumentierte Berechtigungen

Diese Ergebnisse sollten sich nicht gegenseitig überstimmen. Ein hervorragender Fit begründet noch keine Outreach-Berechtigung. Ein freigegebener Kontaktkanal macht ein Unternehmen, das nicht zur Zielgruppe gehört, nicht relevant.

Legen Sie Ausschlüsse zusammen mit den Einschlussregeln fest: Bestandskunden, Wettbewerber, nicht unterstützte Standorte, bereits abgelehnte Accounts und Organisationen auf einer Sperrliste. Wenden Sie sie vor einer teuren Anreicherung an und erneut vor dem Export. Diese zweite Prüfung schützt vor Statusänderungen, die während eines laufenden Crawls eintreten.

Ihr Abnahmevertrag sollte außerdem Pflichtfelder und Zuständigkeiten benennen. Legen Sie fest, wer unsichere Zuordnungen klärt, wer neue Quellen freigibt und wer Qualifizierungsregeln ändern darf. Web Scraping zur Lead-Generierung lässt sich leichter betreiben, wenn „bereit zur Prüfung“ eine schriftliche Definition hat, statt davon abzuhängen, welches Skript zuletzt gelaufen ist.

Quellen wählen, die die benötigten Felder liefern

Beginnen Sie mit einem kleinen Quelleninventar. Halten Sie für jede Quelle die Zugriffsmethode, den zulässigen Zweck, die erwarteten Felder, das Aktualisierungsverhalten und die verantwortliche Person fest. Eine dokumentierte API oder ein lizenzierter Export kann einfacher zu pflegen sein als HTML, wenn er dieselbe Anforderung abdeckt.

Nutzen Sie Discovery-Quellen, um Kandidaten zu finden, und Seiten der Organisationen selbst, um relevante Merkmale zu verifizieren. Eine Verzeichniskategorie ist nur ein Hinweis für die Discovery. Die eigene Leistungsseite des Unternehmens ist ein stärkerer Beleg dafür, was es aktuell anbietet. Keine der beiden Quellen beweist eine Kaufabsicht.

Quelle

Nützlicher Beitrag

Wichtige Einschränkung

Freigegebenes Branchenverzeichnis

Kandidatenunternehmen und Kategorien

Einträge können veraltet oder gesponsert sein

Offizielle Unternehmenswebsite

Leistungen, Standorte, offizielle Domain

Aussagen geben die Selbstdarstellung des Unternehmens wieder

Zulässige API eines Unternehmensregisters

Rechtliche Identität und Registerangaben

Die rechtliche Identität kann vom Markennamen abweichen

Bestehende Account-Liste im CRM

Abgleich und Ausschlüsse

Auch bestehende Datensätze können veraltet sein

Prüfen Sie vor der Erfassung die geltenden Nutzungs- und Zugangsbedingungen der Website. Halten Sie veröffentlichte Crawling-Regeln und konfigurierte Limits ein. Das Robots Exclusion Protocol beschreibt Crawler-Direktiven, stellt aber ausdrücklich klar, dass sie kein Mechanismus zur Zugriffsautorisierung sind. Eine großzügige robots-Datei ist keine allgemeine Lizenz zum Erfassen oder Weiterverwenden von Daten. RFC 9309

Beim Web Scraping zur Lead-Generierung zählt die Qualität der Abdeckung mehr als die Zahl der Domains in der Warteschlange. Prüfen Sie Stichproben aus verschiedenen Kategorien, Regionen und Seitenvorlagen, bevor Sie sich auf eine Quelle festlegen. Ein Verzeichnis, das von bezahlten Einträgen dominiert wird, kann Ihr Account-Universum verzerren, selbst wenn jedes extrahierte Feld technisch korrekt ist.

Halten Sie Discovery und Verifizierung unabhängig voneinander austauschbar. Wenn ein Verzeichnis nicht mehr verfügbar ist, sollten Sie es ausmustern können, ohne Ihr Modell der Unternehmensidentität neu aufzubauen. Wie Sie Crawls begrenzen und Warteschlangen entwerfen, zeigt unser Leitfaden zum Web Crawling mit Python.

Ein Unternehmensschema mit angehängten Nachweisen entwerfen

Speichern Sie Fakten als Beobachtungen, bevor Sie sie zu einem Account zusammenführen. Eine Beobachtung hält fest, was eine bestimmte Quelle zu einem bestimmten Zeitpunkt angezeigt hat. Ein Account ist Ihre aktuelle Interpretation dieser Beobachtungen.

Diese Trennung verhindert einen häufigen Fehler: Eine verifizierte Leistungskategorie wird durch ein weniger verlässliches Verzeichnislabel überschrieben, nur weil das Verzeichnis später abgerufen wurde. Außerdem können Prüfer so nachvollziehen, warum sich eine Qualifizierungsentscheidung geändert hat.

Feld

Zweck

Validierungsregel

account_id

Stabile interne Identität

Intern erzeugt und nie allein aus dem Anzeigenamen abgeleitet

company_name

Lesbare Bezeichnung

Nicht leerer String mit beibehaltener Originalschreibweise

canonical_domain

Kandidat für den Abgleich

Normalisierter Hostname plus geprüfte Alias-Zuordnung

service_category

Account-Fit

Kontrolliertes Vokabular mit belegendem Nachweis

operating_region

Geografischer Fit

Einsatzgebiet getrennt von der eingetragenen Adresse

source_url

Herkunft der Beobachtung

Genaue Seite, die die Beobachtung belegt

observed_at

Erfassungszeitpunkt

UTC-Zeitstempel, vergeben von Ihrem Collector

evidence_text

Prüfbarer Beleg

Kurzer relevanter Auszug, kein vollständiger Seiten-Dump

parser_version

Reproduzierbarkeit

Version, die die Extraktionsregeln kennzeichnet

review_status

Workflow-Steuerung

Expliziter Wert wie pending, accepted oder rejected

Führen Sie source_updated_at als eigenes Feld, wenn die Seite tatsächlich ein aussagekräftiges Aktualisierungsdatum angibt. Dass Sie eine Seite heute abrufen, bedeutet nicht, dass die zugrunde liegende Information heute geschrieben wurde. Ebenso ist eine Copyright-Jahreszahl kein verlässlicher Zeitstempel für eine Aussage über eine Leistung.

Manche Websites veröffentlichen Informationen über die Organisation als strukturierte Daten. Das Organization-Vokabular von Schema.org definiert Eigenschaften wie Namen, URLs, Adressen und Kennungen. Behandeln Sie diese Felder als Extraktionskandidaten und prüfen Sie dann, ob das Markup tatsächlich die Zielorganisation beschreibt und nicht einen Herausgeber, eine Muttergesellschaft oder ein anderes Element auf der Seite.

Verwenden Sie null für fehlende Informationen. Machen Sie aus einer fehlenden Leistungskategorie nicht „bietet diese Leistung nicht an“ und aus einem fehlenden Standort nicht „außerhalb unseres Marktes“. Unbekannt und negativ sind unterschiedliche Zustände. Wer diese Unterscheidung bewahrt, macht Web Scraping zur Lead-Generierung nützlicher als eine Tabelle, die Extraktionsfehler stillschweigend in Geschäftsentscheidungen verwandelt.

Die Extraktion als begrenzte, beobachtbare Stufe aufbauen

Geben Sie jeder Quelle einen kleinen Adapter, der Beobachtungen im selben Schema zurückgibt. Halten Sie Abruf, Parsing und geschäftliche Qualifizierung getrennt. Eine Änderung am Seitenlayout sollte eine Parser-Korrektur erfordern, nicht das Neuschreiben Ihrer CRM-Integration.

Für serverseitig gerenderte Seiten sind ein HTTP-Client und ein HTML-Parser meist ein vernünftiger Ausgangspunkt. Setzen Sie einen Browser nur ein, wenn die benötigten Inhalte tatsächlich von der Ausführung der Seite oder von Interaktion abhängen. Der Vergleich von Scrapy und Beautiful Soup hilft, ein Crawl-Framework von einer Parsing-Bibliothek zu unterscheiden, und der Leitfaden zu Python-HTTP-Clients behandelt die Request-Ebene.

Setzen Sie jedem Erfassungsjob Grenzen: freigegebene Hosts, maximale Seitenzahl, Request-Timeout, Antwortgröße, Parallelität pro Host und begrenzte Wiederholungsversuche. Ein Crawler, der jedem gefundenen Link folgt, driftet auf irrelevante Seiten ab und vervielfacht sowohl die Kosten als auch den Prüfaufwand.

Behandeln Sie Fehler als klassifizierte Ergebnisse. Rate Limiting sollte die Erfassung verlangsamen oder pausieren. Eine Forbidden-Antwort sollte eine Überprüfung der Quelle auslösen, keinen endlosen Versuch, die Beschränkung zu umgehen. Eine erfolgreiche Antwort ohne die erwarteten Felder gehört in eine Warteschlange zur Parser-Analyse, statt zu einem leeren Unternehmensdatensatz zu werden.

Die AutoThrottle-Erweiterung von Scrapy passt Download-Verzögerungen anhand der Antwortlatenz an und hält dabei die konfigurierten Einstellungen für Parallelität und Verzögerung ein. Sie ist eine nützliche Planungskomponente, doch quellenspezifische Zugriffsentscheidungen und betriebliche Limits brauchen Sie trotzdem.

Erfassen Sie Seitenabrufe, erfolgreiches Parsing, die Abdeckung der Pflichtfelder und die Annahme nach Prüfung getrennt. Eine HTTP-Erfolgsquote kann gesund aussehen, während eine überarbeitete Vorlage stillschweigend jedes nützliche Feld entfernt. Für einen Collector von Lead-Daten sagt „der Job ist fertig“ weniger aus als „die erwarteten Account-Nachweise haben die Validierung überstanden“.

Normalisieren und Dubletten bereinigen, ohne verschiedene Unternehmen zusammenzuführen

Normalisieren Sie Leerzeichen und offensichtliche URL-Varianten, bevor Sie Datensätze abgleichen. Behalten Sie die Originalwerte, damit ein Prüfer sehen kann, was sich geändert hat. Kürzen Sie Firmennamen nicht so aggressiv um Wörter, dass sich verschiedene Unternehmen nicht mehr unterscheiden lassen.

Das folgende Python-Beispiel arbeitet ausschließlich mit synthetischen Beobachtungen. Es normalisiert Hostnamen und gruppiert Datensätze zur Prüfung. Es ruft keine Websites ab, löst keine juristischen Personen auf und genehmigt keine Zusammenführungen im CRM.

from collections import defaultdict
from urllib.parse import urlsplit


def domain_key(value):
    value = value.strip()
    candidate = value if "://" in value else "https://" + value
    parts = urlsplit(candidate)
    if parts.scheme not in {"http", "https"} or not parts.hostname:
        raise ValueError("Expected a company HTTP(S) website")
    if parts.username or parts.password or any(c.isspace() for c in value):
        raise ValueError("Credentials and whitespace are not accepted")
    _ = parts.port  # Reject malformed or out-of-range ports.
    host = parts.hostname.rstrip(".").encode("idna").decode("ascii").lower()
    return host.removeprefix("www.")


observations = [
    {"name": "Example Tools", "website": "https://www.example.com/about",
     "source_url": "https://directory.example/companies/one"},
    {"name": "Example Tools Ltd", "website": "example.com/",
     "source_url": "https://example.com/services"},
    {"name": "Example Regional", "website": "regional.example.com",
     "source_url": "https://regional.example.com/about"},
]

groups = defaultdict(list)
for observation in observations:
    groups[domain_key(observation["website"])].append(dict(observation))

assert len(groups["example.com"]) == 2
assert len(groups["regional.example.com"]) == 1
assert domain_key("https://EXAMPLE.com:443/") == "example.com"
print({key: len(rows) for key, rows in sorted(groups.items())})

Die Ausgabe enthält zwei Kandidatengruppen: example.com mit zwei Beobachtungen und regional.example.com mit einer. Dass die Subdomain erhalten bleibt, ist beabsichtigt. Gehen Sie nie davon aus, dass die letzten beiden Labels eines Hostnamens ein Unternehmen identifizieren: Öffentliche Suffixe und Shared Hosting machen diese Abkürzung unzuverlässig.

Die Python-Dokumentation zum URL-Parsing weist darauf hin, dass die Parsing-Funktionen URLs nicht validieren. Die Prüfungen hier dienen nur dazu, einen begrenzten Abgleich zu demonstrieren. Sie sind keine Maßnahmen zur Netzwerksicherheit. Ein Fetcher in der Produktion muss Ziele und Weiterleitungen separat validieren, bevor er Requests sendet.

Domain-Übereinstimmungen sind nützliche Nachweise, aber keine perfekte Identität. Verschiedene Tochtergesellschaften können sich eine Domain teilen, und eine Organisation kann mehrere Marken und Länderdomains haben. Leiten Sie mehrdeutige Fälle mit den Kandidaten-Account-IDs und den Abgleichsgründen in eine Prüfwarteschlange. Nur eine akzeptierte Zuordnung sollte Ihre Alias-Tabelle aktualisieren.

Diese Unterscheidung ist zentral für verlässliches Web Scraping zur Lead-Generierung: Die Dublettenbereinigung soll doppelte Accounts reduzieren, ohne die Nachweise zu löschen, die einen Konflikt sichtbar gemacht haben.

Accounts qualifizieren und sicher an das CRM übergeben

Beginnen Sie mit erklärbaren Qualifizierungsregeln. Ein Account kann ein Leistungskriterium erfüllen, an einer geografischen Anforderung scheitern oder mangels Nachweisen ungeklärt bleiben. Speichern Sie diese Einzelergebnisse, bevor Sie eine Gesamtpriorität berechnen.

Verwenden Sie für einen ersten Pilotbetrieb Kategorien wie „bereit zur Account-Prüfung“, „Nachweise fehlen“ und „ausgeschlossen“. Diese Labels lassen sich leichter auditieren als ein Score, der Unbekanntes und negative Signale zu einer undurchsichtigen Zahl verrechnet. Wenn Sie später Gewichtungen hinzufügen, versionieren Sie das Regelwerk und bewahren Sie die Gründe auf, die zu jedem Ergebnis beigetragen haben.

Ziehen Sie eine klare Grenze zum CRM. Freigegebene Datensätze können zu Einträgen für die Account-Recherche werden. Sie sollten aber nicht automatisch Outreach auslösen, nur weil der Import erfolgreich war. Halten Sie die Entscheidung über die Kontaktberechtigung aus Ihrem Scraping-Job heraus.

Die Dokumentation der Companies-API von HubSpot empfiehlt, eine Unternehmensdomain mitzugeben, um Dubletten zu vermeiden, und dokumentiert das Aktualisieren von Unternehmensdatensätzen per ID. Welches CRM Sie auch nutzen: Speichern Sie die zurückgegebene Kennung und definieren Sie ein explizites Abgleichsverhalten, bevor Sie einen zweiten Batch senden.

Führen Sie ein Export-Ledger mit Ihrer Account-ID, der ID des Zieldatensatzes, der Payload-Version und dem zuletzt bestätigten Ergebnis. Gleichen Sie bei einem erneuten Versuch zuerst den vorherigen Versuch ab, bevor Sie einen weiteren Datensatz anlegen. Gehen Sie nicht davon aus, dass ein Domain-Feld jeden API-Schreibvorgang automatisch idempotent macht.

Beschränken Sie Aktualisierungen auf Felder, für die der Collector zuständig ist. Ein verifizierter Account-Owner, ein ausgehandelter Beziehungsstatus oder ein manuell korrigierter Firmenname sollten nicht verschwinden, nur weil ein Crawler eine neue Vermutung geliefert hat. Nutzen Sie eine prüfbare Richtlinie für die Feldpriorität und halten Sie erfolgreiche Exporte getrennt von ausstehenden Wiederholungen.

Messen Sie Web Scraping zur Lead-Generierung an dieser Grenze: akzeptierte eindeutige Accounts, abgelehnte Zuordnungen, fehlende Nachweise und Kosten pro akzeptiertem Account. Rohe Zeilen pro Minute belohnen Dubletten. Eine nützliche Pipeline belohnt Datensätze, denen Ihr Team tatsächlich vertrauen kann.

Entscheidungen zu Erfassung, Datenschutz und Outreach getrennt halten

Erfassen Sie nur die geschäftlichen Merkmale, die für den angegebenen Zweck der Account-Recherche nötig sind. Targeting auf Unternehmensebene erfordert in der Regel keine privaten Mobilnummern, keine individuellen Verhaltensverläufe und keine sensiblen persönlichen Merkmale. Fügen Sie solche Felder nicht nur deshalb hinzu, weil eine Seite sie anzeigt.

Ein geschäftlicher Kontext hebt Datenschutzpflichten nicht automatisch auf. Das britische Information Commissioner's Office (ICO) erläutert, dass die UK GDPR auf personenbezogene Daten im B2B-Marketing anwendbar sein kann, auch auf öffentlich verfügbare Informationen. Seine Leitlinien unterscheiden nach den Regeln für elektronisches Marketing zudem zwischen Unternehmensteilnehmern einerseits und Einzelunternehmern sowie bestimmten Personengesellschaften andererseits. Die Seite wird nach Gesetzesänderungen überarbeitet. Prüfen Sie daher den aktuellen Wortlaut, bevor Sie einen Workflow für Großbritannien freigeben. ICO-Leitlinien zum B2B-Marketing

In den USA erklärt die FTC, dass CAN-SPAM kommerzielle E-Mails abdeckt und B2B-Nachrichten nicht ausnimmt. Ihre Leitlinien behandeln die Absenderkennzeichnung, Betreffzeilen, Postanschriften und den Umgang mit Abmeldungen. Diese Anforderungen betreffen den Nachrichtenversand. Sie erlauben weder das Scraping einer Website, noch belegen sie die Rechtskonformität in einer anderen Rechtsordnung. Compliance-Leitfaden der FTC

Übersetzen Sie die geltende Richtlinie in betriebliche Felder: freigegebener Zweck, Aufbewahrungsregel, Zugriffsbeschränkungen, Sperrstatus und verantwortliche Prüfperson. Lassen Sie das zuständige Datenschutz- oder Rechtsteam entscheiden, was für die tatsächlich betroffenen Rechtsordnungen und Kanäle angemessen ist.

Machen Sie Sperren über erneute Läufe hinweg dauerhaft. Wenn ein Account oder Kontakt ausgeschlossen werden muss, darf seine erneute Entdeckung auf einer anderen Website ihn nicht stillschweigend wieder aktivieren. Wenden Sie dieselbe Regel auf nachgelagerte Exporte und wiederhergestellte Backups an. Web Scraping zur Lead-Generierung ist ein Erfassungsprozess und kein Ersatz für die Entscheidung, wie die gewonnenen Daten verwendet werden dürfen.

Die wichtigsten Punkte

  • Definieren Sie die Account-Kriterien und die erforderlichen Nachweise, bevor Sie den Crawler bauen.
  • Halten Sie Quellbeobachtungen getrennt von normalisierten Accounts und Qualifizierungsentscheidungen.
  • Behandeln Sie Domain-Übereinstimmungen als Kandidaten und prüfen Sie geteilte Domains und mehrere Marken.
  • Gleichen Sie CRM-Wiederholungen ab und schützen Sie manuell gepflegte Felder vor automatischem Überschreiben.
  • Führen Sie Erfassungsberechtigung, Account-Fit und Outreach-Berechtigung als getrennte Entscheidungen.

FAQ

Sollte ein gescrapter Unternehmensdatensatz automatisch zu einer Verkaufschance werden?

Nein. Legen Sie zuerst einen Datensatz für die Account-Recherche an und überlassen Sie Ihrem Vertriebsprozess die Entscheidung, ob eine Verkaufschance besteht. Eine Website kann relevante Leistungen oder Standorte zeigen, ohne ein aktives Kaufprojekt erkennen zu lassen. Die Trennung von Recherche-Accounts und Verkaufschancen macht zudem das Pipeline-Reporting aussagekräftiger und verhindert, dass Ihr CRM jedes entdeckte Unternehmen als potenziellen Umsatz behandelt.

Kann ein Sprachmodell Leistungsbeschreibungen von Unternehmen klassifizieren?

Ja, als geprüfter Klassifizierungsschritt mit fester Taxonomie und Quellennachweisen. Verlangen Sie, dass die Ausgabe den belegenden Text benennt, und lassen Sie ein Ergebnis „unbekannt“ zu. Behandeln Sie Webseiteninhalte als nicht vertrauenswürdige Daten, nicht als Anweisungen an das Modell. Evaluieren Sie den Klassifikator anhand von Beispielen, die Menschen gelabelt haben, bevor Sie seine Ausgabe zur Priorisierung von Accounts nutzen, und halten Sie modellgenerierte Schlussfolgerungen getrennt von beobachteten Fakten.

Wie sollten sich Übernahmemeldungen auf bestehende Account-Datensätze auswirken?

Leiten Sie sie in einen Workflow zur Prüfung von Entitäten, statt Datensätze automatisch zusammenzuführen. Eine Übernahme kann die Eigentumsverhältnisse ändern, ohne sofort Marken, Websites, operative Gesellschaften oder CRM-Beziehungen zu ändern. Erfassen Sie die Meldung als datierte Beobachtung und lassen Sie dann eine verantwortliche Person entscheiden, welche Account-Beziehungen und Aliase aktualisiert werden müssen. Bewahren Sie historische Kennungen auf, damit frühere Exporte und Entscheidungen nachvollziehbar bleiben.

Fazit

Das wertvollste Ergebnis von Web Scraping zur Lead-Generierung ist ein belastbarer Account-Datensatz. Er hat eine aufgelöste Identität, nützliche geschäftliche Merkmale, eine klare Quellenspur und eine Qualifizierungsentscheidung, die jemand anderes nachprüfen kann. Die Zahl der abgerufenen Seiten ist nur eine unterstützende Kennzahl.

Beginnen Sie mit einer freigegebenen Quelle, einer engen Account-Definition und einem kleinen Batch, den die Prüfer vollständig durchsehen können. Korrigieren Sie falsche Zuordnungen und fehlende Nachweise, bevor Sie das Crawl-Volumen erhöhen. Ergänzen Sie danach geplante Aktualisierungen, geprüfte Aliase und den CRM-Abgleich, ohne die Bedeutung Ihrer Kernfelder zu ändern.

Halten Sie neben dem Collector eine kurze Betriebs-Checkliste bereit: Quelle freigegeben, Beobachtung gültig, Account zugeordnet, Ausschlüsse geprüft, Export bestätigt. Wenn etwas fehlschlägt, stoppen Sie es in der betreffenden Stufe, statt Unsicherheit bis ins CRM durchsickern zu lassen.

Wenn die Pflege der Abrufebene Zeit kostet, die Ihnen für die Account-Qualität fehlt, prüfen Sie die Scraper API von WebScrapingAPI, um Seiten innerhalb Ihres freigegebenen Erfassungsumfangs abzurufen. Ihr Schema, Ihre Nachweisprüfungen und Ihre Qualifizierungsregeln sollten unter Ihrer Kontrolle bleiben, unabhängig davon, wie das HTML zum Parser gelangt.

Über den Autor

Robert Munceanu, Full-Stack-Entwickler @ WebScrapingAPI

Robert Munceanu

Full-Stack-Entwickler

Robert Munceanu ist Full-Stack-Entwickler bei WebScrapingAPI, wo er in allen Bereichen des Produkts mitwirkt und an der Entwicklung zuverlässiger Tools und Funktionen zur Unterstützung der Plattform mitwirkt.

Alternatives Data Scraping für das Finanzwesen: Wie Webdaten Anlegern einen Vorteil verschaffen
Anwendungsfälle

Alternatives Data Scraping für das Finanzwesen: Wie Webdaten Anlegern einen Vorteil verschaffen

TL;DR: Alternatives Data Scraping nutzt Web-Sammeltechniken, um nicht-traditionelle Datensätze (Produktpreise, Stimmungen, Stellenausschreibungen, behördliche Einreichungen) zu sammeln, die Marktsignale offenbaren, bevor sie in Gewinnberichten erscheinen. Dieser Leitfaden führt Sie durch die wertvollsten Datenquellen, den Aufbau von Pipelines für die Finanzbranche, die Validierung der Datenqualität und die Compliance-Leitplanken, die Sie benötigen, um auf der richtigen Seite des Gesetzes zu bleiben.

Mihnea-Octavian Manolache15 min read
Artikel lesen
Was sind Finanzdaten? Arten, Erhebungsmethoden und Analysewerkzeuge
Anwendungsfälle

Was sind Finanzdaten? Arten, Erhebungsmethoden und Analysewerkzeuge

TL;DR: Finanzdaten sind die Sammlung von quantitativen Aufzeichnungen (Einnahmen, Ausgaben, Vermögenswerte, Verbindlichkeiten, Cashflow), die Organisationen und Einzelpersonen nutzen, um fundierte wirtschaftliche Entscheidungen zu treffen. Dieser Leitfaden schlüsselt die vier wichtigsten Finanzdaten auf, vergleicht traditionelle und alternative Datenquellen, geht auf moderne Erhebungsmethoden ein und behandelt die Instrumente, die Fachleute für die Analyse verwenden.

Suciu Dan12 min read
Artikel lesen
XPath vs. CSS-Selektoren: Die Wahl des richtigen Selektors
Anwendungsfälle

XPath vs. CSS-Selektoren: Die Wahl des richtigen Selektors

TL;DR: XPath- und CSS-Selektoren lokalisieren beide DOM-Elemente, aber sie lösen unterschiedliche Probleme. CSS-Selektoren sind schneller und besser lesbar für einfache Auswahlen. XPath gewinnt, wenn Sie das DOM in beliebiger Richtung durchlaufen, Textinhalte abgleichen oder komplexe bedingte Logik verarbeiten müssen. Die meisten Produktionsprojekte profitieren vom strategischen Einsatz beider Methoden.

Mihai Maxim13 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.