Zum Inhalt springen

Blog

Einblicke & Technik

Ein tiefer Einblick in die Infrastruktur von Webdaten, Extraktionstechniken und die Zukunft strukturierter Daten in großem Maßstab.

Neueste Artikel

156 Artikel

Web-Scraping mit C und C++ unter Verwendung von libcurl und lexbor
Anleitungen

Web-Scraping mit C und C++ unter Verwendung von libcurl und lexbor

TL;DR: Webseiten in C und C++ mit libcurl und lexbor auslesen: Erstellen Sie einen „höflichen“ C++20-Crawler mit CMake und vcpkg, exportieren Sie saubere CSV- und JSON-Dateien, verarbeiten Sie JavaScript-Seiten auf drei verschiedene Arten und führen Sie denselben Scraper in reinem C aus.

Raluca Penciuc25 min read
Artikel lesen
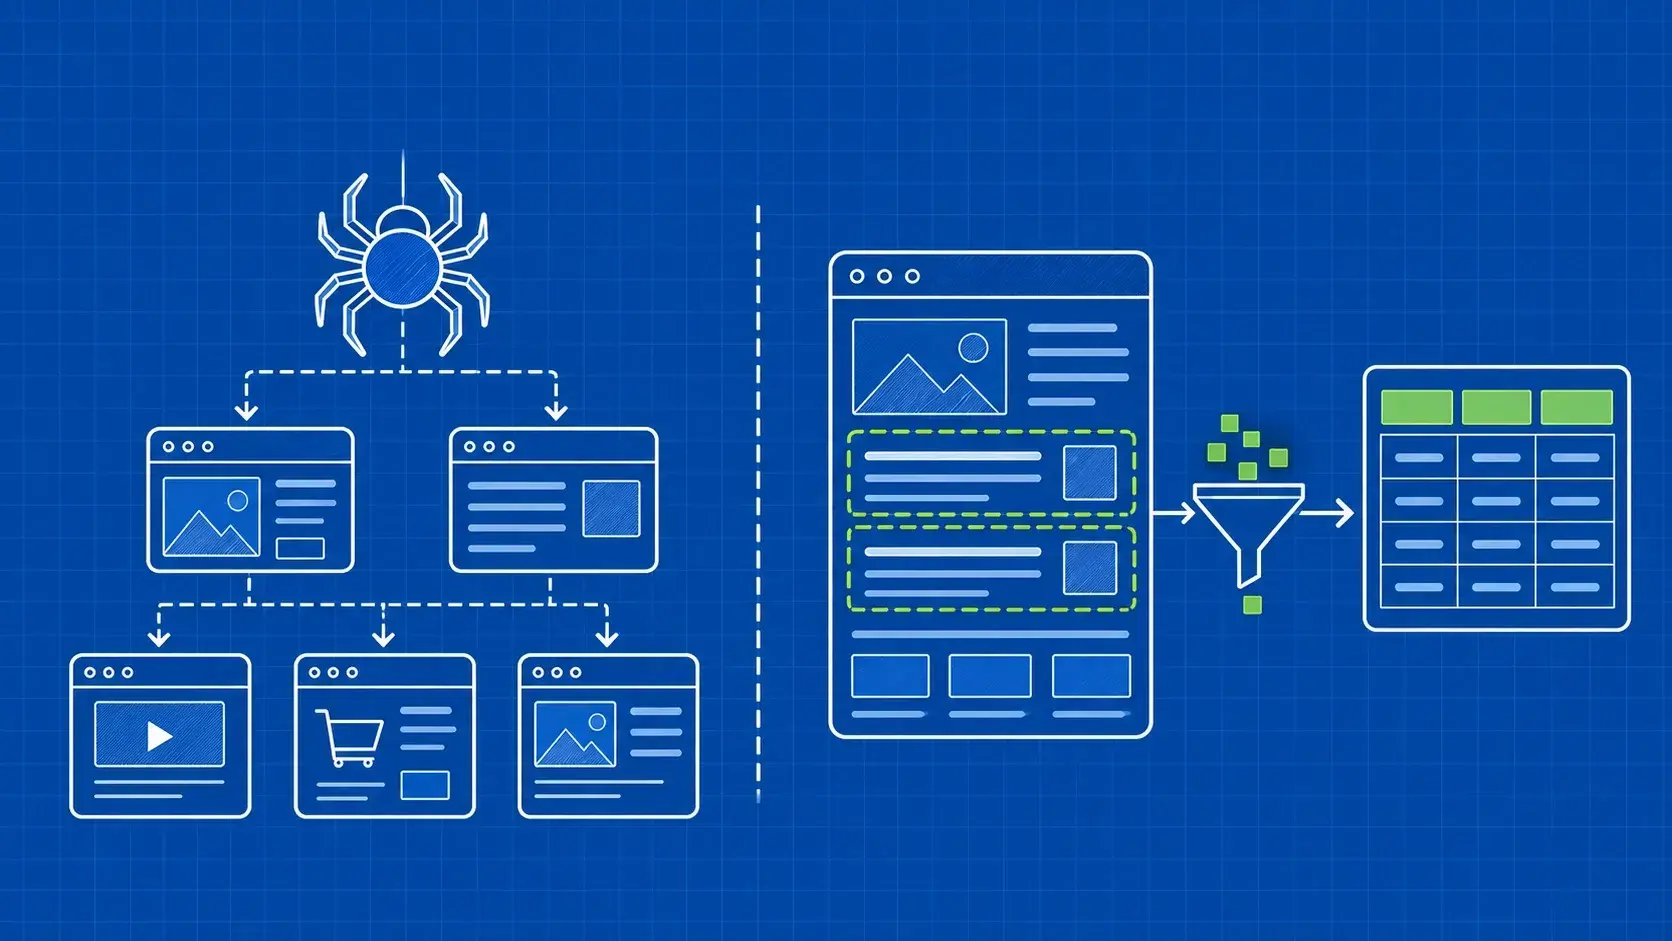
Web-Scraping vs. Web-Crawling: Ein Leitfaden für Einsteiger
Die Wissenschaft des Web-Scrapings

Web-Scraping vs. Web-Crawling: Ein Leitfaden für Einsteiger

TL;DR: Erfahren Sie, wie Crawler Seiten finden und Scraper nützliche Daten extrahieren. Sehen Sie sich ein Beispiel mit einer Buchhandlung an, vergleichen Sie die Ergebnisse und wählen Sie den passenden Arbeitsablauf für Ihr erstes Projekt aus.

Anda Miuțescu12 min read
Artikel lesen
Die besten Mobile Proxies für Web Scraping 2026: 9 Anbieter im Ranking
Die Wissenschaft des Web-Scrapings

Die besten Mobile Proxies für Web Scraping 2026: 9 Anbieter im Ranking

TL;DR: 9 Mobile-Proxy-Anbieter für Scraping im Vergleich: Preis pro GB oder Port, Carrier- und ASN-Targeting, 5G, Sticky Sessions und Testphasen, Stand Oktober 2026.

Sergiu Inizian23 min read
Artikel lesen
Best Practices für Web-Scraping: Ein Leitfaden für den gesamten Lebenszyklus mit Tipps und funktionierendem Code
Die Wissenschaft des Web-Scrapings

Best Practices für Web-Scraping: Ein Leitfaden für den gesamten Lebenszyklus mit Tipps und funktionierendem Code

TL;DR: Bewährte Vorgehensweisen beim Web-Scraping für jede Phase des Scraper-Lebenszyklus: Planen Sie die Daten, halten Sie sich an die „robots.txt“-Datei gemäß der Definition in RFC 9309, legen Sie für jeden Host ein angemessenes Tempo fest und beachten Sie den „Retry-After“-Header, führen Sie eine defensive Datenauswertung durch, validieren Sie jeden Datensatz, überwachen Sie die Läufe, überprüfen Sie den Fortschritt und erfassen Sie die Kosten pro gültigem Datensatz. Zu jeder Phase gibt es ein kurzes, funktionsfähiges Python-Snippet.

Anda Miuțescu30 min read
Artikel lesen
Web-Scraping für SEO: Erstellen Sie ein evidenzbasiertes Audit
Anwendungsfälle

Web-Scraping für SEO: Erstellen Sie ein evidenzbasiertes Audit

TL;DR: Erstellen Sie ein fundiertes SEO-Audit, bei dem die auf der Seite festgestellten Fakten von den Suchmaschinenergebnissen getrennt werden. Vergleichen Sie Darstellungsweise, kanonische Signale, Anweisungen und Fehler in den Vorlagen.

Gabriel Cioci14 min read
Artikel lesen
REST-API-Tipps für eine zuverlässige Datenerfassung
Technik

REST-API-Tipps für eine zuverlässige Datenerfassung

TL;DR: Entwickeln Sie APIs, die von Collectors zuverlässig genutzt werden können. Definieren Sie Paginierung, Wiederholungsversuche, Validatoren, Authentifizierung, Schemaentwicklung und Wiederherstellung als explizite Verträge.

Robert Sfichi15 min read
Artikel lesen

Los geht’s

Sind Sie bereit, Ihre Datenerfassung zu erweitern?

Schließen Sie sich den über 2.000 Unternehmen an, die WebScrapingAPI nutzen, um Webdaten im Unternehmensmaßstab ohne zusätzlichen Infrastrukturaufwand zu extrahieren.